Esta é uma submissão para o Hacktoberfest Open-Source AI Challenge Week 3: Slow and Steady
Versão em português, complementar ao post em inglês (o texto em inglês é a submissão principal).
O que eu construí
Seja preguiçoso ao ler. Seja cuidadoso ao aprovar.
Revisão de acessos é a tarefa que todo mundo adia. Alguém entrega uma lista longa de quem pode fazer o quê, e escondida nela há uma pergunta: quais pares de permissões nunca deveriam estar na mesma pessoa? Quem trabalha com segurança chama isso de segregação de funções (SoD). Um usuário que pode cadastrar um fornecedor e também liberar pagamentos para esse fornecedor é o exemplo de livro-texto.
O SlothGuard faz a parte maçante e reserva o humano para a única decisão que importa.
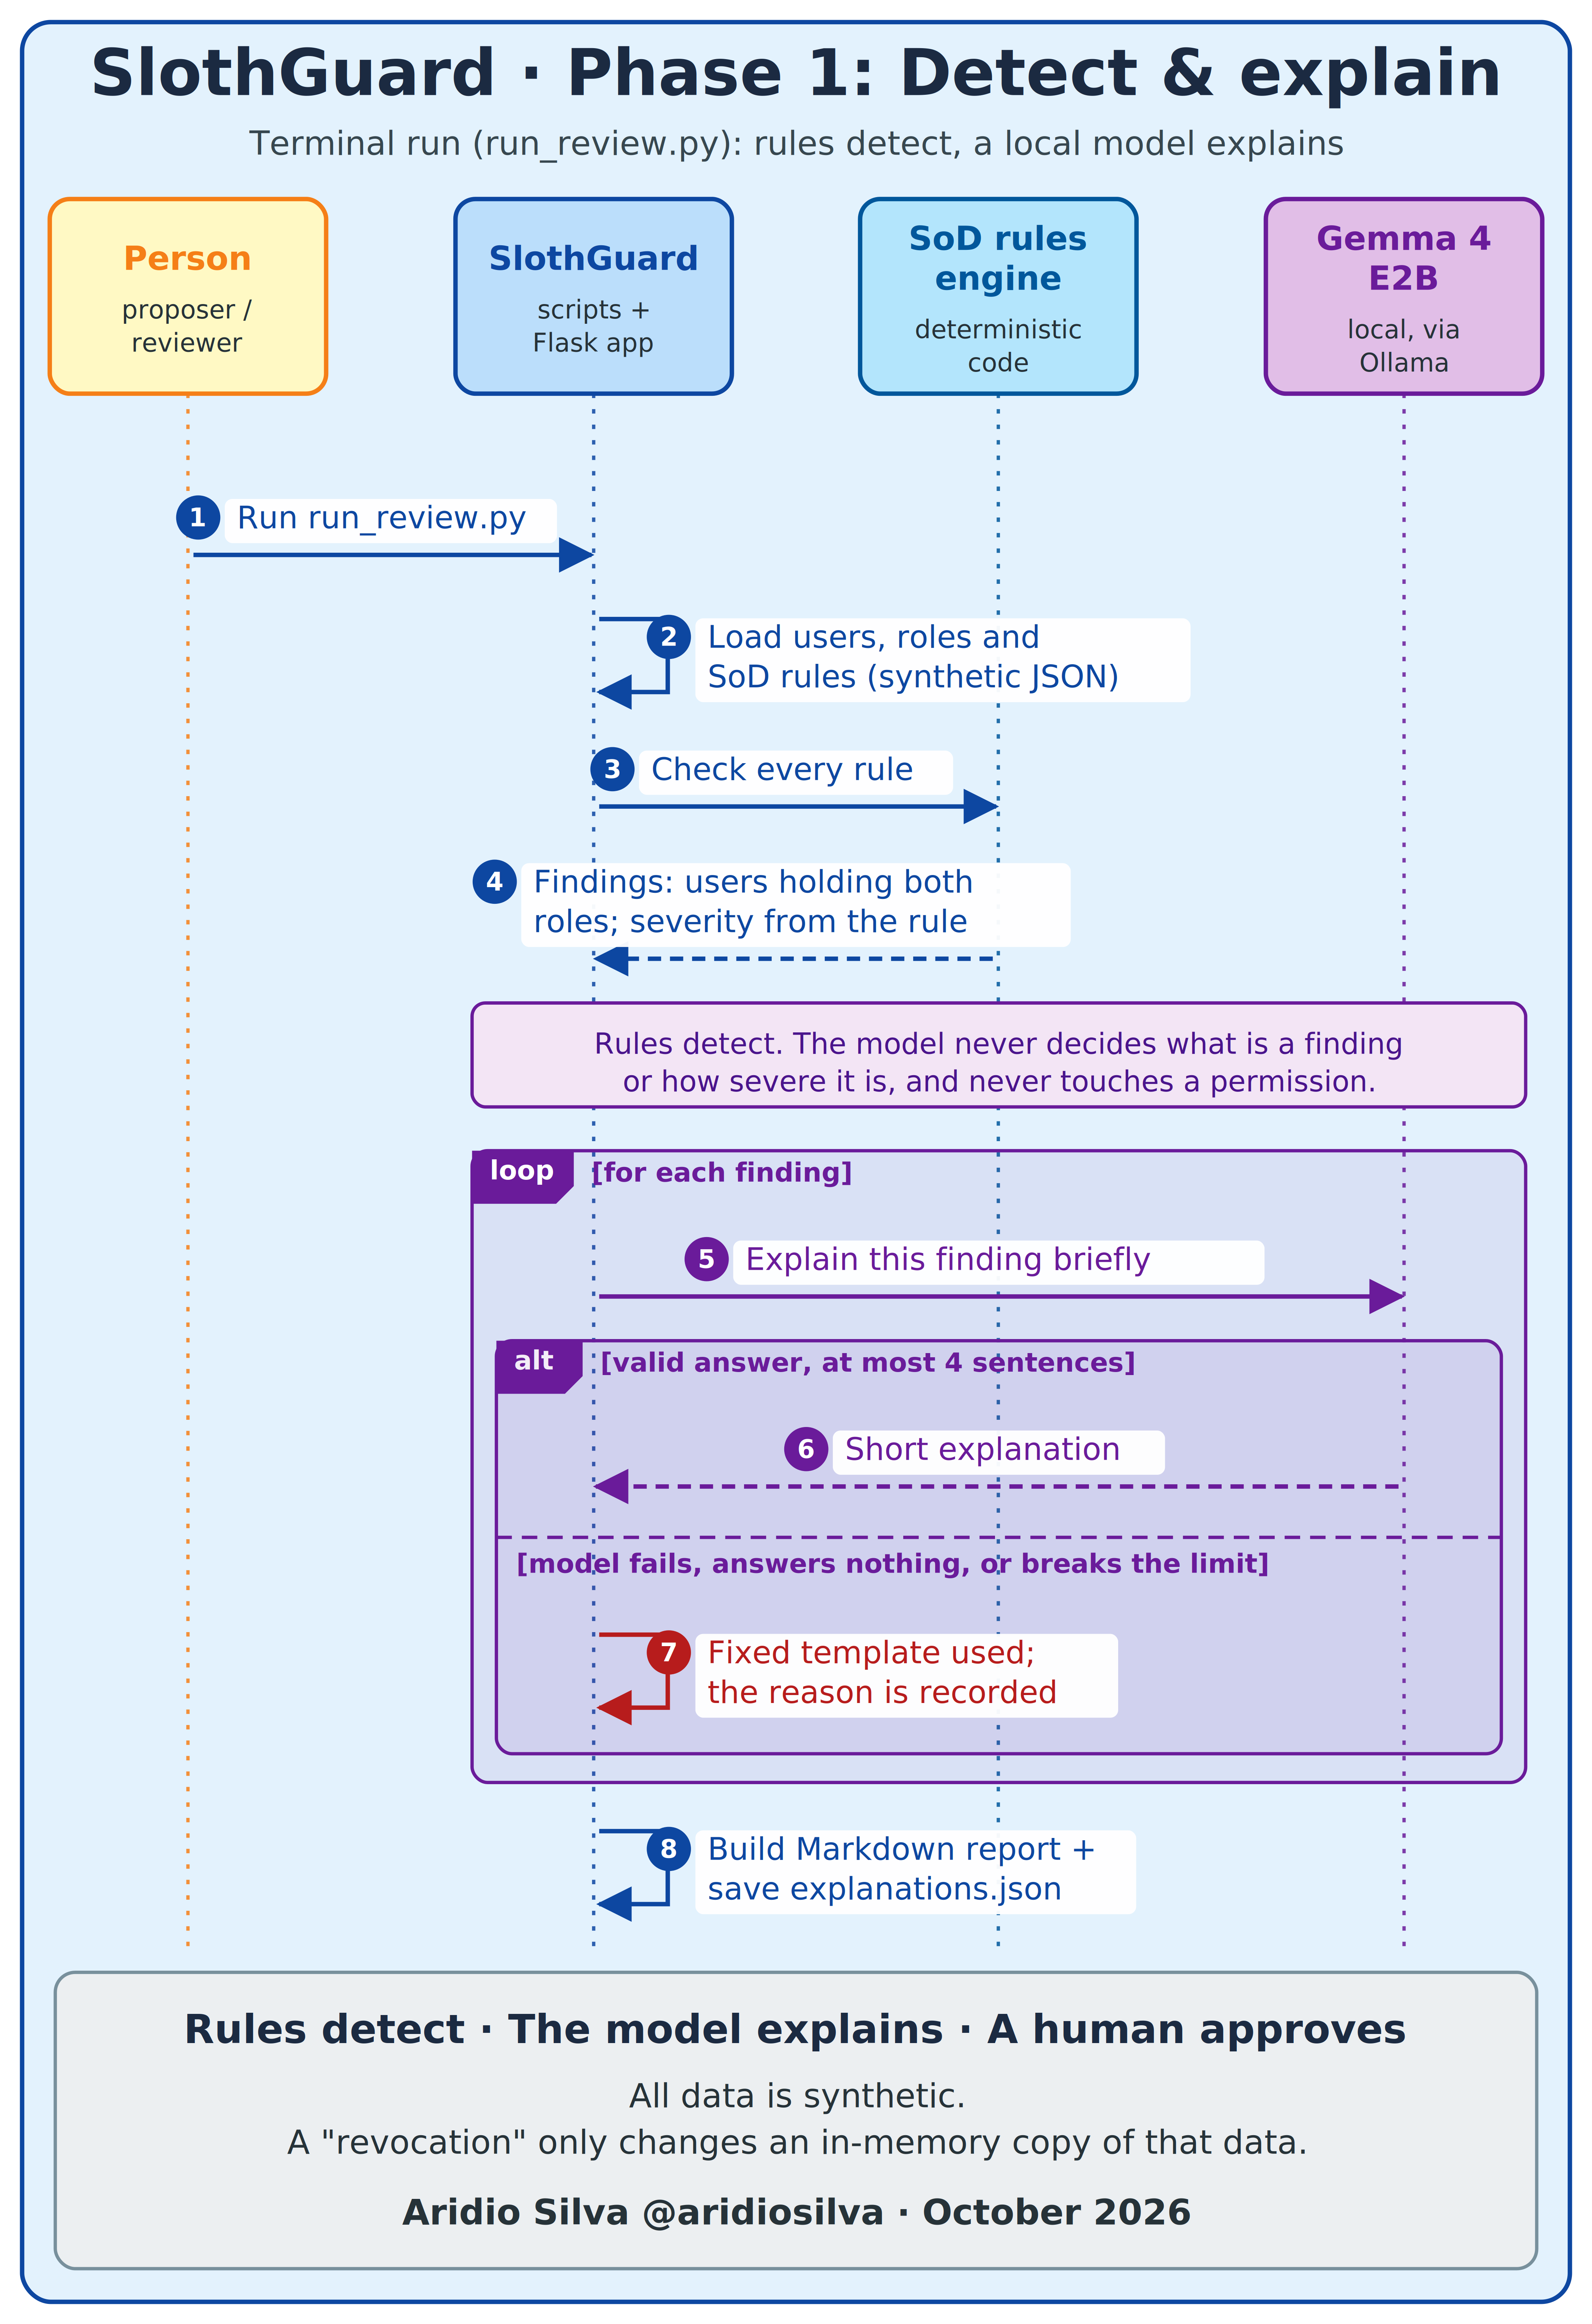
- Regras detectam. Regras determinísticas verificam 40 usuários sintéticos contra 9 regras de SoD e encontram 8 conflitos (5 altos, 2 médios, 1 baixo).
- Um modelo local explica. O Gemma 4 E2B, um modelo de pesos abertos rodando no meu próprio PC via Ollama, escreve uma explicação curta para cada achado. O código limita o texto a 4 frases e usa um texto-padrão de reserva se o modelo falhar.
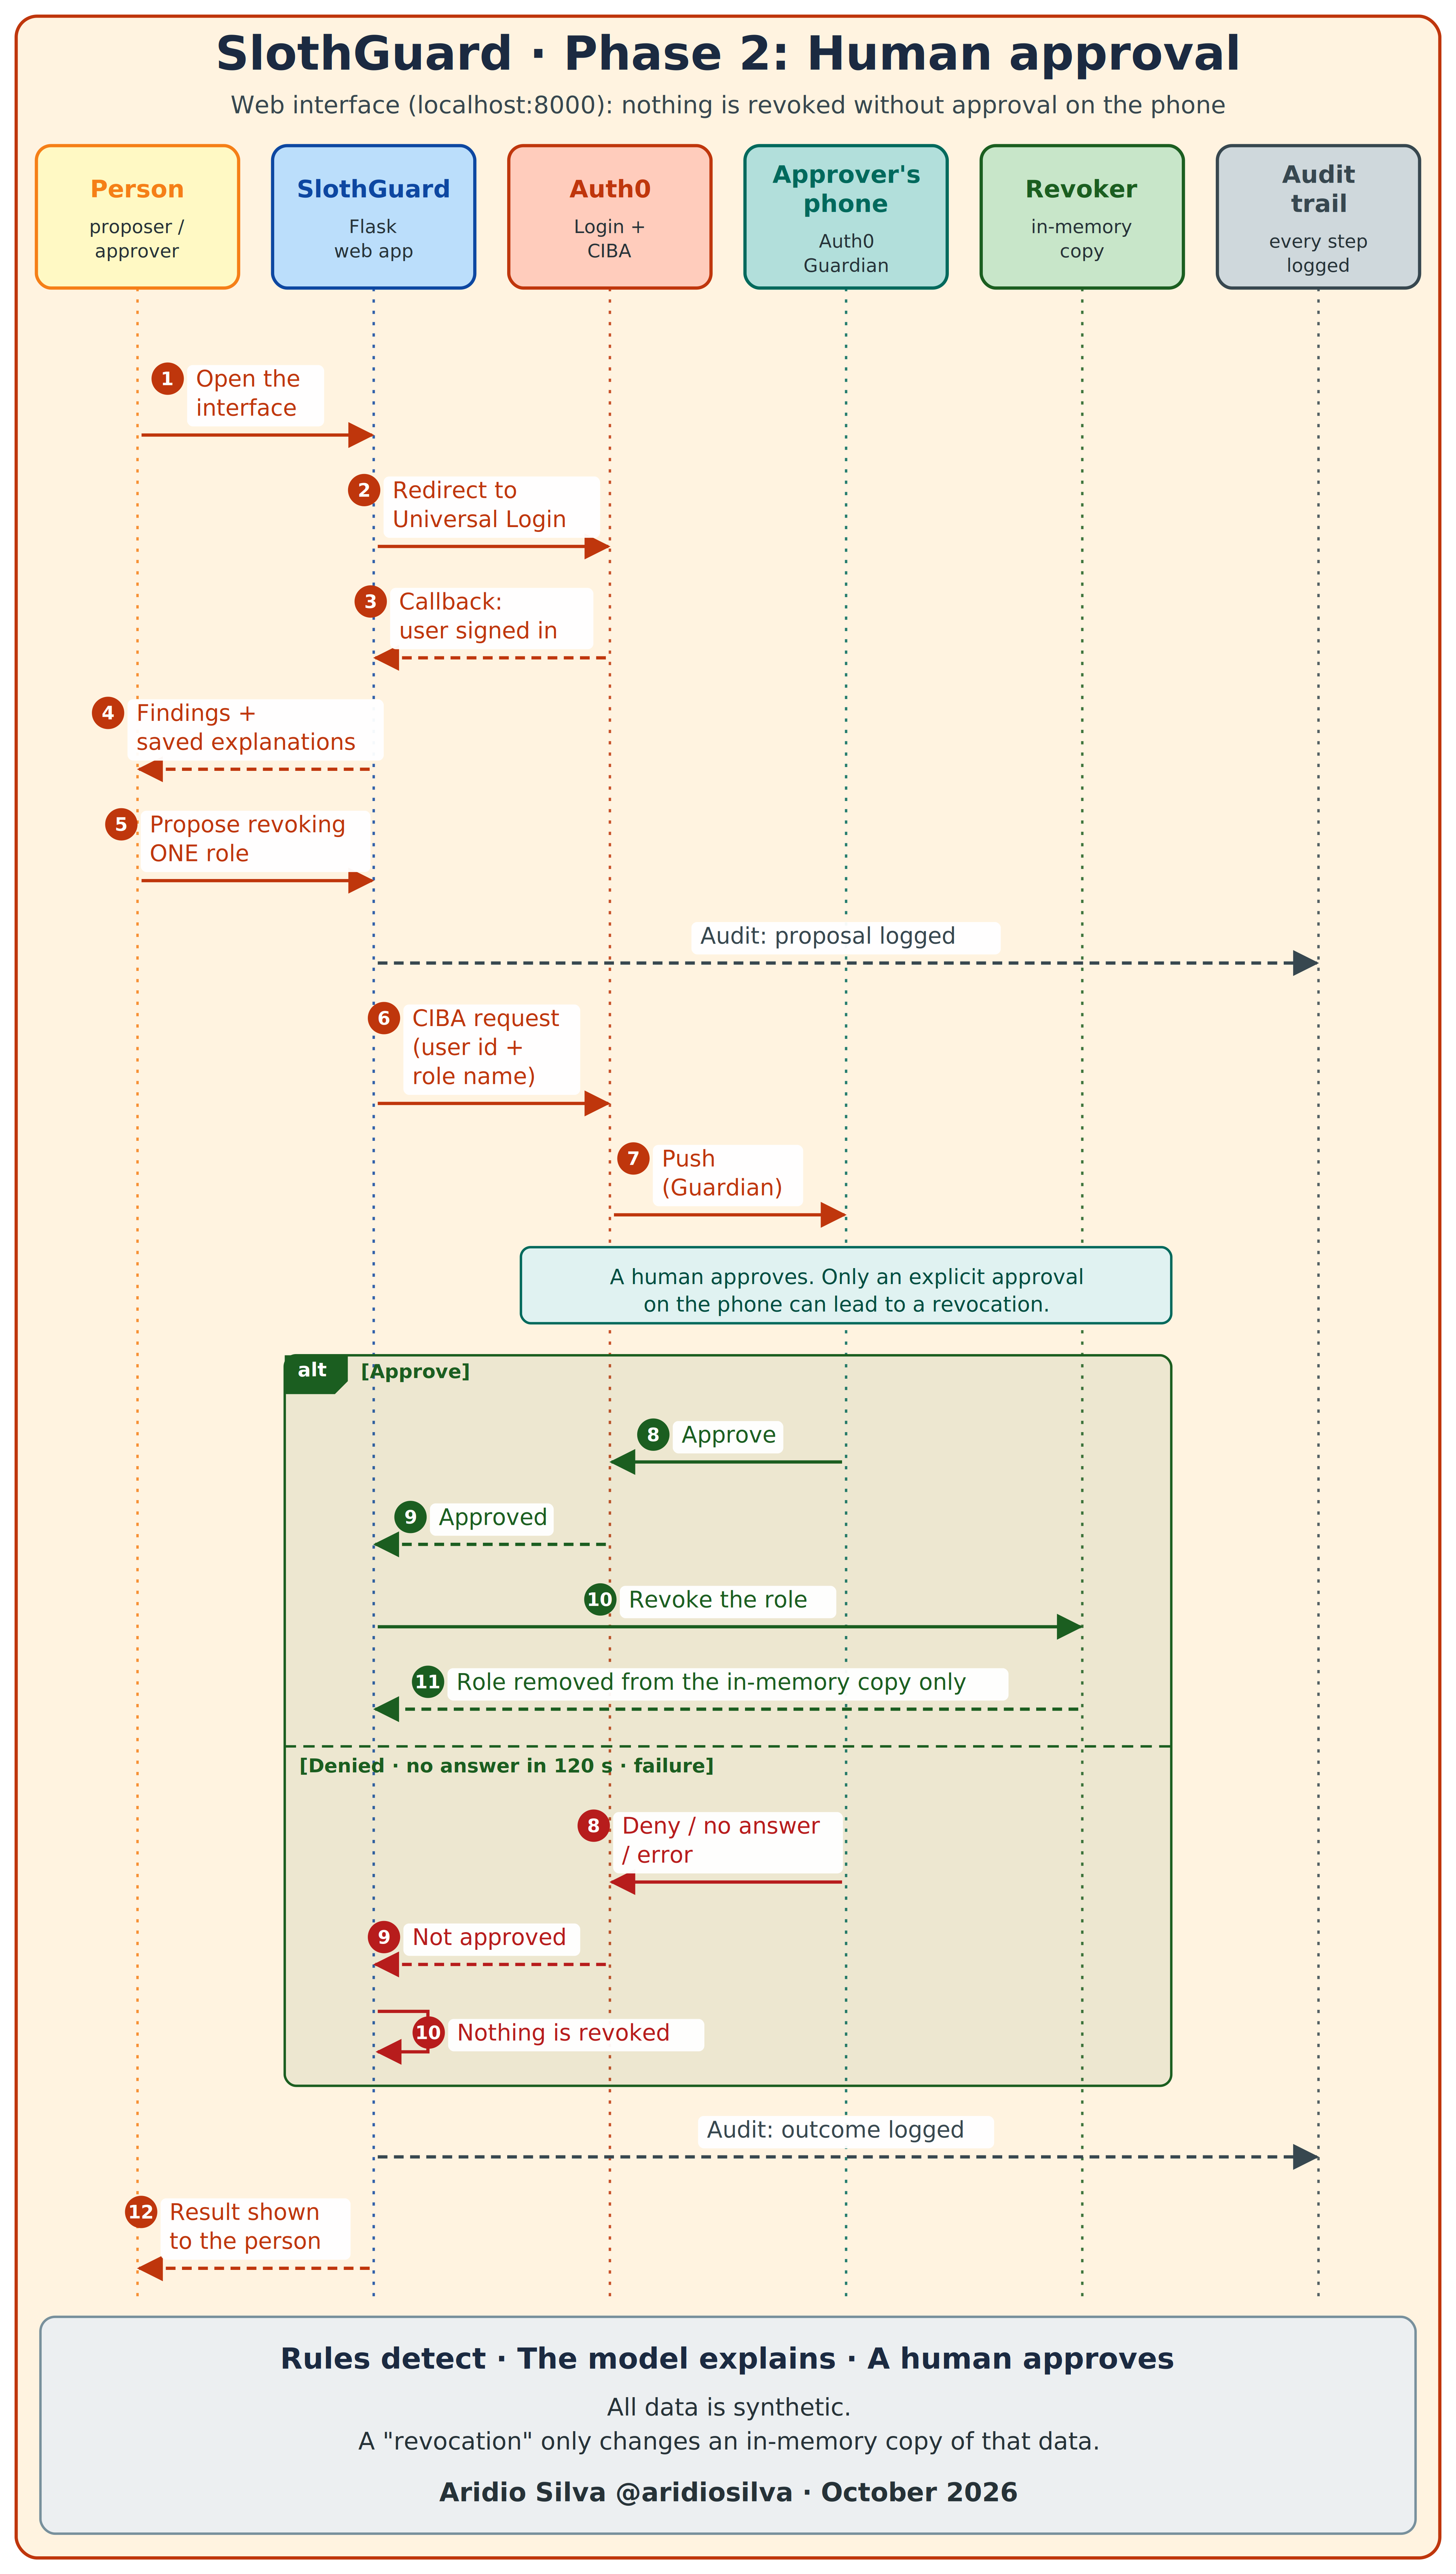
- Uma pessoa aprova. Para revogar um papel, o app pede aprovação no celular pelo Auth0 (Universal Login, CIBA, Guardian). Aprovar, negar ou não responder: os três desfechos estão no vídeo.
Uma regra sustenta todo o projeto: o modelo nunca decide achados nem severidade, e nunca toca em uma permissão. Ele só explica. Os dados são sintéticos, e uma "revogação" altera uma cópia mantida em memória.
Demo
Demo completa, com legendas em inglês gravadas no vídeo (7 min 55 s): https://youtu.be/9JlqE3jBITk. A aprovação no celular começa em 4:14.
A Fase 1 transformou 40 usuários sintéticos e 9 regras em 8 achados, cada um explicado pelo Gemma. Regra, usuário e papéis vêm dos dados, a severidade vem da regra, e a última coluna é o tempo que o modelo levou na execução de 23/10 (97,1 s no total, docs/evidence/review-run.md):
| Regra | Usuário | Papéis em conflito | Severidade (da regra) | Tempo da explicação |
|---|---|---|---|---|
| SOD-001 | U001 | Vendor_Master_Maintain + Payment_Release | Alta | 23,9 s * |
| SOD-002 | U002 | Purchase_Requester + Purchase_Approver | Alta | 10,6 s |
| SOD-003 | U003 | Journal_Entry_Create + Journal_Entry_Approve | Alta | 10,4 s |
| SOD-006 | U004 | User_Admin + Audit_Log_Admin | Alta | 11,5 s |
| SOD-004 | U010 | Payroll_Maintain + Payroll_Approve | Alta | 10,7 s |
| SOD-005 | U007 | Bank_Reconcile + Payment_Release | Média | 9,8 s |
| SOD-007 | U008 | Dev_Commit + Prod_Deploy | Média | 10,4 s |
| SOD-008 | U009 | Inventory_Adjust + Inventory_Count_Approve | Baixa | 9,9 s |
* A primeira explicação inclui o carregamento do modelo.
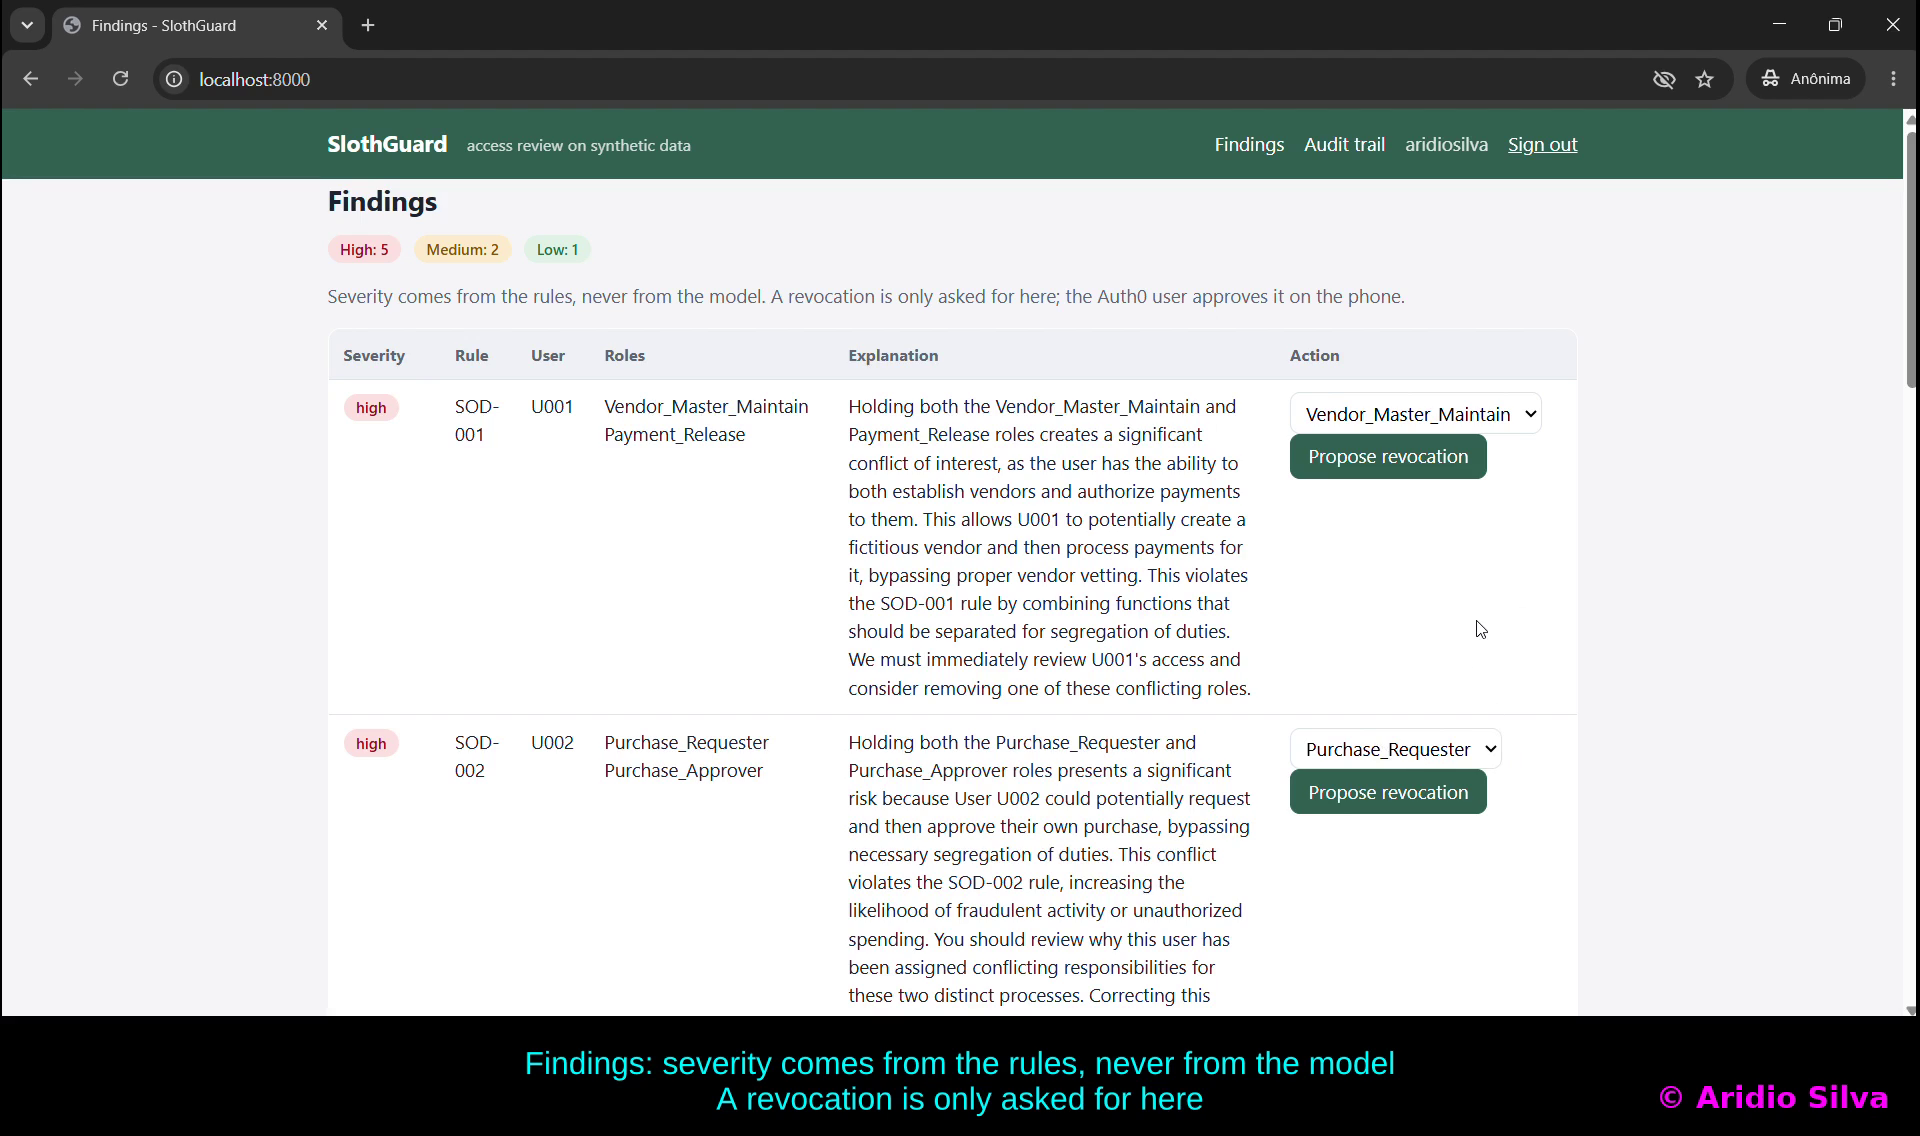
Aqui está o primeiro achado por inteiro. Este é o texto que o Gemma escreveu na execução commitada de 23/10, em 4 frases (docs/evidence/report-sample.md; o modelo responde em inglês). O quadro acima vem de uma execução posterior, então a redação difere:
Holding both the Vendor_Master_Maintain and Payment_Release roles creates a significant risk because a single user has the ability to create a vendor and then process payments for that vendor. This conflict violates the Separation of Duties (SOD-001) principle, allowing for potential fraud, such as creating fictitious vendors and issuing payments. To mitigate this, review the access controls to ensure that the authority to maintain vendor master data is strictly separated from the authority to release payments. Consider restricting the Payment_Release role to only payments against existing, approved vendors.
Quando uma pessoa propõe revogar um papel, o pedido chega ao celular como um push do Guardian. A página mostra Waiting e se atualiza sozinha.
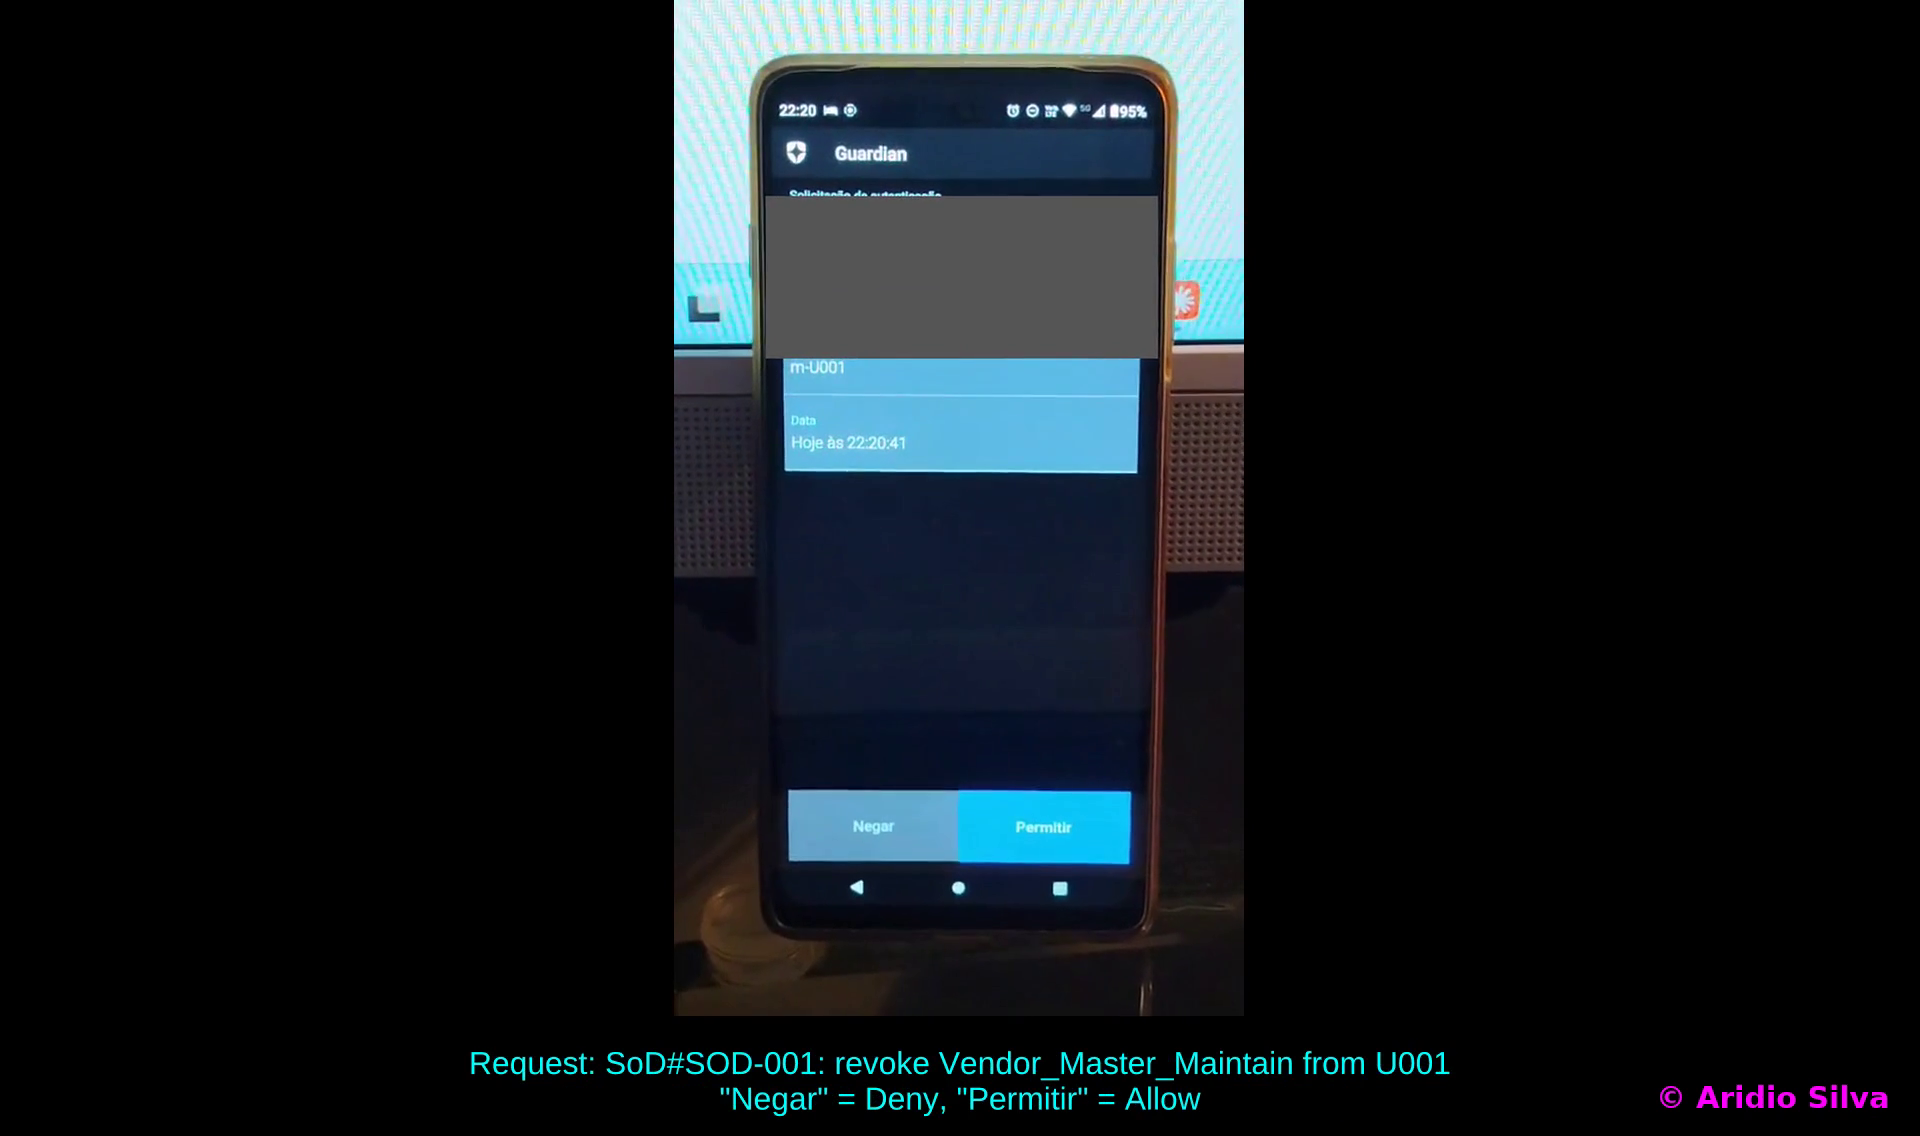
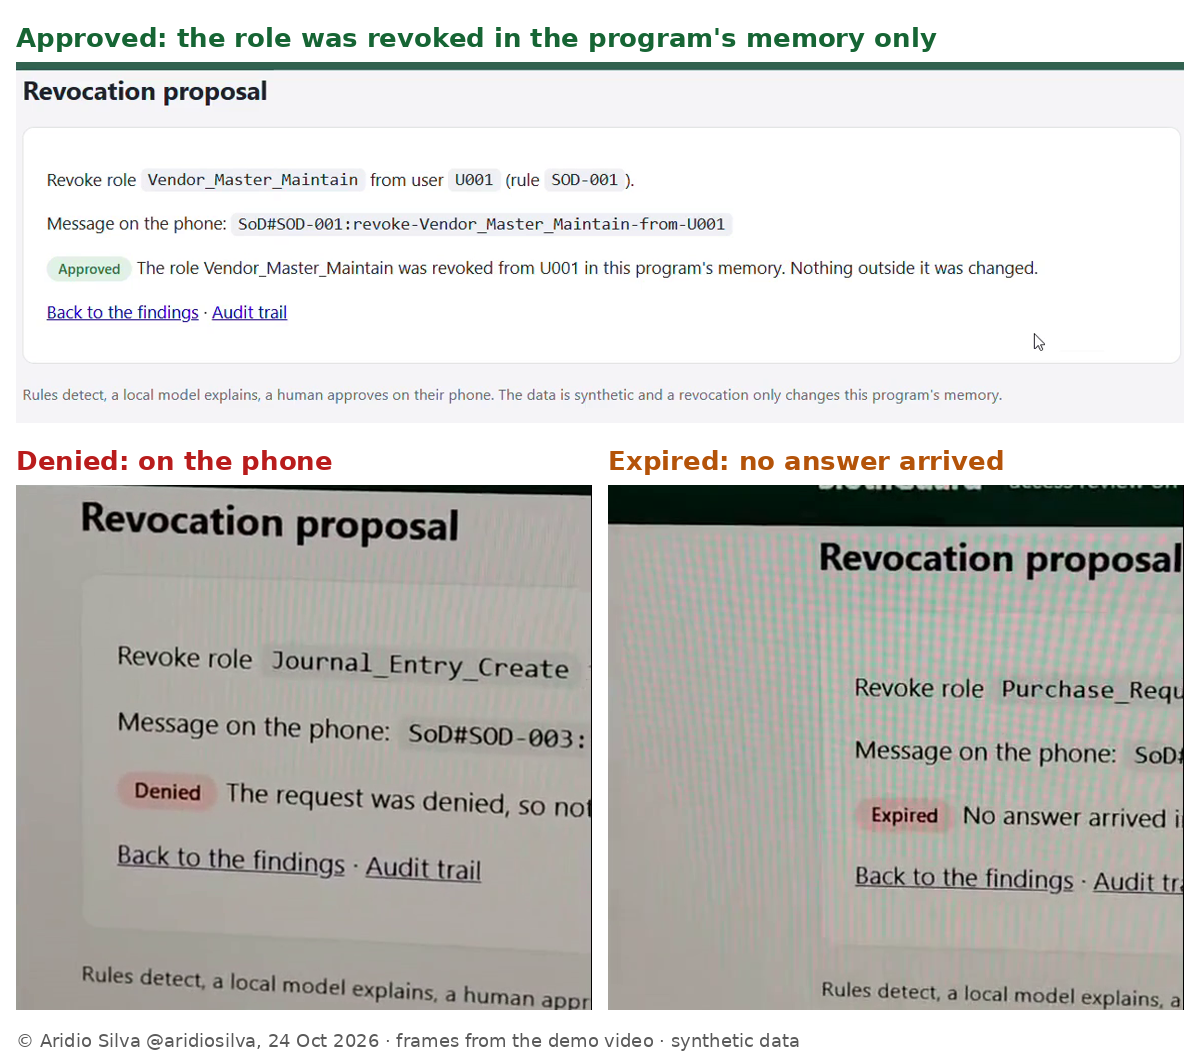
Vendor_Master_Maintain de U001. "Negar" é recusar, "Permitir" é aprovar. Tenant e e-mail estão cobertos.O pedido pode terminar de três formas, e cada uma termina de um jeito:
Código
Repositório: https://github.com/aridiosilva/SlothGuard
Para rodar (PowerShell, na pasta do projeto):
ollama pull gemma4:e2b
.\.venv\Scripts\python scripts\run_review.py   # Fase 1: exige o Ollama ativo
.\.venv\Scripts\python scripts\run_app.py      # Fase 2: abra http://localhost:8000
Use localhost, não 127.0.0.1: é o endereço registrado no Auth0. As configurações do Auth0 ficam num arquivo .env local, ignorado pelo git; a seção "Auth0 setup" do README lista exatamente o que configurar.
Testes: 177 aprovados e 1 pulado, conforme o README (o pulado precisa de um Ollama ativo: defina RUN_OLLAMA_TESTS=1). O histórico do git mostra os commits test: antes dos feat: correspondentes.
A ideia central, o limite e o texto de reserva em volta do modelo, em src/slothguard/llm/__init__.py:
def explain_finding(
    finding: Finding,
    rule: SoDRule,
    client: LLMClient,
    cache: Optional[ExplanationCache] = None,
    max_sentences: int = MAX_SENTENCES,
) -> Explanation:
    if cache is not None:
        hit = cache.get(finding)
        if hit:
            return Explanation(text=hit, source="cache")

    try:
        answer = client.generate(build_prompt(finding, rule, max_sentences))
    except Exception:
        return Explanation(text=fallback_text(finding, rule), source="fallback", reason="model_error")

    text = clean_model_text(answer) if isinstance(answer, str) else ""
    if not text:
        return Explanation(text=fallback_text(finding, rule), source="fallback", reason="empty_answer")

    if count_sentences(text) > max_sentences:
        return Explanation(text=fallback_text(finding, rule), source="fallback", reason="too_many_sentences")

    if cache is not None:
        cache.put(finding, text)
    return Explanation(text=text, source="model")
O prompt pede ao modelo que se limite a 4 frases e não mude a severidade. O código não depende de o modelo obedecer: a severidade vem da regra, e o limite é conferido depois.
Como eu construí
Primeiro, este PC aguenta? Antes de montar a etapa de explicação (22 e 23/10), verifiquei se esta máquina conseguiria carregar um modelo. No papel parecia apertado: 15,7 GB de RAM utilizáveis em canal único e um teto de velocidade, calculado por alto a partir da banda de memória, de cerca de 14 tokens por segundo. Depois medi seis requisições com o Gemma 4 E2B: de 13,0 a 21,6 tokens por segundo, com apenas 4,2 GB de RAM livres antes da primeira. Meu teto estava errado, então confiei na medição, e não na estimativa.
Fase 1: regras primeiro, modelo depois. As regras rodam antes do modelo e decidem tudo o que importa: qual usuário, qual regra, qual severidade. Só então o Gemma 4 E2B (a tag gemma4:e2b no Ollama, um download de 4,6 GB) recebe o achado e escreve uma explicação curta, com o thinking desligado. O limite é imposto pelo código, e não só pedido no prompt: nas minhas primeiras medições, uma resposta em seis o ultrapassou. Se uma resposta falhar, vier vazia ou passar do limite, um texto-padrão é usado para aquele achado e o motivo é registrado, então uma resposta ruim nunca trava o relatório. O texto-padrão não é hipotético: na minha primeira execução real do script de revisão (23/10), o Ollama não estava ativo, os 8 achados saíram com o texto-padrão em 32,9 s, e o relatório foi gerado mesmo assim. Hoje, se o Ollama não puder ser alcançado de jeito nenhum, o run_review.py para na hora, em vez de gerar um relatório feito só de textos-padrão.
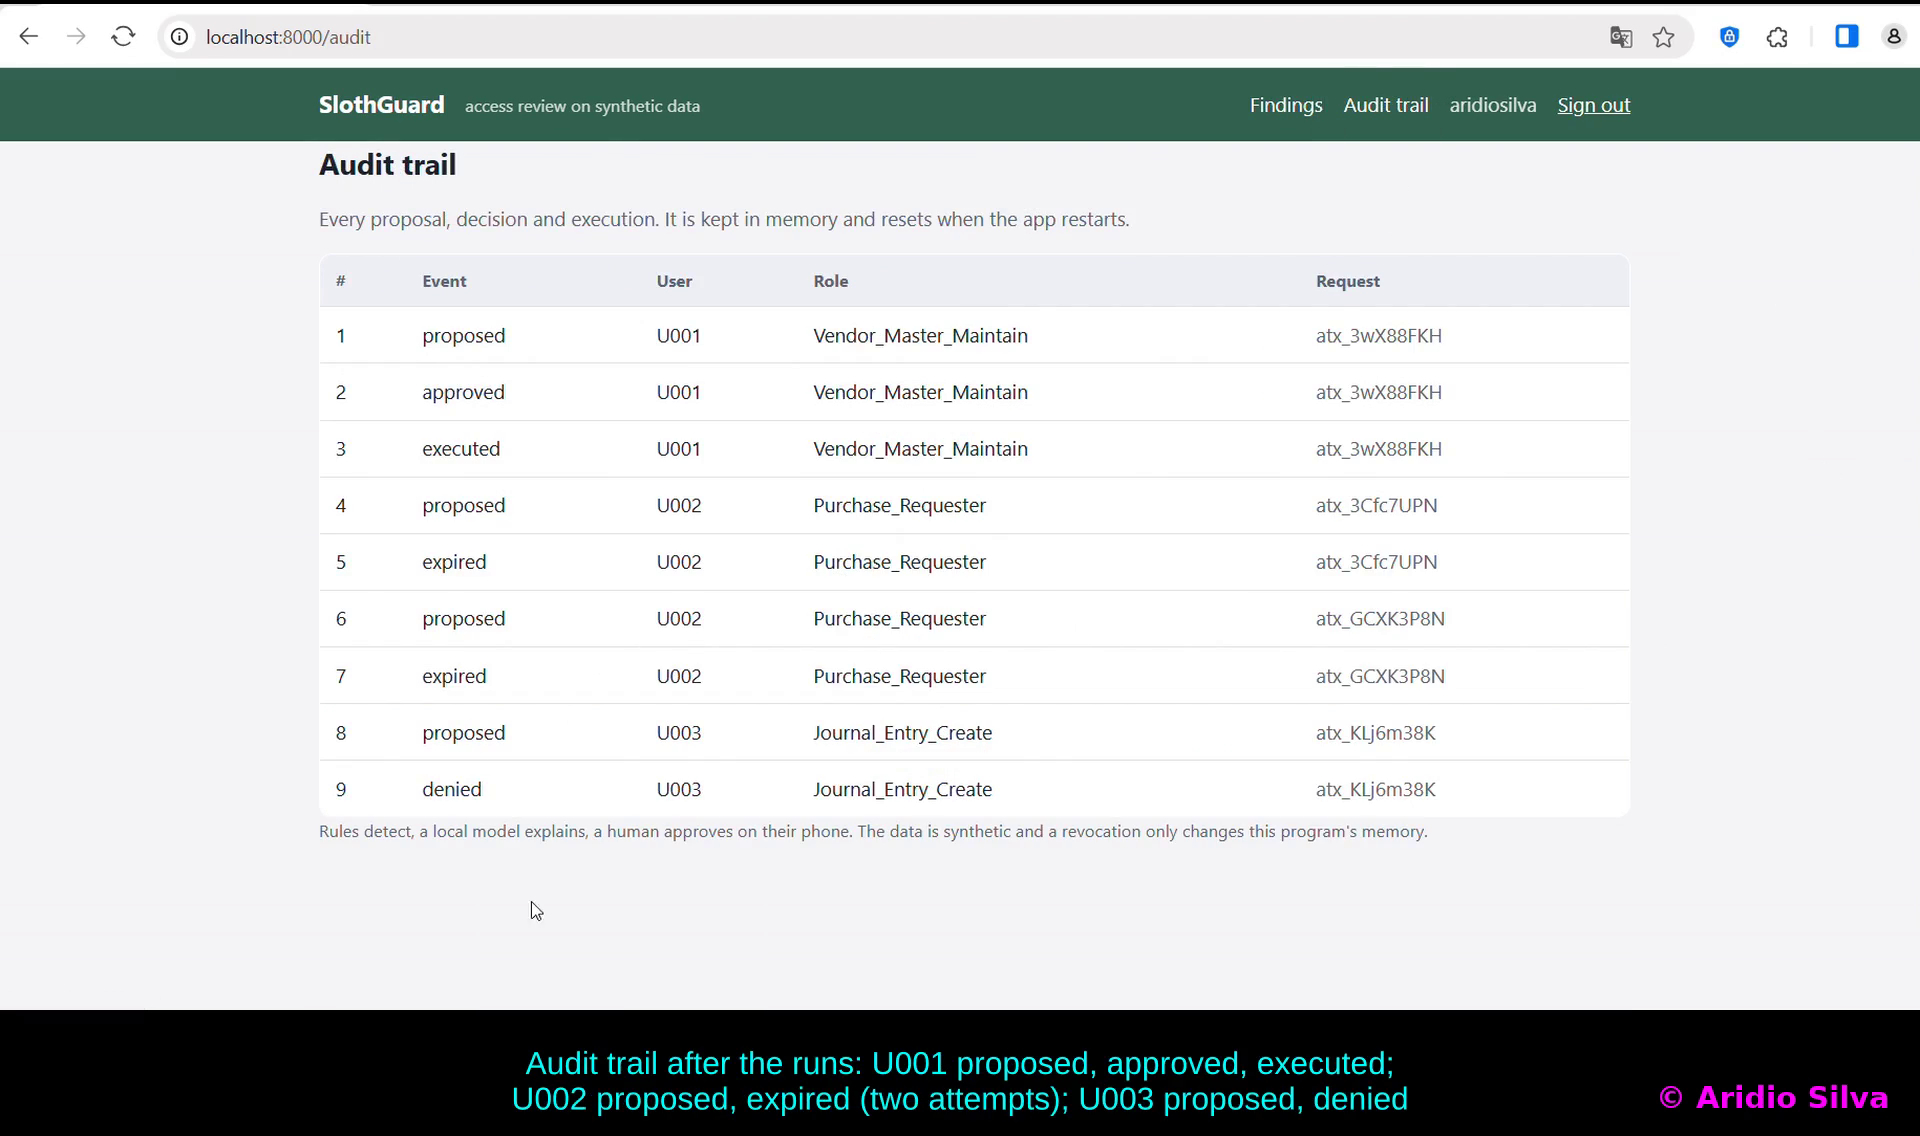
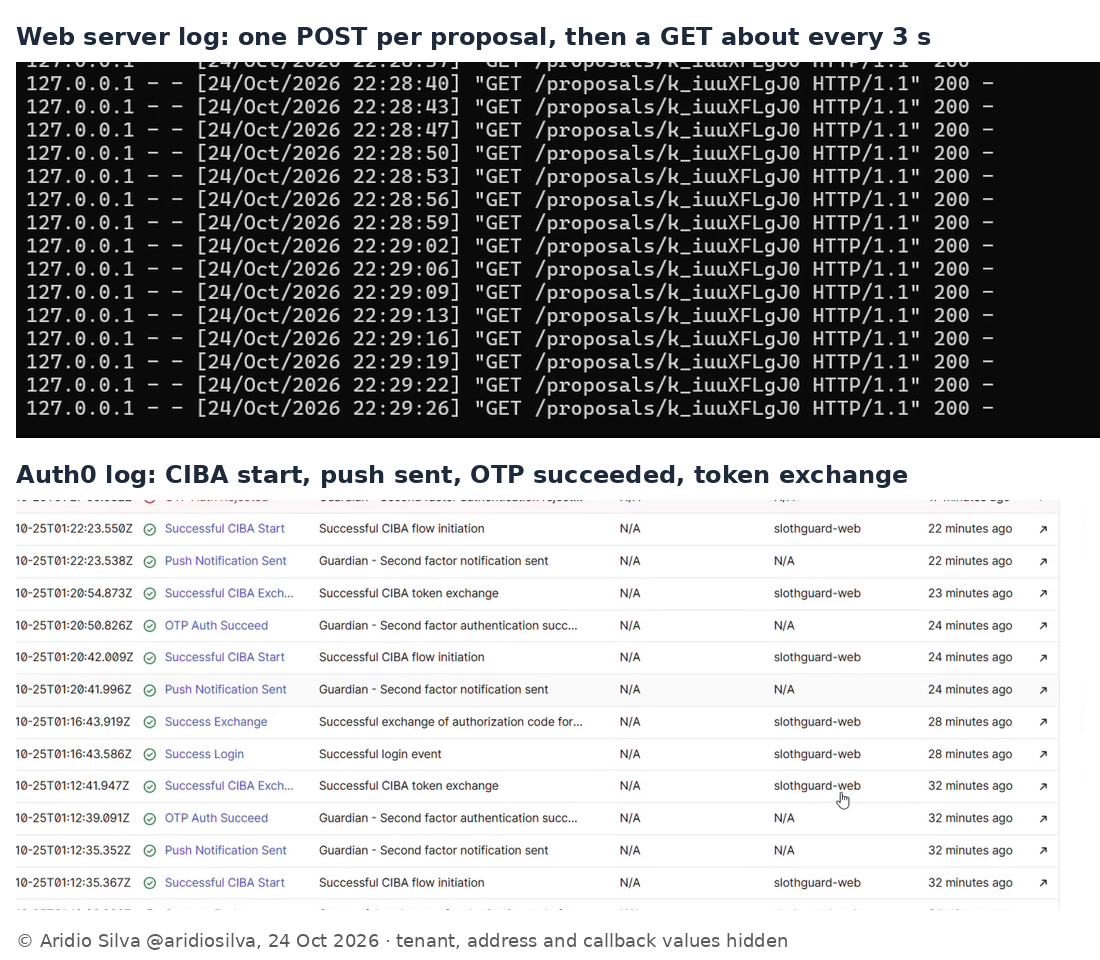
Fase 2: o passo humano. O app web deixa o revisor entrar pelo Auth0 Universal Login e propor uma revogação a partir da página de achados. O app inicia um pedido CIBA, e o Auth0 envia um push ao app Guardian no celular, com uma mensagem curta como SoD#SOD-001:revoke-Vendor_Master_Maintain-from-U001. A página consulta GET /proposals/<id> a cada 3 segundos, aproximadamente, até a resposta chegar. Aprovado, negado ou expirado, cada desfecho vai para a trilha de auditoria. O gateway falha fechado: erro, resposta desconhecida ou timeout (120 s) significam "não revogar". O texto no celular é o mesmo mostrado na página, então o aprovador vê o que está aprovando. Verifiquei os três desfechos na interface real.
Testes primeiro. Para cada peça escrevi os testes antes do código e os commitei separadamente, então o histórico mostra commits test: antes dos feat: correspondentes. As chamadas ao Auth0 e ao Ollama são cobertas com simulações, e conferi os serviços reais à mão.
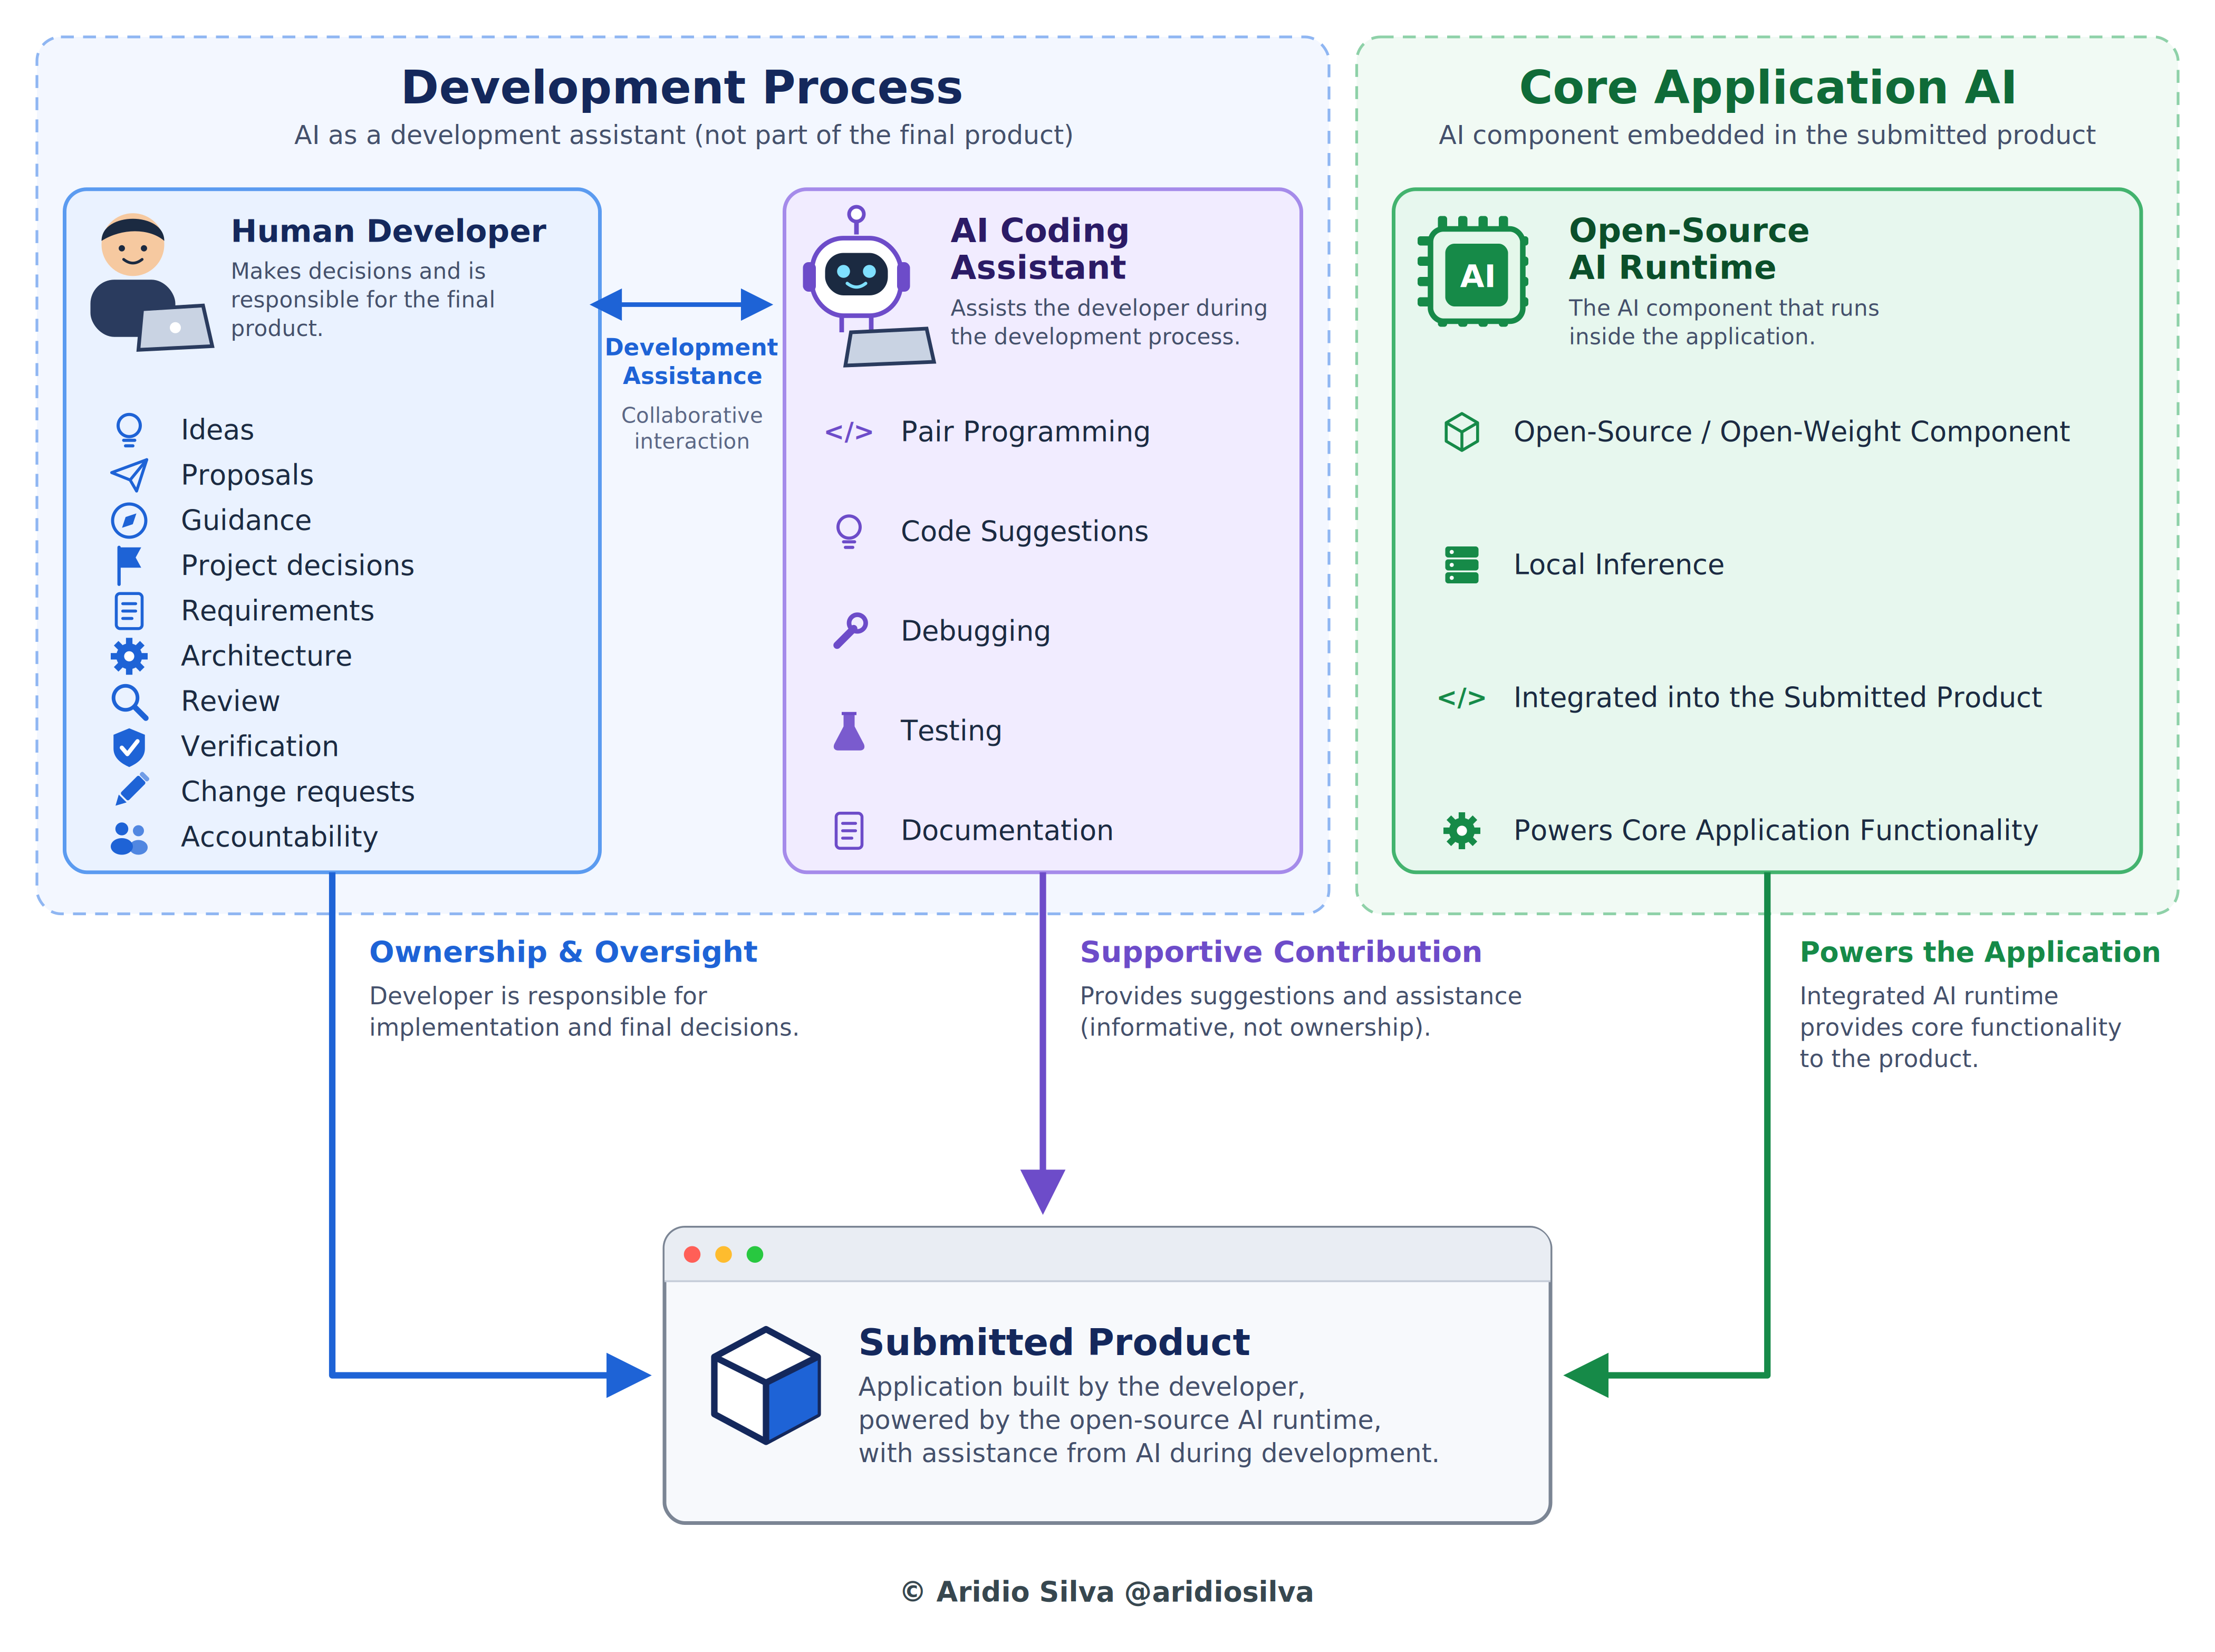
Pair-programming com uma IA. Construí o SlothGuard como desenvolvedor humano, em pair-programming com um assistente de código de IA, o Claude (Anthropic). Eu defini o objetivo, os requisitos e a arquitetura, tomei as decisões do projeto, revisei e verifiquei o código e fiz sozinho todos os passos manuais: a configuração do Auth0, a instalação do Guardian e do Ollama e a execução dos comandos. O Claude ajudou com sugestões de código, depuração, testes e rascunhos de documentação. Ele não definiu a direção e não faz parte do produto: a IA dentro do produto é o Gemma 4 E2B. A Figura 8 mostra a divisão; o relato completo está no README.
Por que a inovação aberta importa?
Os dados ficam na minha máquina. A explicação vem de um modelo que eu mesmo executo. A lista de quem tem qual papel nunca vai para um provedor de modelo. O que sai da máquina é o login e uma mensagem curta de aprovação que o Auth0 entrega ao celular. Essa é a troca inteira, e ela aparece na tela do celular no vídeo.
A Fase 1 funciona offline. Rodei com o PC em modo avião, depois de um teste de conectividade retornar False: 8 de 8 explicações vieram do modelo local, em 63,5 s. Só a Fase 2 precisa de internet, porque o Auth0 precisa.
Posso medir e ajustar. Como eu executo o modelo, pude olhar tokens e segundos na máquina que faz o trabalho. O Gemma escreve um longo trecho de raciocínio antes de cada resposta. Desligá-lo reduziu os tokens gerados em cerca de 81% (de 506 para 94 em média, três execuções de cada) e levou uma explicação com o modelo já carregado de cerca de 27 s para cerca de 6 s, com a mesma velocidade por token (13 a 22 tokens por segundo). Eu medi, não presumi (docs/evidence/ollama-baseline.md).
É pequeno o bastante para um PC comum. Tudo rodou num Dell 24 All-in-One (EC24250). A planilha docs/recursos_hardware_e_limitacoes_v2.xlsx do repositório traz a tabela completa de recursos e limites (em português). Em resumo:
| Item | Valor |
|---|---|
| Máquina | Dell 24 All-in-One EC24250, Windows 11 |
| CPU | Intel Core i5-1334U (13ª geração), 10 núcleos (2 de desempenho + 8 de eficiência), 15 W de base |
| RAM | 16 GB (15,7 GB utilizáveis), SODIMM a 5200 MT/s, canal único (1 de 2 slots usados) |
| GPU | Intel UHD Graphics, 128 MB dedicados, empresta RAM do sistema; não verifiquei se o Ollama a usou |
| Software | Ollama 0.40.8 (0.40.10 depois), gemma4:e2b (4,6 GB em disco), Python 3.14.7 |
Posso trocar o modelo. O cliente envia uma requisição a um servidor local, então testar outro modelo de pesos abertos é trocar o nome do modelo. Só testei o Gemma 4 E2B, e um modelo sem modo de raciocínio pode exigir a retirada do parâmetro que o desliga.
Onde o aberto não venceu com clareza. Não comparei com um modelo fechado, então não afirmo que o Gemma explica melhor ou mais barato. Um modelo local pequeno é lento aqui (de 63,5 a 157,4 s para oito explicações, conforme a execução) e às vezes escolhe palavras que eu não escolheria: na medição-base ele escreveu "critical" em 4 de 6 respostas para achados que a regra classifica como "high". Por isso ele só explica. O Auth0 é um serviço hospedado e o passo de aprovação precisa de internet. O que o modelo aberto me dá é controle sobre onde roda a parte sensível, não um benchmark.
O ganho preguiçoso
Só números que eu medi. Fase 1, 40 usuários contra 9 regras, 8 achados, os 8 explicados pelo modelo. A tabela lista as execuções que têm um arquivo no repositório ou no seu histórico, mais a execução mostrada no vídeo:
| Execução | Tempo total | Condições |
|---|---|---|
23/10, review-run.md |
97,1 s | RAM livre de 6,1 GB; Ollama iniciado à mão; ChatGPT fechado. O primeiro achado leva 23,9 s porque inclui o carregamento do modelo; os outros sete levam de 9,8 a 11,5 s |
23/10, review-run-4.3gb-2026-10-23.md |
139,0 s | RAM livre de 4,3 GB; modo de energia não verificado; ChatGPT fechado, mas Claude e um navegador ainda abertos; modelo descarregado antes da execução; Ollama iniciado à mão. O primeiro achado leva 52,8 s; os outros sete levam de 10,5 a 13,9 s |
23/10, review-run-low-ram.md |
157,4 s | RAM livre de 1,1 GB; Windows recém-reiniciado e outros apps abertos, então não é uma execução limpa. O primeiro achado leva 57,8 s |
| 24/10, a execução do vídeo | 98,9 s | Condições não registradas; esta execução não está commitada |
25/10, review-run-airplane-two-browsers-2026-10-25.md |
104,1 s | Modo avião ligado, dois navegadores abertos; RAM livre não medida; conectividade não testada. O primeiro achado leva 26,4 s |
25/10, review-run-offline-2026-10-25.md |
63,5 s | Offline (o teste de conectividade retornou False); RAM livre de 2,1 GB antes da execução. O primeiro achado leva só 6,8 s, então o modelo provavelmente ainda estava carregado da execução anterior (minha inferência); os outros sete levam de 6,0 a 8,9 s |
Nas três execuções de 23/10, mais memória livre significou execução mais rápida (97,1 s, 139,0 s, 157,4 s). A execução offline de 25/10 mostra que não é a história toda: foi a mais rápida, com apenas 2,1 GB livres, embora o modelo provavelmente já estivesse carregado. Então a espera do revisor é uma faixa, de 63,5 s a 157,4 s, e eu não diagnostiquei o motivo. Antes de montar o pipeline eu havia estimado de 54 a 73 s para oito achados, a partir de uma medição pequena (uma estimativa, não uma medição; mesma planilha). A execução offline fica dentro dessa faixa e as demais execuções registradas ficam acima.
Verificação de qualidade (docs/evidence/review-quality.md): 8 achados, 8 explicados, os 8 dentro de 4 frases. Uma explicação (SOD-007, U008) usou a palavra "critical" para um achado que a regra classifica como médio.
Não medi quanto tempo isso economiza em relação à revisão manual, e não afirmo um número.
Limites
- Só dados sintéticos. 40 usuários e 9 regras. É um protótipo, não um produto.
- A revogação altera uma cópia em memória. Nada toca um sistema de identidade real, e a trilha de auditoria zera quando o app reinicia.
- Um modelo pequeno desvia. Na execução final, as 8 explicações ficaram dentro de 4 frases, mas uma chamou um achado médio de "critical"; na medição-base, "critical" apareceu em 4 de 6 respostas para achados "high", e uma resposta teve 5 frases. Por isso a severidade vem das regras e o código impõe o limite. Minha verificação de qualidade conta frases e palavras de severidade; ela não julga se uma explicação está correta.
- O tempo varia. Veja a tabela acima.
- O timeout. O pedido de U002 expirou após 120 s sem resposta; a trilha de auditoria mostra duas tentativas assim.
- Arestas na minha própria gravação. A primeira tentativa de login terminou numa página de erro 400, e a segunda funcionou. O log do Auth0 também avisa que chaves de desenvolvimento estão em uso na conexão com o Google. Os trechos do celular são de execuções separadas, gravadas às 22:20, 22:29 e 22:33. As legendas dizem isso.
- Uso da GPU não verificado. A máquina tem só gráficos Intel UHD, que emprestam RAM do sistema. Rodei o Ollama com as configurações padrão e não verifiquei se a GPU integrada foi usada.
- Uma pessoa pode ocupar os dois papéis. Na minha demo, quem propõe e quem aprova podem ser o mesmo usuário do Auth0. Uma implantação real precisa de duas pessoas.
- A mensagem de aprovação sai da máquina. Ela contém o id do usuário e o nome do papel, e esse texto vai para o Auth0. Com dados reais eu enviaria ids opacos.
- Período de teste do Auth0. Verifiquei a aprovação assíncrona num tenant do Auth0 durante o período de teste gratuito. Não verifiquei se ela fica disponível depois do teste.
- Servidor de desenvolvimento. O servidor web é o servidor de desenvolvimento do Flask, pensado para uso local.
- Sem alegação de novidade. Não pesquisei trabalhos anteriores, então não chamo o projeto de novo além de "construído esta semana".
- Commits depois do prazo. Nenhum.
Categorias de prêmio
- Best Use of Auth0 for AI Agents. A página do desafio lista "pedir que uma pessoa aprove uma ação arriscada antes de o agente executá-la" como um uso. O passo central do SlothGuard é esse: uma revogação fica só proposta até uma pessoa responder pelo Auth0 CIBA e Guardian, com o Universal Login para a entrada. Nota honesta: a aprovação assíncrona funcionou no meu tenant do Auth0 durante o período de teste gratuito, e não verifiquei se ela fica disponível depois do teste.
- Best Use of Gemma. O Gemma 4 E2B roda localmente pelo Ollama e escreve cada explicação da demo, sem chamada de nuvem para o modelo.
Fontes primárias
- Hacktoberfest Open-Source AI Challenge: Week 3
- General Contest Official Rules
- Auth0 for AI Agents
- Gemma
Créditos
Construído por Aridio Silva, Pesquisador Independente (@aridiosilva), ORCID 0009-0008-2411-6995, com ajuda de IA (pair-programming com o Claude). Bibliotecas: Flask, Authlib, Requests, pytest. Modelo: Gemma 4 E2B, executado pelo Ollama. Identidade e aprovação: Auth0 (Universal Login, CIBA, Guardian). A documentação do Auth0 e do Ollama foi usada para os formatos das requisições.
Imagens, vídeo e metadados: © Aridio Silva @aridiosilva, 24 Oct 2026.
Vídeo completo da demo
Post no DEV CommunityPágina do hackathonZenodo DOIRepositório no GitHub