SGAEIA Research Series — Artigo 17
Aridio Silva
Independent Researcher, Brazil
Creator of SGAEIA — Secure Governed Autonomous Edge Intelligence Architecture
ORCID: 0009-0008-2411-6995
Copyright: © 2026 Aridio Silva | Licença: CC BY 4.0
Resumo
O jailbreak de inteligência artificial designa tentativas de contornar restrições comportamentais de modelos, mas sua importância cresce quando esses modelos passam a operar ferramentas e coordenar ações. Este artigo apresenta uma revisão narrativa crítica da evolução do problema, distingue jailbreak, prompt injection e comprometimento da autoridade, e examina ataques, defesas e métodos de avaliação. Pela ótica do SGAEIA, propõe uma síntese de análise em três níveis: resposta do modelo, ação autorizada e efeito observado. Essa contribuição é conceitual e não normativa; não constitui demonstração de eficácia da arquitetura nem reivindicação de descoberta inédita. A conclusão é que robustez comportamental, limites de autoridade e evidências de execução devem ser avaliados conjuntamente, com hipóteses e risco residual explícitos.
Palavras-chave: AI; jailbreak; prompt injection; agentes autônomos; autoridade; governança; SGAEIA; assurance.
1. A pergunta muda quando a AI pode agir
Um assistente que responde de forma inadequada e um agente que transmite um documento confidencial não produzem o mesmo tipo de falha. No primeiro caso, a análise pode concentrar-se no conteúdo da resposta; no segundo, precisa alcançar as permissões, as ferramentas e o efeito da operação. A pesquisa sobre injeção indireta demonstrou como dados externos podem influenciar aplicações integradas a modelos e produzir comportamentos contrários aos objetivos do usuário. A segurança, portanto, precisa considerar o sistema que envolve o modelo. [1]
A perspectiva do SGAEIA organiza essa diferença pela relação entre capacidade e autoridade. Capacidade é aquilo que um componente consegue formular ou executar; autoridade é aquilo que ele está legitimamente autorizado a fazer em determinado contexto. Um argumento persuasivo, uma saída bem escrita ou uma mensagem autenticada não estabelecem, por si, essa autorização. Neste artigo, essa distinção funciona como lente analítica, e não como afirmação de que o projeto já possui uma solução implementada e validada.
A pergunta central é: quando um ataque altera o comportamento do modelo, quais fronteiras ainda limitam a ação e quais evidências permitem verificar o resultado? Respondê-la exige compreender a história do jailbreak e os mecanismos estudados pela literatura. Também exige resistir a duas simplificações: tomar uma defesa promissora como garantia universal e tratar toda manipulação por linguagem como a mesma ameaça. O percurso histórico será usado para construir essas distinções antes de discutir suas implicações para agentes.
2. Método e limites desta revisão
Este trabalho é uma revisão narrativa crítica, orientada por problema, com consulta realizada em 6 de outubro de 2026. A seleção parte do estudo e do infográfico fornecidos pelo autor e incorpora fontes primárias sobre ataques, mecanismos de recusa, defesas e avaliação. Foram consultadas páginas de trabalhos acadêmicos, registros de conferências, documentação oficial e publicações dos próprios laboratórios. Não houve busca sistemática exaustiva, metanálise, reprodução experimental nem avaliação de modelos nesta sessão.
As referências numeradas distinguem evidência externa da interpretação desenvolvida no artigo. Estudos de laboratórios são identificados como evidência produzida pelo fornecedor quando essa condição influencia a independência da avaliação. Resultados experimentais permanecem vinculados aos modelos, tarefas e protocolos de origem; valores de um estudo não são tratados como medidas dos produtos atuais. A matriz de auditoria que acompanha o artigo explicita a profundidade da leitura e as verificações ainda necessárias.
3. Do dispositivo ao modelo: a história de uma metáfora
O antecedente conhecido do termo no debate contemporâneo é o ecossistema de dispositivos móveis, especialmente o iPhone lançado em 2007. Nesse ambiente, jailbreak significa contornar restrições do sistema para permitir funcionalidades ou software que o fabricante limita. A documentação da Apple associa essa modificação à evasão de recursos de segurança, enquanto a literatura técnica sobre iOS descreve a superfície de exploração dos dispositivos. Essa história situa a metáfora, mas não demonstra que a palavra tenha sido inventada em 2007. [2,3]
Também é necessário distinguir jailbreak de desbloqueio de operadora. Instalar aplicações fora dos mecanismos previstos pelo fabricante e permitir o uso de outra rede são operações diferentes, embora tenham aparecido juntas nas narrativas populares sobre o iPhone. Em 2010, uma regra norte-americana tratou da circumvenção relacionada à interoperabilidade de aplicações em smartphones; seu alcance era específico. Esse marco é histórico e não deve ser convertido em conclusão geral sobre a legalidade de jailbreaks de AI em qualquer jurisdição. [4]
Na inteligência artificial, a metáfora desloca-se para o comportamento do modelo. Um jailbreak por prompt pode induzir uma resposta contrária à política de segurança sem alterar o sistema operacional, obter privilégio administrativo ou modificar os pesos. O objetivo é explorar a maneira como instruções e contexto condicionam a geração. A taxonomia de aprendizado de máquina adversarial ajuda a distinguir esses ataques de envenenamento de treinamento, alterações de modelo e outras formas de comprometimento. [5]
Em 2022, discussões públicas sobre prompt injection e trabalhos como Ignore Previous Prompt documentaram a possibilidade de desviar modelos com entradas adversariais. A publicação de Simon Willison em setembro é um marco de divulgação do problema, não prova exclusiva de prioridade terminológica. O trabalho de Perez e Ribeiro investiga a manipulação de modelos de linguagem, antes de a pesquisa sobre aplicações com ferramentas se consolidar. A origem do campo deve ser apresentada como uma convergência de práticas e pesquisas, não como uma única invenção. [6,7]
Em 2023, a literatura passou a investigar tanto as falhas de treinamento de segurança quanto a automatização de ataques e a injeção indireta em aplicações. Em 2024, contexto longo, busca de muitas variantes e benchmarks especializados ampliaram a escala e a qualidade metodológica do debate. Em 2025 e 2026, defesas com classificadores e restrições arquiteturais tornaram mais explícita a diferença entre proteger a resposta e restringir consequências. Essa sequência reúne marcos selecionados, não períodos exclusivos: técnicas anteriores continuam relevantes nas fases seguintes. [1,8–11,14,15]
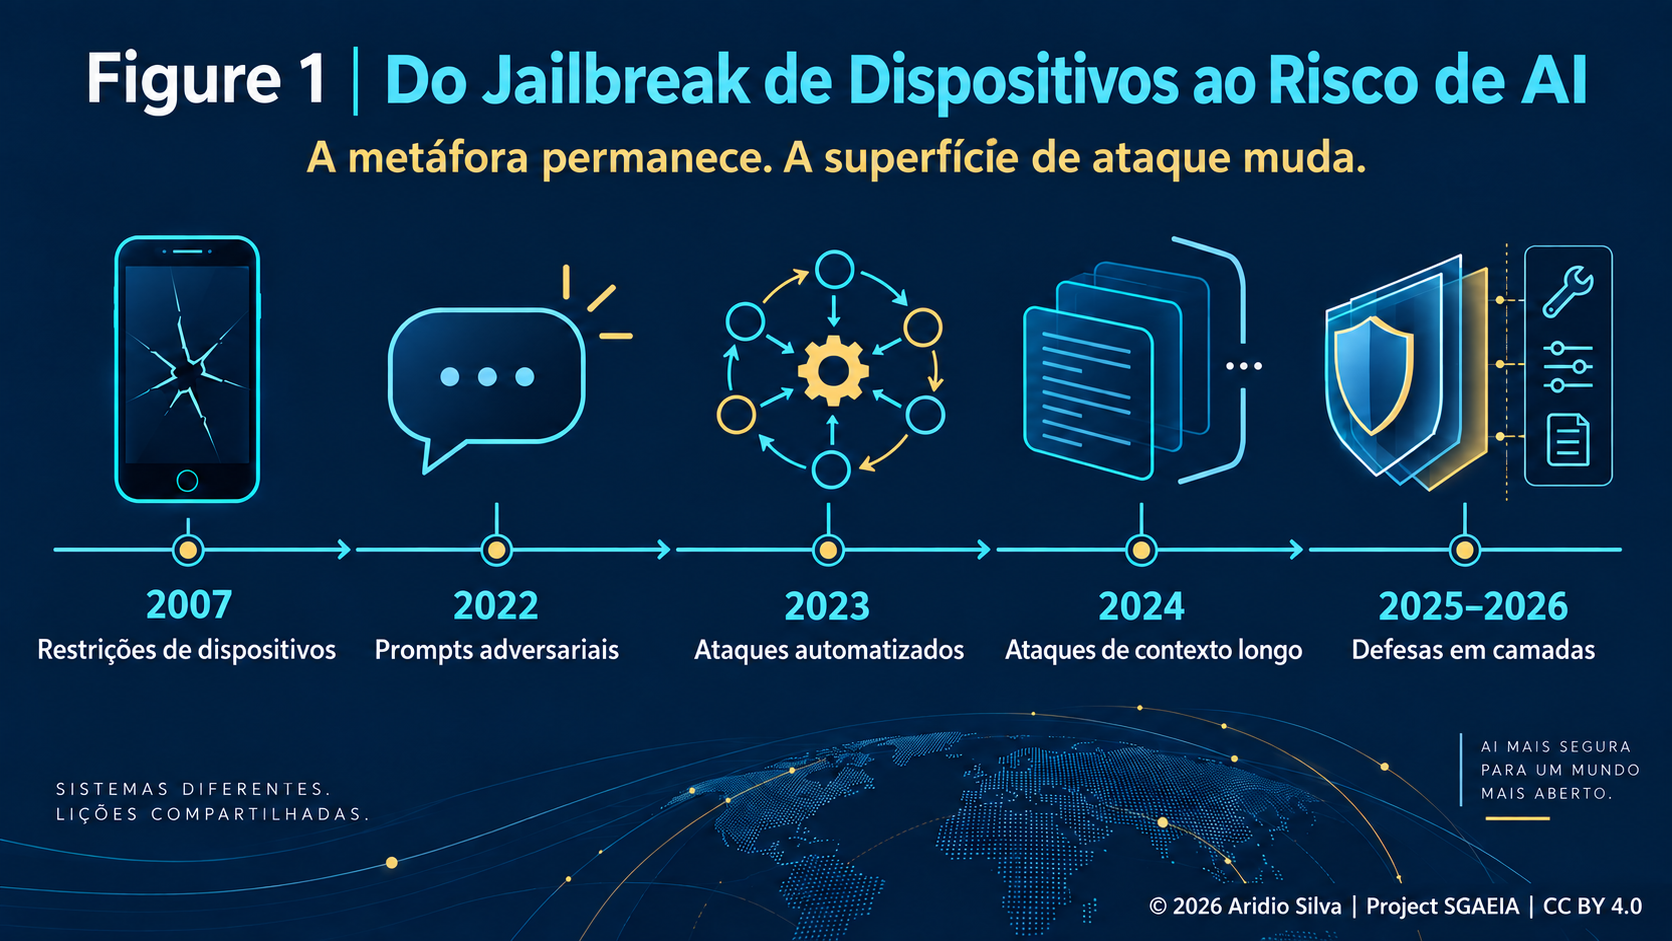
Figure 1 — Da restrição do dispositivo ao risco de AI. Marcos selecionados da evolução do debate; as datas não representam a invenção exclusiva de cada categoria. Fontes: [1,3,7–11,14,15].
4. Jailbreak e prompt injection: conceitos próximos, perguntas diferentes
Neste artigo, jailbreak é uma tentativa de contornar restrições comportamentais de segurança do modelo. Prompt injection é uma tentativa de fazer instruções adversariais interferirem no comportamento previsto de uma aplicação baseada em modelos. A injeção pode ser direta, por uma entrada fornecida ao sistema, ou indireta, por conteúdo externo que ele consulta. As categorias podem sobrepor-se, mas uma injeção que altera um resumo ou direciona uma ferramenta não precisa produzir conteúdo convencionalmente proibido. [1,12]
A diferença entre as categorias não pode ser reduzida a “o usuário ataca” e “um terceiro ataca”. Essas situações são úteis para a didática, mas não esgotam as possibilidades de origem e controle da entrada. O aspecto decisivo é o objetivo violado: uma política comportamental, a tarefa legítima, uma fronteira de autorização ou uma combinação delas. A OWASP identifica Prompt Injection como LLM01:2025, o que não significa que exista um ranking separado no qual qualquer jailbreak seja automaticamente o risco mais grave. [12]
Para o SGAEIA, convém separar ainda a tentativa de persuasão, a influência sobre a decisão e o efeito efetivamente produzido. Um modelo pode interpretar incorretamente um documento e, mesmo assim, encontrar uma barreira de autorização que impeça a ação proposta. Pode também responder com aparente cautela enquanto uma ferramenta opera fora do escopo legítimo. A distinção permite avaliar controles diferentes sem confundir a intenção expressa na conversa com o estado real do ambiente.
| Conceito | Pergunta de análise | Evidência necessária |
|---|---|---|
| Jailbreak | A restrição comportamental foi contornada? | Resposta avaliada em relação à política e à utilidade nociva |
| Prompt injection | Dados adversariais desviaram a tarefa legítima? | Contexto, origem do conteúdo e comportamento resultante |
| Violação de autoridade | A operação ultrapassou o escopo autorizado? | Autorização aplicável e operação efetivamente tentada ou executada |
| Efeito indevido | O ambiente sofreu uma consequência fora do escopo? | Observação independente do estado ou da comunicação produzida |
5. Por que o alinhamento pode falhar
Wei, Haghtalab e Steinhardt propõem duas explicações para falhas de segurança: objetivos concorrentes e generalização incompatível entre capacidade e segurança. Um modelo pode aprender a ser prestativo em contextos nos quais deveria recusar, ou generalizar uma capacidade para uma representação em que o treinamento de segurança é menos eficaz. As hipóteses ajudam a organizar ataques, mas não constituem uma teoria causal completa de todos os sistemas. Seus resultados precisam ser interpretados dentro dos modelos e conjuntos de avaliação estudados. [8]
Outra linha investiga a profundidade do alinhamento. Qi e colaboradores mostram que, nos casos analisados, o comportamento de segurança pode concentrar-se nas primeiras posições da resposta e ser vulnerável a intervenções que contornem essa região. A consequência é uma motivação para treinar e avaliar a segurança ao longo da geração, em vez de observar somente a abertura da resposta. Isso não implica que todo modelo tenha exatamente duas fases de treinamento nem que toda proteção atual seja superficial. [13]
Arditi e colaboradores encontraram uma direção de ativação associada à recusa em 13 modelos de conversação de pesos abertos. O resultado é relevante para a interpretação mecanística, mas não autoriza dizer que toda a segurança de qualquer AI corresponde a um único componente removível. Em 2026, Joad e colaboradores apresentam evidência de direções e estruturas distintas para comportamentos de recusa, qualificando a interpretação unidimensional. A evolução da literatura recomenda separar uma intervenção eficaz de uma explicação completa do mecanismo. [16,17]
A possibilidade de ajuste fino adiciona outra condição de ameaça. Qi e colaboradores demonstraram degradação de segurança tanto com ajustes adversariais quanto em determinadas adaptações aparentemente benignas. Esse resultado mostra que a avaliação de segurança precisa acompanhar mudanças do modelo, e não apenas sua entrega inicial. Os custos e quantidades de exemplos relatados no experimento histórico não devem ser apresentados como uma receita reproduzível nos serviços atuais. [18]
Pela ótica do SGAEIA, a inferência relevante é que a resistência do modelo não deve ser a única fonte de confiança de uma operação. Essa afirmação não desvaloriza o alinhamento: modelos mais resistentes podem reduzir frequência e gravidade de falhas. Ela acrescenta uma pergunta sobre a sobrevivência dos controles quando essa resistência não basta. A hipótese arquitetural precisa ser verificada separadamente, inclusive sob falha do componente que decide ou registra a autorização.
6. Ataques: acesso, representação e trajetória
Acesso de caixa-preta significa interagir com o sistema sem acesso aos parâmetros; caixa-branca envolve conhecimento ou controle interno; condições intermediárias variam conforme a interface disponível. É inadequado reduzir caixa-preta à conversa textual, pois ferramentas, áudio e imagens também podem compor a entrada. Tampouco mais acesso implica, em toda situação, menor custo: orçamento, defesa e objetivo interferem na comparação. A taxonomia deve declarar o que o atacante consegue observar, alterar e consultar. [5]
O GCG é um marco da automatização de ataques por otimização e transferência entre modelos. Many-shot explora demonstrações repetidas em contexto, enquanto Best-of-N investiga a busca de variantes de entrada em diferentes modalidades. Crescendo estuda a escalada em múltiplas interações, mostrando por que o histórico importa para a interpretação do ataque. Essas famílias indicam superfícies distintas e não precisam ser descritas com prompts operacionais para que sua relevância seja compreendida. [9–11,19]
| Família | Superfície conceitual | Implicação para a avaliação SGAEIA |
|---|---|---|
| Otimização e transferência | Busca de entradas que induzam comportamento adversarial | Declarar acesso, orçamento e transferência; não presumir universalidade |
| Contexto longo | Demonstrações que condicionam a continuação | Verificar influência cumulativa e origem do contexto |
| Busca de variantes | Muitas tentativas com alterações de representação | Reportar orçamento por objetivo e sucesso acumulado |
| Múltiplos turnos | Dependência entre mensagens e estado da interação | Avaliar a trajetória, além de mensagens isoladas |
| Injeção indireta | Conteúdo de terceiros incorporado à tarefa | Verificar se dados adquiriram influência de instrução |
| Memória e multimodalidade | Estado persistente e modalidades adicionais | Reavaliar controles quando a superfície de entrada muda |
Em 2026, Zhao e colaboradores publicaram na USENIX Security um estudo de ataques multi-turno a sistemas de geração de imagens que exploram mecanismos de memória. O achado amplia a discussão para além do chatbot textual, mas não demonstra que toda memória persistente esteja comprometida ou que qualquer sistema multimodal falhe. Para o SGAEIA, ele sustenta uma pergunta de pesquisa: quais propriedades precisam permanecer válidas quando informações atravessam sessões ou são reutilizadas por outros componentes? A resposta exige testes próprios de proveniência e influência temporal. [20]
7. Defesas: resistência do modelo e limites do sistema
Defesas comportamentais procuram reduzir a probabilidade de uma resposta inadequada; defesas sistêmicas procuram controlar o que essa resposta pode causar. Treinamento e classificadores pertencem ao primeiro conjunto, enquanto restrições de acesso e de fluxo podem limitar efeitos do segundo. A separação não é absoluta, pois um classificador pode integrar uma decisão de execução. O objetivo da análise é identificar o papel de cada controle e a condição de falha que ele deve cobrir. [12,14]
CaMeL propõe extrair fluxos de controle e dados da consulta confiável e aplicar políticas sobre fluxos de informação nas chamadas a ferramentas. O trabalho demonstra um caminho para proteger determinadas propriedades do sistema mesmo quando o modelo processa dados adversariais. As garantias dependem das hipóteses, da política e do ambiente contemplado; o artigo não prova imunidade de todos os agentes ou equivalência entre qualquer desenho de dois modelos. A relevância para o SGAEIA está na independência conceitual entre persuasão e autorização. [14]
Em janeiro de 2026, a Anthropic descreveu Constitutional Classifiers++, combinando classificação da interação e uma cascata de avaliação. A empresa relata redução de custo e recusas indevidas, além de maior resistência nos testes realizados. Trata-se de evidência do fornecedor: a ausência de jailbreak universal encontrado no protocolo não é prova de inexistência, e o relato reconhece vulnerabilidades remanescentes. Esse desenvolvimento também qualifica a leitura do protótipo de 2025, pois a própria retrospectiva informa um jailbreak universal encontrado no programa posterior de recompensas. [15]
Na leitura do SGAEIA, defesa em profundidade deve ser examinada pela independência efetiva das camadas. Dois controles que dependem da mesma interpretação manipulável podem falhar juntos. Uma confirmação humana também pode ser insuficiente se a apresentação ocultar o recurso, o destino ou a consequência da operação. Essas são hipóteses de avaliação de controles, não evidências de que um mecanismo específico do projeto já as resolveu.
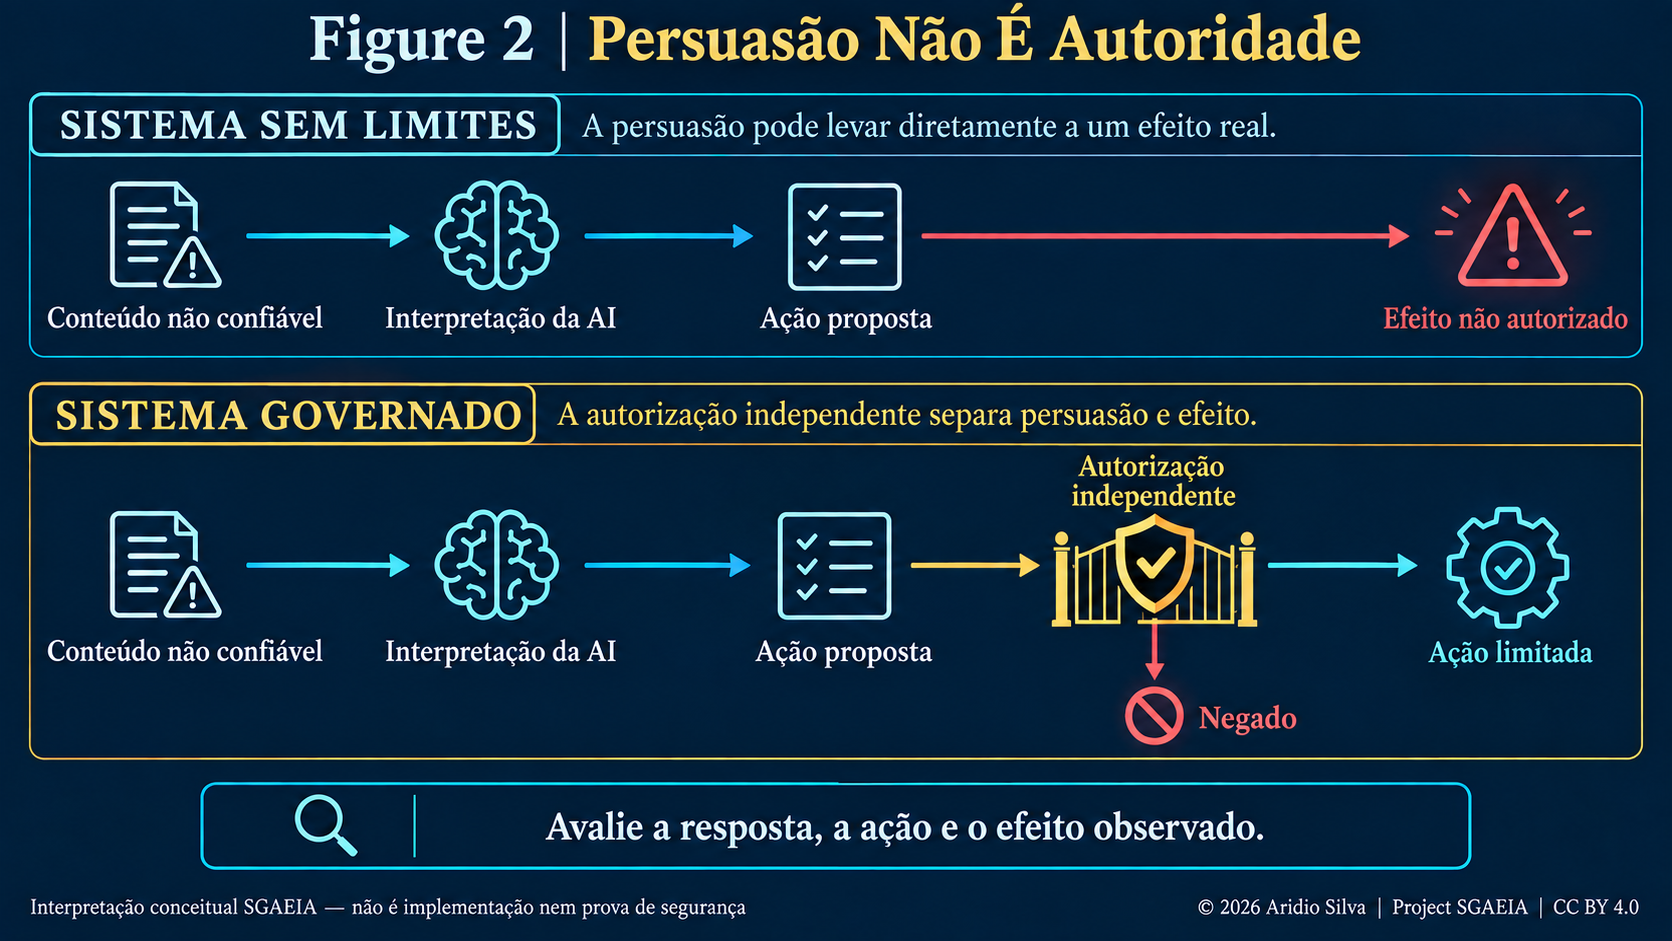
Figure 2 — Persuasão não estabelece autoridade. Comparação conceitual entre influência comportamental e uma fronteira independente de autorização; o diagrama não descreve implementação privada nem prova de segurança. Fonte conceitual: [14]; interpretação SGAEIA.
8. A contribuição analítica: resposta, ação e efeito
A contribuição deste artigo é organizar a avaliação em três níveis articulados. O primeiro examina o conteúdo produzido pelo modelo; o segundo verifica a relação entre ação e autoridade aplicável; o terceiro observa a consequência no ambiente. A síntese aproxima avaliação de jailbreak e governança de agentes sem fundi-las em uma única métrica. Trata-se de uma organização conceitual a investigar, e não de uma reivindicação de novidade científica sem auditoria de anterioridade.
No nível da resposta, interessa saber se a saída atende a um objetivo adversarial de maneira útil. No nível da ação, interessa saber se uma operação foi proposta, permitida, negada ou executada e qual autorização se aplicava. No nível do efeito, interessa saber se houve comunicação, alteração de estado ou outra consequência incompatível com o escopo legítimo. A evidência do terceiro nível não pode consistir apenas na frase “a ação foi bloqueada” produzida pelo mesmo componente que pode ter falhado.
Considere um exemplo hipotético: um assistente recebe autorização para resumir documentos internos. Um documento externo introduz conteúdo destinado a redirecionar a tarefa para o compartilhamento de um arquivo. O modelo pode incorporar essa sugestão, mas a ferramenta pode negar o destino ou a operação; nesse caso, houve influência comportamental sem o efeito de divulgação. Se o arquivo for enviado, a avaliação deverá registrar a violação e verificar o destino, em vez de inferir segurança pelo tom cauteloso da resposta.
O exemplo não demonstra eficácia de um produto nem propõe um protocolo interno. Ele esclarece por que o sucesso do ataque no modelo e o sucesso do ataque no sistema são eventos diferentes. Também mostra que o bloqueio da ferramenta não apaga a falha comportamental, embora possa reduzir seu impacto. Uma avaliação útil deve registrar os dois resultados e a evidência do ambiente.
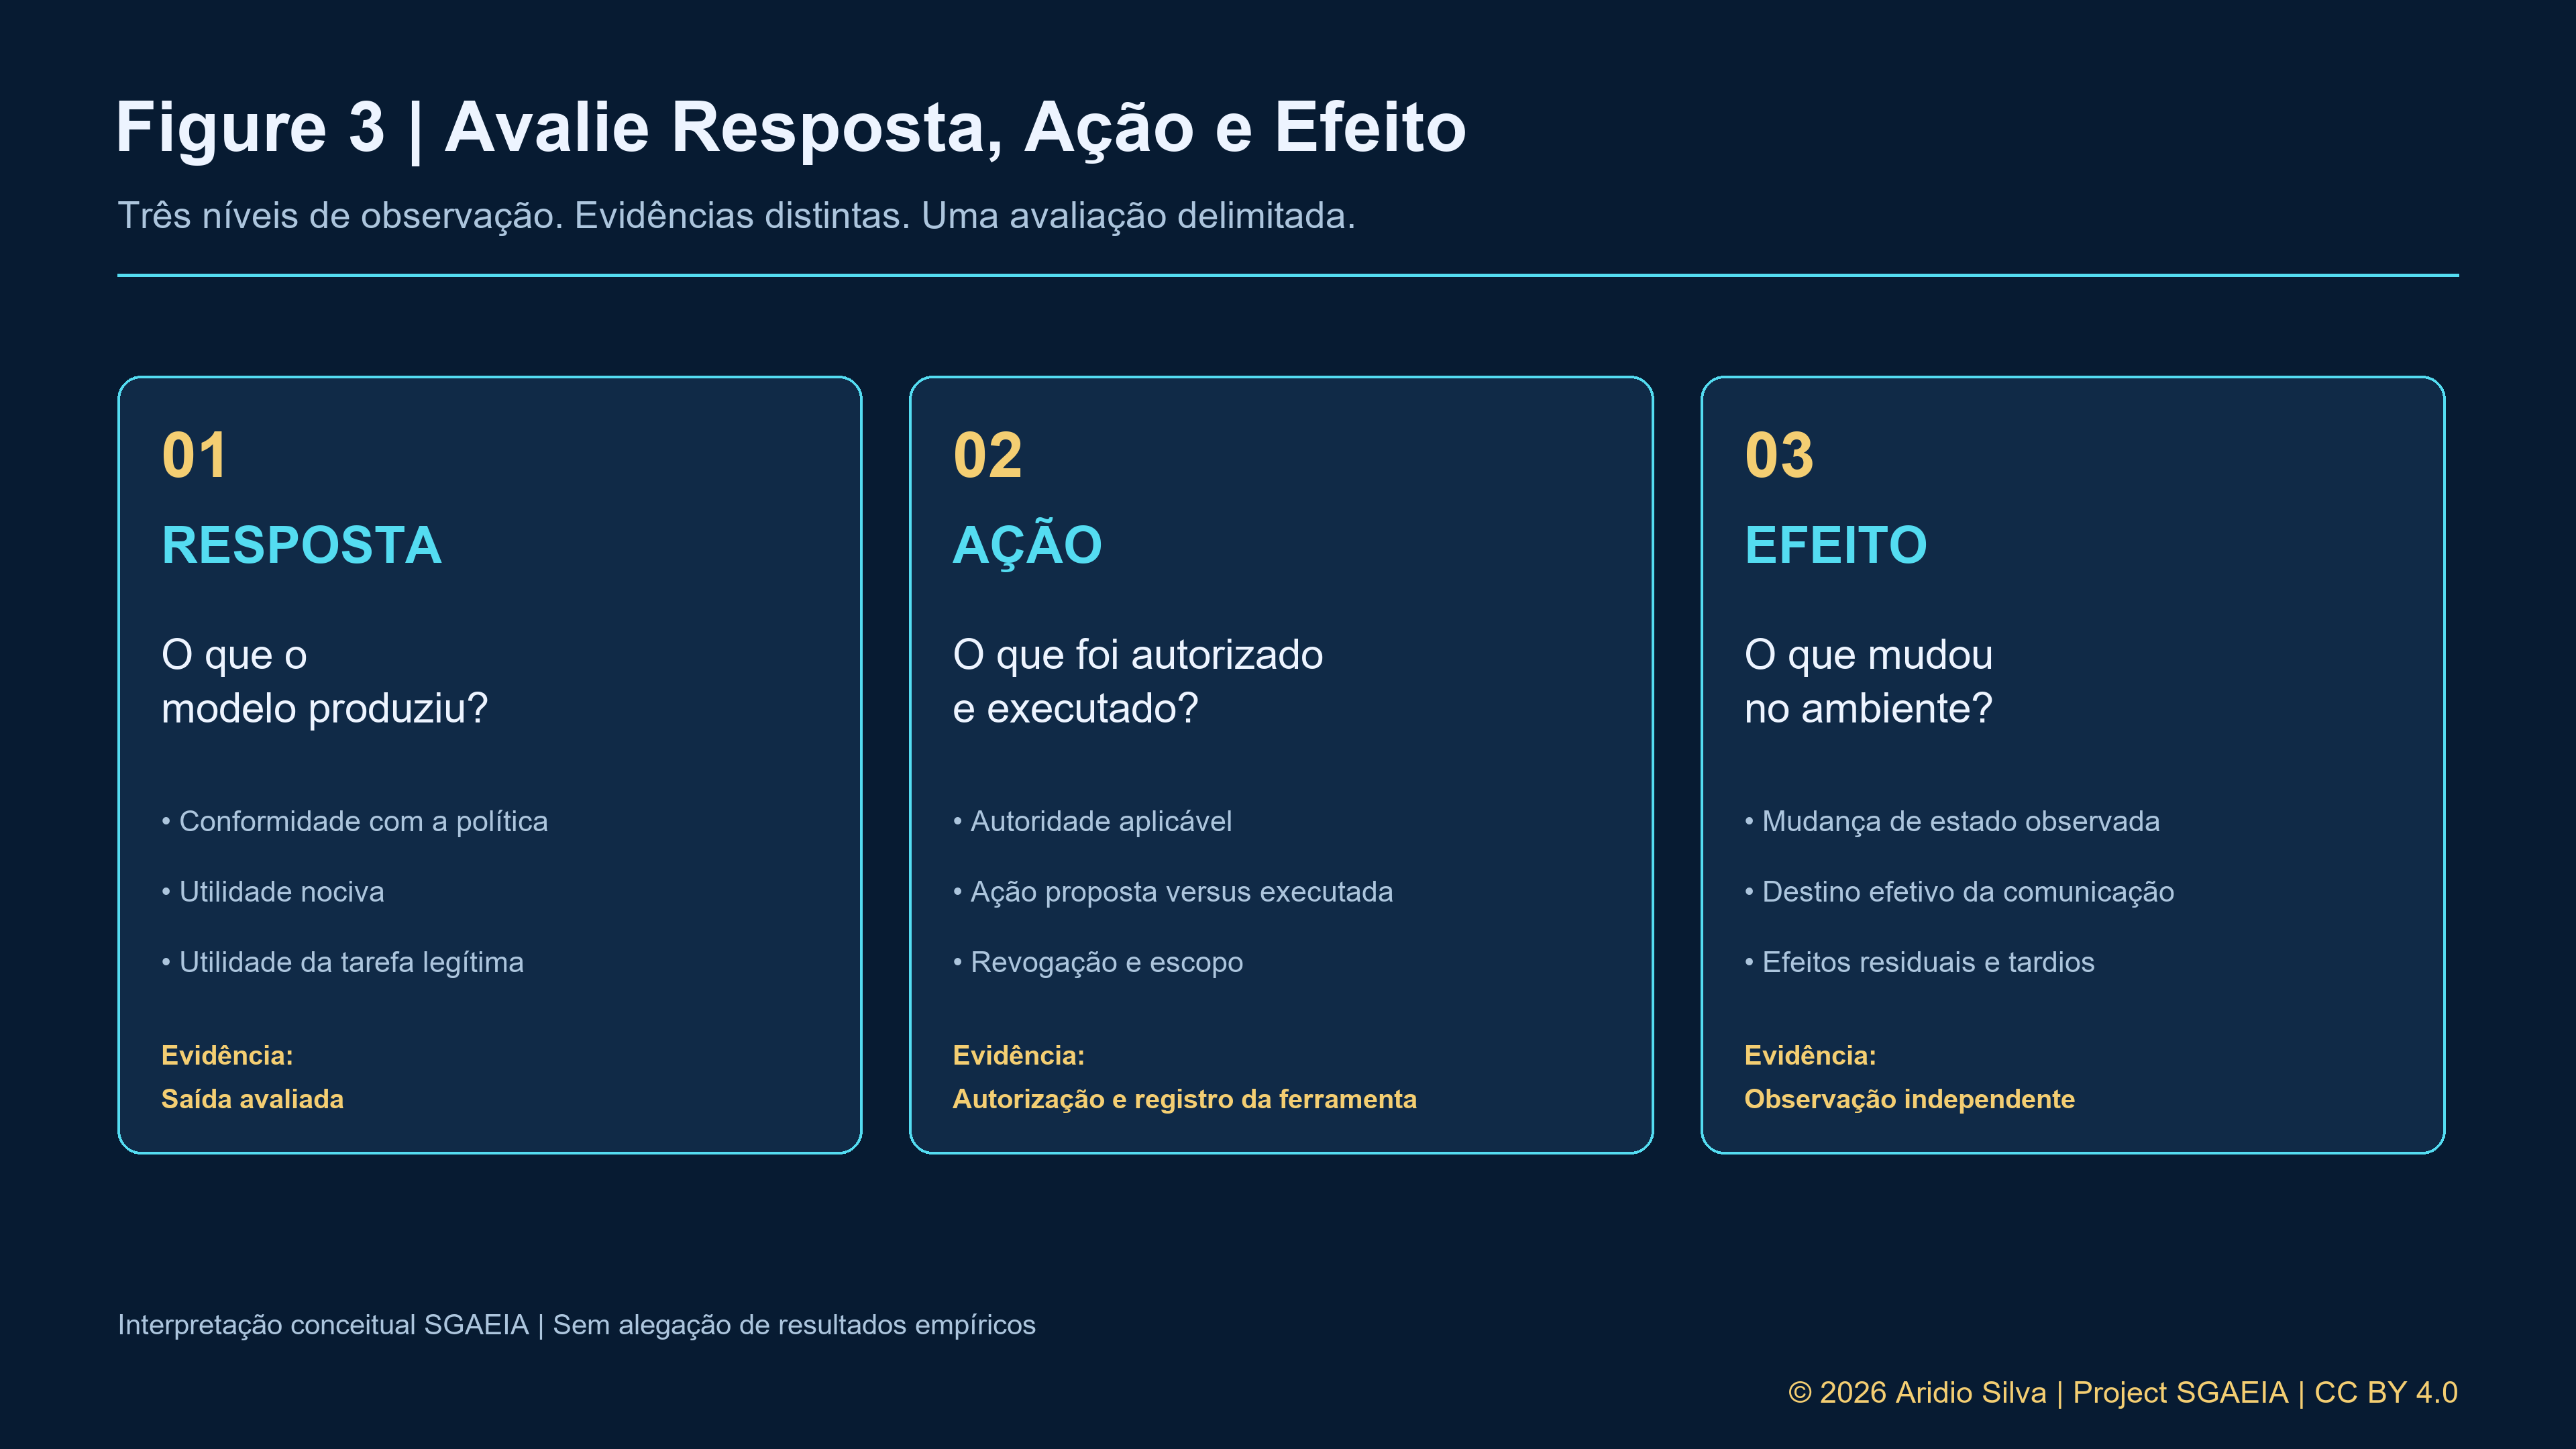
Figure 3 — Três níveis de observação. Resposta, ação e efeito exigem critérios e evidências próprios; a figura apresenta a contribuição analítica não normativa do artigo.
9. O que isso significa para agentes, multiagentes e edge
Em sistemas com múltiplos agentes, o risco relevante inclui a circulação do conteúdo manipulado. Uma conclusão incorreta de um componente pode chegar a outro com aparência de recomendação confiável. Autenticar a origem da mensagem ajuda a identificar quem a enviou, mas não demonstra que seu conteúdo possa conceder novas permissões. Pela ótica do SGAEIA, a pergunta é se a autoridade permanece limitada durante a composição, mesmo quando o significado da mensagem sofre influência adversarial.
A delegação também exige análise temporal. Uma autorização pode ser válida no início da tarefa e deixar de sê-lo antes da operação final. Se uma trajetória continuar após revogação, a ausência de novo jailbreak textual não elimina a falha de governança. Isso justifica estudar ataques compostos, combinando influência por linguagem, estado compartilhado, reutilização de memória e permissões desatualizadas, sempre como cenários de pesquisa a verificar.
No edge, conectividade intermitente e efeitos ciberfísicos acrescentam condições específicas. O problema deixa de ser apenas obter uma nova classificação da mensagem e inclui saber o que pode ser executado com informações de autorização potencialmente desatualizadas. Uma política de operação degradada pode privilegiar continuidade em alguns casos e interrupção em outros, conforme risco e consequência. O artigo não define essa política: identifica o requisito de explicitá-la e avaliar seus efeitos.
A substituição de modelo, ferramenta ou provedor encerra outra presunção de continuidade. Resultados anteriores podem não cobrir o novo conjunto de comportamento, permissões e integrações. Assim, “o modelo é mais capaz” não demonstra “o sistema preserva as propriedades avaliadas”. A hipótese de substituição segura precisa considerar tanto a resistência a ataques quanto a observabilidade da ação e do efeito.
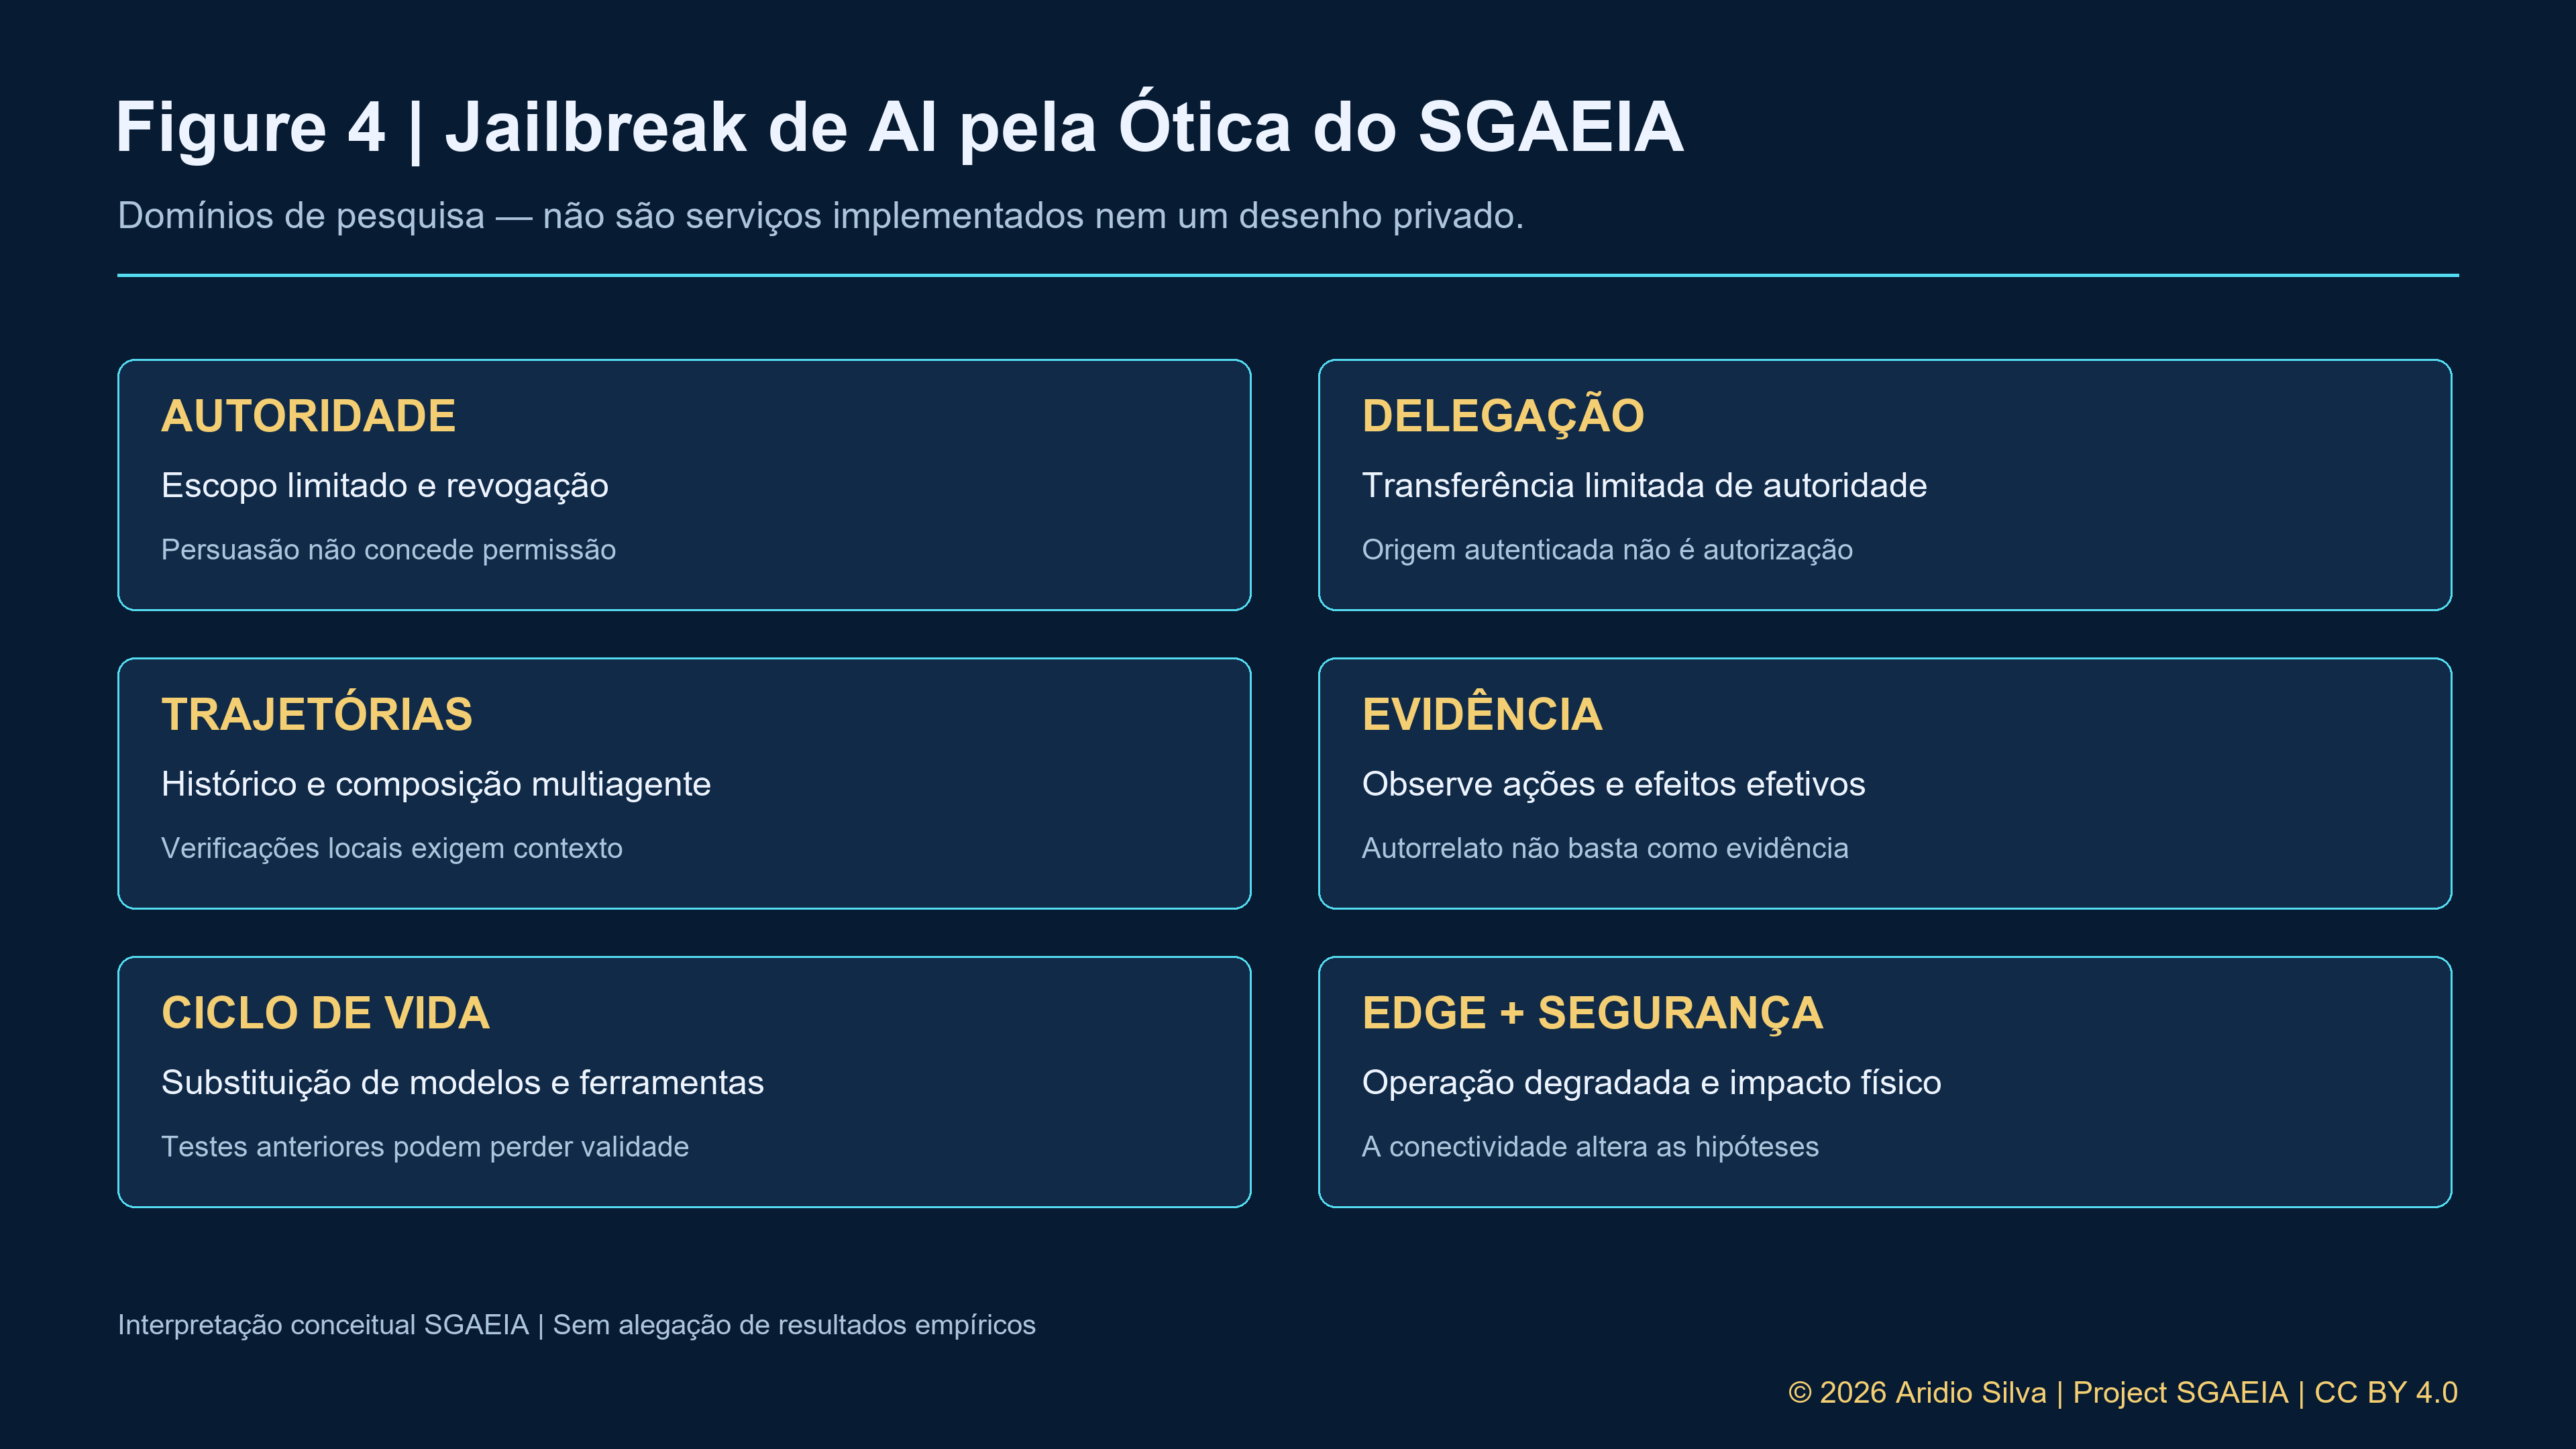
Figure 4 — O alcance da análise SGAEIA. Relações conceituais entre autoridade, delegação, trajetórias, evidência, ciclo de vida e operação distribuída; os domínios não representam seis serviços implementados.
10. Como avaliar sem transformar um placar em garantia
HarmBench padroniza avaliação de comportamentos nocivos e métodos de red teaming; JailbreakBench explicita artefatos, comportamentos, modelos de ameaça e componentes de avaliação. Sua contribuição é melhorar a comparabilidade sob condições declaradas, não certificar sistemas em produção. Alterar prompts de sistema, versões, orçamento de ataque ou julgadores pode mudar o significado do resultado. A comparação responsável exige conservar essas condições ou explicar as diferenças. [21,22]
StrongREJECT enfrenta uma dificuldade importante: uma resposta que aparenta cumprir o pedido pode ser vaga ou inútil para o atacante. Por isso, ausência de recusa não é suficiente para definir sucesso nocivo. AgentDojo amplia a avaliação para tarefas de agentes com ferramentas e ambientes dinâmicos. Os dois trabalhos ajudam a separar qualidade da resposta adversarial e sucesso da tarefa ou do ataque no sistema. [23,24]
A taxa de sucesso do ataque, ou ASR, precisa de um denominador declarado. É possível medir êxito por tentativa ou a proporção de objetivos atingidos após um orçamento de tentativas; os números não respondem à mesma pergunta. Também devem ser separados ataques fixos de ataques adaptativos, além de recusas indevidas, utilidade legítima, latência e custo. Pela síntese proposta, o resultado precisa informar em qual dos três níveis a falha foi observada. [11,21–24]
Uma avaliação candidata para o SGAEIA compararia casos legítimos, ataques isolados e combinações de ameaças, com condições congeladas antes da execução. O relatório deveria distinguir ação proposta, autorizada e executada, além de uma observação independente do efeito. Isso permitiria investigar se o controle preserva limites sob influência adversarial e qual utilidade é perdida para fazê-lo. Não foram executados esses experimentos; nenhuma redução de risco própria é alegada neste artigo.
11. Governança: referências externas e decisões do projeto
O NIST AI 100-2e2025 oferece terminologia para aprendizado de máquina adversarial, enquanto o perfil de AI generativa do AI RMF organiza riscos e ações de gestão. A OWASP acrescenta uma visão de ameaças para aplicações. Esses referenciais ajudam a relacionar problema, decisão, responsabilidade e evidência, mas não tornam uma aplicação conforme apenas porque seus riscos foram listados. O mapeamento precisa considerar o contexto de uso e a qualidade da implementação e da avaliação. [5,12,25]
Neste artigo, não se reproduz uma tabela de códigos de controles ISO ou MITRE sem auditoria específica do texto de origem e da semântica de cada correspondência. Um framework de riscos, uma taxonomia de técnicas e uma norma de sistema de gestão possuem funções distintas. Sua aproximação pode ser útil, mas não demonstra equivalência entre requisitos ou eficácia de controles. Essa cautela protege a rastreabilidade e evita que uma tabela didática seja tomada como evidência de conformidade.
Para o SGAEIA, a governança da pesquisa estabelece uma separação adicional. Uma evidência externa pode confirmar uma direção, expor uma lacuna ou sugerir melhor formalização, mas não autoriza automaticamente alteração de arquitetura. Os findings associados a este artigo preservam essa condição e indicam análise adicional de cobertura e anterioridade. A publicação explica propriedades e perguntas em nível público, mantendo os mecanismos privados fora do texto.
12. Limitações e agenda de pesquisa
A evidência consultada é heterogênea: inclui estudos acadêmicos, preprints, avaliações de fornecedores e documentação de riscos. A revisão não reproduziu ataques e não aferiu segurança de nenhum produto em outubro de 2026. A leitura de páginas primárias e resumos foi suficiente para sustentar o recorte conceitual, mas não substitui auditoria experimental integral dos trabalhos. Métricas detalhadas, provas e afirmações de eficácia exigem leitura técnica aprofundada e, quando apropriado, replicação.
A agenda proposta inclui verificar a anterioridade da síntese resposta–ação–efeito, identificar sua cobertura atual no SGAEIA e definir critérios observáveis para cada nível. Também inclui testar influência persistente, revogação durante trajetórias, comunicação entre agentes e substituição de componentes. A independência do mecanismo de autorização e da observação deve entrar nas hipóteses de avaliação, pois ambos podem ser parcialmente comprometidos. Esses itens permanecem perguntas de pesquisa, sem promoção normativa.
13. Conclusão
O jailbreak merece um artigo da SGAEIA Research Series porque conecta fragilidades de comportamento à questão central da autoridade em sistemas autônomos. A história mostra uma metáfora que migrou de restrições de dispositivos para modelos e, depois, para aplicações que processam dados e executam ações. A literatura documenta ataques persistentes e avanços defensivos, mas não sustenta uma conclusão universal de imunidade ou de impossibilidade de proteção. O resultado precisa sempre ser delimitado pelas condições de ameaça e avaliação.
A contribuição proposta é analisar conjuntamente resposta, ação e efeito. Uma resposta manipulada não demonstra necessariamente uma ação indevida; uma recusa aparentemente correta tampouco comprova a ausência de efeito. Pela ótica do SGAEIA, a pergunta mais produtiva é quais limites de autoridade sobrevivem à influência adversarial e como essa sobrevivência pode ser observada. O artigo oferece uma síntese original de redação e uma direção conceitual de pesquisa, cuja novidade e eficácia ainda devem ser verificadas.
Bibliography / References
Fontes consultadas em 6 de outubro de 2026. Identificadores arXiv correspondem aos registros consultados; não se confundem com DOI editorial de conferência. A matriz separada registra escopo da auditoria e limites de leitura.
[1] GRESHAKE, Kai et al. Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. 2023, arXiv v2. Fonte. DOI: 10.48550/arXiv.2302.12173.
[2] APPLE. Unauthorized modification of iOS. Documentação oficial, sem data editorial explícita na consulta. Fonte.
[3] MILLER, Charlie et al. iOS Hacker’s Handbook. Wiley, abril de 2012. Registro editorial e introdução consultados; livro integral não lido. Editora; introdução.
[4] U.S. COPYRIGHT OFFICE. Exemption to Prohibition on Circumvention of Copyright Protection Systems for Access Control Technologies. Federal Register, 75 FR 43825, 27 jul. 2010. Fonte.
[5] NIST. Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations. NIST AI 100-2e2025, mar. 2025. Fonte. DOI: 10.6028/NIST.AI.100-2e2025.
[6] WILLISON, Simon. Prompt injection attacks against GPT-3. 12 set. 2022. Registro técnico primário de divulgação. Fonte.
[7] PEREZ, Fábio; RIBEIRO, Ian. Ignore Previous Prompt: Attack Techniques For Language Models. 2022. Fonte. DOI: 10.48550/arXiv.2211.09527.
[8] WEI, Alexander; HAGHTALAB, Nika; STEINHARDT, Jacob. Jailbroken: How Does LLM Safety Training Fail? 2023. Fonte. DOI: 10.48550/arXiv.2307.02483.
[9] ZOU, Andy et al. Universal and Transferable Adversarial Attacks on Aligned Language Models. 2023. Fonte. DOI: 10.48550/arXiv.2307.15043.
[10] ANTHROPIC. Many-shot jailbreaking. 2 abr. 2024. Publicação técnica e ligação ao estudo original; evidência de laboratório. Fonte.
[11] HUGHES, John et al. Best-of-N Jailbreaking. 2024, arXiv v2. Fonte. DOI: 10.48550/arXiv.2412.03556.
[12] OWASP GEN AI SECURITY PROJECT. LLM01:2025 Prompt Injection. Edição 2025, página consultada em 2026. Fonte.
[13] QI, Xiangyu et al. Safety Alignment Should Be Made More Than Just a Few Tokens Deep. Preprint 2024; ICLR 2025. Registro; anais. DOI arXiv: 10.48550/arXiv.2406.05946.
[14] DEBENEDETTI, Edoardo et al. Defeating Prompt Injections by Design. 2025, arXiv v2. Pesquisa CaMeL, colaboração acadêmica e industrial. Fonte. DOI: 10.48550/arXiv.2503.18813.
[15] ANTHROPIC. Next-generation Constitutional Classifiers: More efficient protection against universal jailbreaks. 9 jan. 2026. Evidência produzida pelo fornecedor. Fonte.
[16] ARDITI, Andy et al. Refusal in Language Models Is Mediated by a Single Direction. 2024, arXiv v3. Fonte. DOI: 10.48550/arXiv.2406.11717.
[17] JOAD, Faaiz et al. There Is More to Refusal in Large Language Models than a Single Direction. 2026, arXiv v2, atualizado em 15 set. Registro informa aceitação na EMNLP 2026. Registro; texto. DOI: 10.48550/arXiv.2602.02132.
[18] QI, Xiangyu et al. Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To! Preprint 2023; ICLR 2024. Fonte. DOI: 10.48550/arXiv.2310.03693.
[19] RUSSINOVICH, Mark; SALEM, Ahmad; RONAN, Elan. Great, Now Write an Article About That: The Crescendo Multi-Turn LLM Jailbreak Attack. USENIX Security 2025. Fonte.
[20] ZHAO, Shiqian et al. When Memory Becomes a Vulnerability: Towards Multi-turn Jailbreak Attacks against Text-to-Image Generation Systems. USENIX Security 2026, p. 2207–2226. Fonte.
[21] MAZEIKA, Mantas et al. HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal. 2024. Fonte. DOI: 10.48550/arXiv.2402.04249.
[22] CHAO, Patrick et al. JailbreakBench: An Open Robustness Benchmark for Jailbreaking Large Language Models. 2024. Fonte. DOI: 10.48550/arXiv.2404.01318.
[23] SOULY, Alexandra et al. A StrongREJECT for Empty Jailbreaks. 2024. Fonte. DOI: 10.48550/arXiv.2402.10260.
[24] DEBENEDETTI, Edoardo et al. AgentDojo: A Dynamic Environment to Evaluate Prompt Injection Attacks and Defenses for LLM Agents. 2024. Fonte. DOI: 10.48550/arXiv.2406.13352.
[25] NIST. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1, jul. 2024. Fonte. DOI: 10.6028/NIST.AI.600-1.
About the Author
Aridio Silva é pesquisador independente no Brasil e trabalha com arquitetura, segurança, governança e confiabilidade de sistemas de inteligência artificial autônomos e distribuídos.
Sua pesquisa concentra-se em Agentic AI, Multi-Agent Systems, Edge AI, AI Security, Zero Trust, Security-by-Design, AI Governance, Spec-Driven Development e assurance contínua de segurança.
Ele é o criador e pesquisador principal do SGAEIA — Secure Governed Autonomous Edge Intelligence Architecture, uma iniciativa de pesquisa que investiga fundamentos arquiteturais para sistemas autônomos de AI seguros, governados, auditáveis e confiáveis em ambientes distribuídos entre edge e cloud.
Research Profiles
Aridio Silva Independent Researcher — Brazil
- ORCID: https://orcid.org/0009-0008-2411-6995
- Google Scholar: https://scholar.google.com/citations?user=rPn5O48AAAAJ
- Zenodo — SGAEIA Community: https://zenodo.org/communities/sgaeia
- OpenAIRE: https://explore.openaire.eu/search/find?fv0=Aridio%20Silva&f0=q
- Medium: https://medium.com/@aridiosilva
- GitHub: https://github.com/aridiosilva
- LinkedIn: https://www.linkedin.com/in/aridio-silva-74997111/
- SGAEIA Repository: https://github.com/aridiosilva/SGAEIA
- SGAEIA Research Artifact / DOI: https://doi.org/10.5281/zenodo.22557796
- Homepage: https://aridiosilva.com
- SGAEIA Homepage: https://aridiosilva.com/sgaeia
- SGAEIA LinkedIn: https://www.linkedin.com/company/sgaeia/
- Kaggle: https://www.kaggle.com/aridiosilva2
- DEV Community: https://dev.to/aridiosilva
- Academia.edu: https://independent.academia.edu/AridioSilva
Figures
A capa original fornecida pelo autor permanece um material separado, com seus direitos de origem preservados. As quatro figuras adicionais são numeradas sequencialmente e apresentam metadados de criador, copyright, projeto, título, descrição e licença. Figures 1–2 foram geradas com assistência de AI; Figures 3–4 foram desenhadas programaticamente para precisão de rótulos e resolução nativa 4K. As edições PT e EN preservam o mesmo conteúdo conceitual. Todas têm atribuição visível © 2026 Aridio Silva | Project SGAEIA | CC BY 4.0. Os metadados descritivos não constituem assinatura C2PA.
License
Salvo indicação em contrário, o texto e as ilustrações conceituais originais deste artigo são licenciados sob a Creative Commons Attribution 4.0 International — CC BY 4.0.
© 2026 Aridio Silva. É permitido compartilhar e adaptar este trabalho para qualquer finalidade, desde que seja atribuída a autoria apropriadamente. Conteúdo e imagens anteriores do autor e fontes de terceiros preservam suas próprias condições de licença.
O artefato de pesquisa de software SGAEIA permanece sujeito à sua própria Apache License 2.0.
Autonomous AI. Governed by Design. Trusted by Evidence.
Series continuity
Este é o artigo 17 da SGAEIA Research Series, conforme atribuição do autor em 6 de outubro de 2026. Desenvolve autoridade limitada e revogável, Evidence-as-Code e a passagem da capacidade do modelo à ação governada. O DOI do Zenodo e os endereços de distribuição permanecem pendentes.
Document Record
Created: 2026-10-06 10:46 BRT
Last Updated: 2026-10-06 12:25 BRT
Timezone: America/Sao_Paulo (UTC−03:00)
Document Status: EDIÇÃO LOCAL DA HOMEPAGE — Artigo 17; implantação e DOI pendentes
Normative Status: artigo público conceitual, não normativo; sem experimentos próprios
Copyright: © 2026 Aridio Silva
Proveniência: estudo do autor, infográfico e fontes externas; redação assistida por AI, sob revisão autoral
Idioma: PT somente para o artigo do Medium; edição EN para os demais canais, por solicitação explícita do proprietário.
English companion edition: 2026-10-06-1212-SGAEIA-AI-Jailbreaks-from-restrictions-to-authority_EN.md
Suggested citation
Silva, Aridio. (2026). Jailbreak de AI: da quebra de restrições à governança da autoridade. SGAEIA Research Series, Article 17. https://aridiosilva.com/publications/artigo17/pt/. Zenodo DOI pending.
Zenodo will provide the persistent source for archived files, version, license and citation data after deposit. Medium and DEV article URLs are pending.