Observabilidade, avaliação e evidência para a governança de agentes autônomos no edge
SGAEIA Research Series — Article 18
Aridio Silva
Independent Researcher, Brazil
Creator of SGAEIA — Secure Governed Autonomous Edge Intelligence Architecture
ORCID: 0009-0008-2411-6995
Copyright: © 2026 Aridio Silva | Licença: CC BY 4.0
Resumo
Em outubro de 2026, rastrear em detalhe cada passo de um ou mais agentes de AI já é possível nas principais plataformas, mas o ecossistema ainda não oferece uma semântica estável e uniforme. Este trabalho combina três contribuições: um enquadramento conceitual das perguntas de observabilidade; uma revisão comparativa de 13 plataformas, com versões verificadas em 10/10/2026; e uma interpretação não normativa das implicações para o SGAEIA em ambientes multiagentes distribuídos e de edge. Os resultados mostram que o trace reconstrói o caminho da execução, mas não demonstra a correção do resultado; que recursos essenciais permanecem em beta, preview ou Development; e que políticas divergentes de captura de conteúdo criam riscos diretos de privacidade, governança e continuidade da evidência. A principal conclusão é que tracing, avaliação e evidência governada devem operar como funções complementares: observar a execução, julgar o resultado e preservar uma base verificável para auditoria e assurance.
Palavras-chave: AI; agentes de IA; observabilidade; tracing distribuído; OpenTelemetry; spans; avaliação de agentes; sistemas multiagente; edge AI; SGAEIA.
1. Introdução
Quando um agente de IA é ativado, o operador precisa saber o que ele realmente fez: se concluiu a tarefa, onde errou ou se desviou, quanto tempo e quanto custo consumiu, e quais passos executou. Agentes decidem em tempo de execução quais ferramentas chamar e a quem delegar, de modo que o comportamento é não determinístico e a depuração por logs lineares é insuficiente. A resposta da engenharia é emprestar o tracing distribuído de sistemas de microsserviços e adaptá-lo ao ciclo do agente.
Este artigo responde a quatro questões de pesquisa:
- QP1. Como o conceito de trace e span se aplica à execução de um ou mais agentes?
- QP2. Como responder, a partir desses sinais, às perguntas de conclusão, erro, desvio, duração e passos executados?
- QP3. Quais plataformas oferecem esses recursos hoje, com que maturidade, pontos fortes, limites e lacunas?
- QP4. Como tracing, avaliação e preservação de evidências se relacionam com a governança de agentes distribuídos no edge sob a perspectiva conceitual do SGAEIA?
O escopo cobre os runtimes de cinco fabricantes (Anthropic, OpenAI, Google, Microsoft, AWS), sete plataformas independentes e o padrão OpenTelemetry. O modelo de IA, sozinho, não fornece esse registro: ele vem da camada que executa o agente (SDK, framework ou plataforma de hospedagem).
2. Fundamentos: trace, span e sessão
Nesse contexto, um span é um trecho rastreado da execução: a unidade de observabilidade que registra uma etapa específica do trabalho do agente. Cada passo relevante gera um span próprio, o que permite rastrear e medir cada ação individualmente. Os tipos mais comuns são:
- Chamada ao modelo: o agente envia um prompt ao LLM e recebe a resposta. O span mede tempo, tokens e, conforme a plataforma, o prompt enviado.
- Uso de ferramenta: busca na web, consulta a banco de dados, execução de código ou chamada de API. O span registra qual ferramenta, os parâmetros e o resultado.
- Handoff: transferência de controle de um agente para outro (por exemplo, de um agente de triagem para um especialista).
O conceito vem do tracing distribuído (OpenTelemetry). Um trace é a jornada completa de uma operação, e os spans são as etapas dentro dela. Cada span carrega horário de início e fim (daí a duração), referência ao span pai (daí a hierarquia) e, nas plataformas que registram, status e eventos. No OpenAI Agents SDK, por exemplo, o span tem started_at, ended_at, parent_id e dados específicos do tipo de passo (R4); na AWS, também traz status e eventos (R15).
2.1 Três nuances que afetam a leitura de um trace
- Trace nem sempre é a tarefa inteira. No OpenAI Agents SDK, o trace é uma operação ponta a ponta e várias execuções podem ser agrupadas por
group_id(R4). No AgentCore, o trace é um único ciclo de requisição e resposta, e uma sessão agrupa vários traces (R15). - Handoff nem sempre é um tipo de span próprio. O OpenAI Agents SDK tem span dedicado de handoff (R4). No padrão OTel, as operações definidas são
create_agent,invoke_agenteexecute_tool(R18), e um subagente aparece como outro spaninvoke_agentaninhado (R19). A Microsoft acrescentou um span específico para a comunicação entre agentes (R11). - Spans não se limitam a modelo, ferramenta e handoff. Existem spans de guardrail, de turno e até de espera por permissão: o Claude Agent SDK tem um span filho para o tempo em que a ferramenta aguardou aprovação do usuário (R1).
2.2 Estrutura em árvore
Os spans formam uma árvore, não uma lista plana. A Figura 1 representa a passagem de uma sessão para traces e spans aninhados, incluindo chamadas ao modelo, ferramentas e subagentes. Essa hierarquia permite medir duração, reconstruir causalidade operacional e localizar falhas sem reduzir a execução a uma sequência linear de logs.
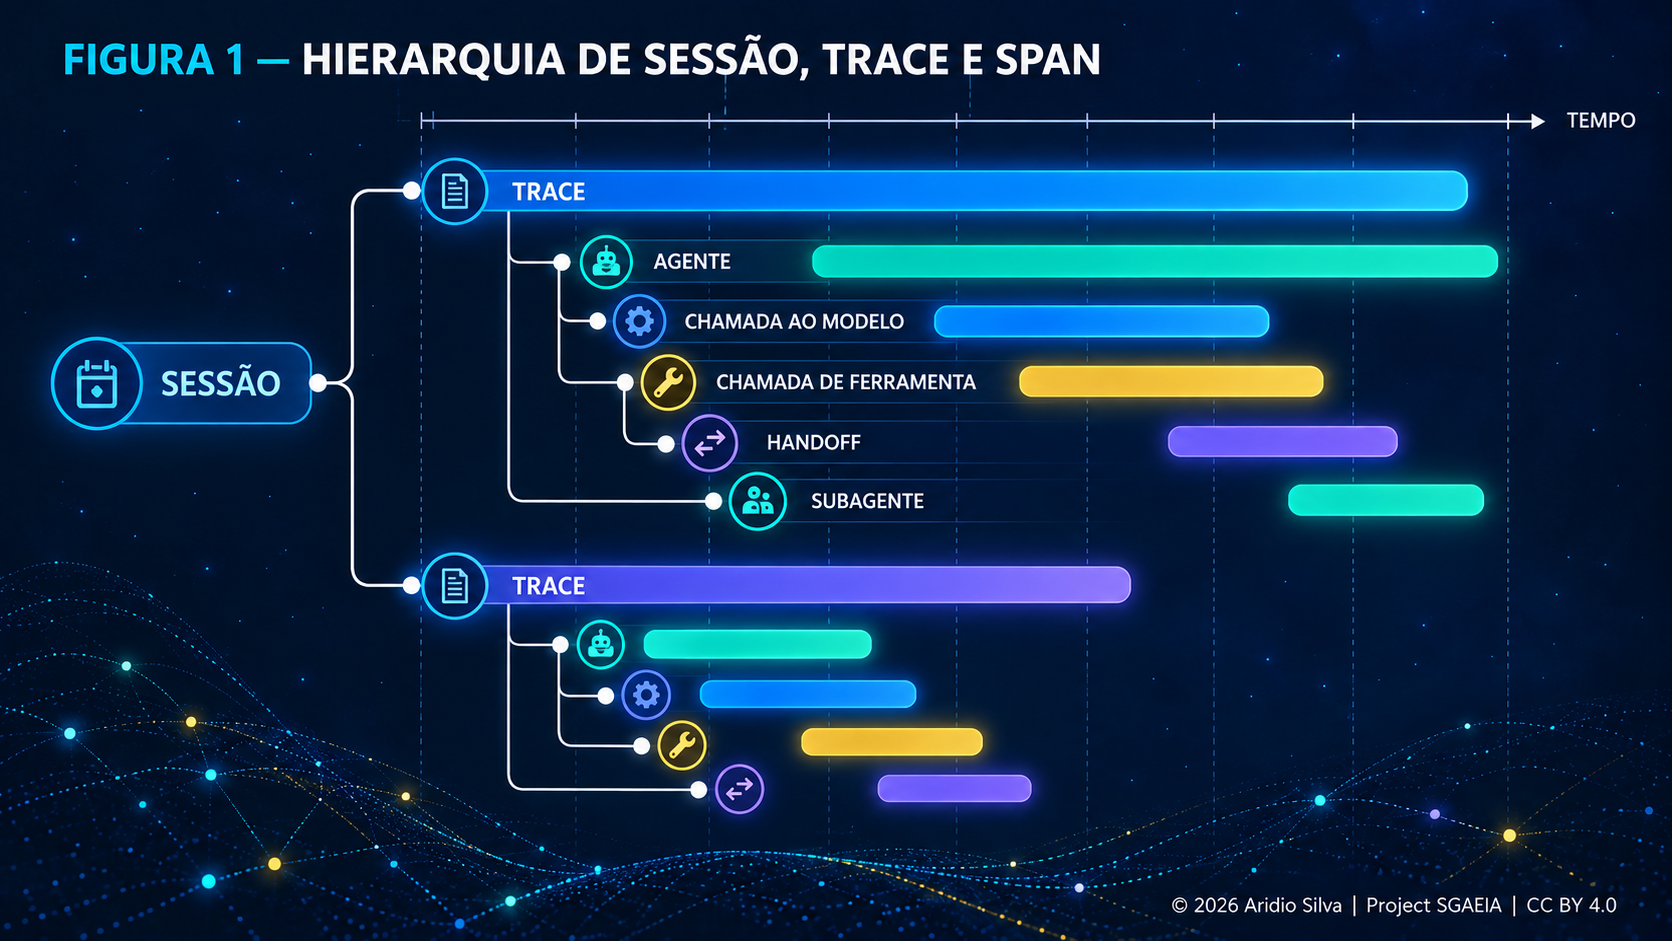
Figura 1 — Da sessão aos spans verificáveis. Uma sessão pode agrupar vários traces; cada trace organiza spans de agentes, modelos, ferramentas e handoffs em uma estrutura causal. © 2026 Aridio Silva | Project SGAEIA | CC BY 4.0.
No padrão OTel, o handoff para o agente de pagamento aparece como um subagente aninhado (invoke_agent); no OpenAI Agents SDK ele teria um span próprio de handoff.
3. Perguntas de observabilidade e como respondê-las
A tabela associa cada pergunta operacional aos sinais que as plataformas fornecem. O ponto central é que o status final de uma execução e a correção do resultado são coisas distintas.
| Pergunta | Sinal a observar | Observação |
|---|---|---|
| Concluiu a tarefa? | Status final da execução e, separadamente, verificação do resultado (testes, validação de esquema, avaliador ou revisão humana) | Execução sem exceção prova apenas que o agente não quebrou |
| Houve erros ou desvios? | Spans com erro, falhas de ferramenta, limites estourados (turnos, orçamento), permissões negadas, guardrails acionados | Desvio exige comparar o trace com o comportamento esperado |
| Quando terminou e quanto levou? | Duração do run e de cada span; tokens e custo | Custo costuma ser derivado de tokens e preço do modelo |
| O que fez em cada passo? | Trace hierárquico: ferramenta, argumentos, resultado | Conteúdo pode estar desligado por padrão (seção 9) |
| Quem pediu e o que foi autorizado? | Atributos de usuário final, eventos de decisão de permissão | Base para auditoria e SIEM |
| Houve loop ou desperdício? | Número de turnos e de chamadas por run | Métricas de chamadas de ferramenta e inferência existem no padrão OTel (R19) |
3.1 Conclusão da tarefa
No Claude Agent SDK, a mensagem final de resultado traz subtype, is_error, número de turnos, duração e custo, com subtypes como success, error_max_turns e error_during_execution (R36, fonte de terceiros; confirmar na referência oficial do SDK). Esses campos dizem como a execução terminou, não se o objetivo foi atingido.
Falhas de conteúdo, em que o agente entrega com confiança uma resposta errada, muitas vezes não disparam nenhum status de erro (R37). Por isso a verificação independente do resultado é indispensável. A OpenAI formaliza isso com trace grading, que atribui notas a traces para identificar erros em escala (R5).
3.2 Erros e desvios
Erros aparecem como status de span, eventos de erro de API e resultados de ferramenta com falha. Desvios (o agente fez algo diferente do esperado) aparecem em eventos de permissão, guardrails e na comparação do caminho executado com o esperado. No Claude Code, cada decisão de permissão é registrada como evento com a origem da decisão (R2), o que serve de trilha de auditoria.
4. Metodologia, fontes e limitações
O levantamento foi feito em 10/10/2026 com três fontes:
- Registros de pacotes. A versão atual de cada SDK foi lida diretamente nas APIs do PyPI e do npm (versão estável mais recente e data de publicação).
- Documentação oficial de cada fabricante e plataforma, priorizada sempre que disponível.
- Fontes secundárias (blogs e comparativos), usadas apenas para pontos sem cobertura oficial e sinalizadas no texto como "terceiros". Comparativos publicados por concorrentes foram tratados com cautela.
Critérios de leitura da matriz comparativa (seção 8): ✔ significa recurso confirmado na documentação consultada; ◐, parcial ou condicionado; —, não encontrado nos documentos consultados. A ausência de um recurso na matriz não prova que ele não exista.
Limitações. Para serviços SaaS (Datadog, LangSmith, Foundry, AgentCore, Managed Agents) não existe uma versão única da plataforma; a coluna de versão indica o SDK. Preços foram excluídos por mudarem com frequência. Não foram aprofundados W&B Weave (0.53.12), Comet Opik (2.2.96) e AgentOps (0.4.21, última publicação em 29/08/2025). O estado "beta" ou "GA" reflete a documentação na data da consulta e pode mudar.
Validação da bibliografia. Cada referência foi aberta ou recuperada em 10/10/2026 e comparada com a afirmação que sustenta. A marcação [A], [B] ou [C] aparece na seção Referências. Na validação, algumas afirmações foram reatribuídas a fontes mais precisas (R17, R43, R44, R45, R46 e R47) e uma teve a confiança reduzida (avaliação do Logfire, marcada ◐ na matriz).
5. Padrão aberto: OpenTelemetry GenAI
As convenções semânticas GenAI do OpenTelemetry são o candidato a linguagem comum entre runtimes e backends, mas seguem em Development: todas as spans, métricas e atributos gen_ai.* carregavam essa marca em meados de julho de 2026 (R20), e uma página de setembro de 2026 mantém o status (R19). Em 12/06/2026 (v1.42.0), as convenções GenAI foram movidas para um repositório próprio, semantic-conventions-genai, para iterar mais rápido (R19).
O que já está definido:
- Operações:
create_agent,invoke_agenteexecute_tool(R18). Recomenda-se que o nome do span de agente sejainvoke_agentseguido do nome do agente, quando disponível. - Atributos: identificador, nome e versão do agente, nome e identificador da ferramenta (R19).
- Métricas: duração do run de agente, número de chamadas de ferramenta e número de chamadas de inferência por run (R19).
O impacto prático é a portabilidade: o Datadog aceita traces compatíveis com OTel GenAI 1.37 ou superior (R28), o MLflow ingere e exporta essas convenções (R33) e o Google ADK as implementa nativamente (R7). O risco, por outro lado, é que status Development significa que nomes podem mudar entre versões, e o Claude Agent SDK emite spans próprios com prefixo claude_code. (seção 6.1).
6. Plataformas de fabricantes
6.1 Anthropic (Claude Agent SDK, Claude Code e Managed Agents)
- Recursos. O Agent SDK roda o CLI do Claude Code como processo filho, e o CLI exporta spans por interação, chamada ao modelo e ferramenta, além de métricas de tokens e custo e eventos estruturados (R1). Subagentes aparecem aninhados sob a ferramenta que os acionou, o contexto W3C é propagado entre a aplicação e o agente, e eventos de decisão de permissão podem alimentar um SIEM, atribuídos ao usuário final (R1). No Managed Agents, o Console traz uma visão de tracing cronológica (conteúdo, timestamps, tokens), e eventos de sessão, span e agente chegam pela API (R3).
- Pontos fortes. OTLP aberto, sem backend obrigatório. O conteúdo lido e escrito pelo agente não é registrado por padrão, apenas a estrutura (R1).
- Fracos e limites. Traces em beta (nomes de spans podem mudar), falhas de exportação silenciosas por padrão e spans de hook que exigem configuração beta extra (R1). O Managed Agents exige o header beta
managed-agents-2026-04-01(R3). - O que não faz. O SDK não gera telemetria própria nem traz interface de análise (R1). Não foram encontrados avaliadores nativos sobre traces nos documentos consultados.
6.2 OpenAI (Agents SDK)
- Recursos. Tracing ativo por padrão, com spans para run, tarefa, turno, agente, geração, ferramenta, guardrail, handoff e áudio, e
group_idpara ligar traces de uma conversa (R4). O dashboard (Logs > Traces) alimenta o trace grading e os evals (R5, R6). Cerca de trinta processadores externos estão listados (R4). - Pontos fortes. Zero configuração, hierarquia rica em handoffs e guardrails e tracing gratuito inclusive com modelos de outros fornecedores (R4).
- Fracos e limites. Indisponível sob Zero Data Retention. Entradas e saídas são capturadas por padrão. Uma redação feita em processador separado não impede o exportador padrão de enviar dados caso ela falhe. A exportação é em lote, com
flush_traces()para entrega imediata (R4). - O que não faz. O formato nativo é próprio; a ponte para OTel depende de instrumentadores de terceiros, como o openinference-instrumentation-openai-agents (R26).
6.3 Google (ADK e Vertex AI Agent Engine)
- Recursos. O ADK implementa as convenções GenAI do OTel: a execução do agente é o span raiz, com filhos para LLM e ferramentas, e o contexto é propagado entre processos (R7). No Agent Engine, os traces vão para o Cloud Trace, com tempos de resposta e operações executadas (R9). A observabilidade está disponível em Python, Go e Kotlin (R8).
- Pontos fortes. OTel nativo e backend gerenciado com nível gratuito (R9).
- Fracos e limites. O Cloud Logging descarta a entrada que excede o tamanho máximo de log (R10).
- O que não faz. O Cloud Trace é um visualizador de traces; avaliação contínua e painéis específicos de agentes não apareceram nos documentos consultados.
6.4 Microsoft (Foundry e Agent Framework)
- Recursos. Tracing GA para agentes de prompt e hospedados e preview para workflows e agentes externos, com armazenamento no Application Insights (R11). A Microsoft criou, com a Outshift (Cisco), convenções OTel para observabilidade multiagente [R44] (R11). O Agent Framework emite spans
invoke_agent, e agentes customizados podem ser registrados no portal com o mesmo ID OTel (R14). - Pontos fortes. O mais avançado em semântica multiagente e integrado ao Azure Monitor.
- Fracos e limites. Custo conforme volume e retenção do Application Insights (R11), exigência do papel Log Analytics Reader para consulta (R12) e status divergente entre páginas: o quickstart de agente hospedado ainda fala em preview (R13).
- O que não faz. Fora do Azure, é preciso exportar via OTel para outro backend.
6.5 AWS (Bedrock AgentCore)
- Recursos. Hierarquia sessão, trace e span; os traces incluem ferramentas com entrada, saída e tempo, além de erros (R15). Desde 23/07/2026, spans, prompts e logs ficam em um único grupo de logs por agente, com escopo IAM e criptografia CMK por agente; agentes criados a partir de 20/07/2026 usam o modo unificado por padrão (R17). Também cobre agentes hospedados fora do AgentCore (R15).
- Pontos fortes. Os dados ficam na conta do cliente, com a governança nativa da AWS.
- Fracos e limites. Spans de agente exigem instrumentação com ADOT, e por padrão só a memória gera spans (R15). É preciso habilitar o CloudWatch Transaction Search (R16).
- O que não faz. Não foi encontrada avaliação de qualidade integrada nos documentos consultados.
7. Plataformas independentes
7.1 LangSmith
- Recursos. Runs equivalem a spans, agrupados em projetos, com threads definidas por metadata e um assistente de análise (Polly) (R21). Ingere OTel e oferece regiões na UE e na APAC (R22). Inclui tracing distribuído, amostragem, prevenção de dados sensíveis, custo por token, dashboards e avaliação online (R23). Retenção de 400 dias no SaaS (R21).
- Fracos e limites. Há um limite de runs por trace; excedido, os adicionais são rejeitados (R21). A integração com o OpenAI Agents SDK é só Python (R23). Comparativos de terceiros indicam self-host restrito ao plano enterprise (R41).
7.2 Langfuse
- Recursos. Núcleo sob licença MIT, com self-host em qualquer plano, observações aninhadas, sessões, grafo de agentes e filas de anotação humana; roda sobre ClickHouse (R24). A v4 prioriza ingestão por OTLP (R45); o modelo de dados inclui sessões e metadados (R25).
- Fracos e limites. Uma análise de terceiros observa que o código aberto elimina a licença, mas não o custo de operar (R38). Há relato de terceiros de quebras na migração do SDK v3 para v4.
7.3 Arize Phoenix e AX
- Recursos. Traces em OTel com OpenInference (tipos de span LLM, Tool, Agent, Retriever); o AX acrescenta datastore proprietário e avaliações online (R27, terceiros). O Phoenix inclui evals, datasets, experimentos e gestão de prompts e tem instrumentadores para OpenAI Agents, LangChain e DSPy (R26).
- Fracos e limites. A licença Elastic 2.0 (R26) permite uso interno amplo, mas restringe oferecer o software como serviço gerenciado (R46, terceiros). A biblioteca de evals em TypeScript está em alpha (R26).
7.4 Datadog (Agent Observability)
- Recursos. Aceita OTel GenAI 1.37 ou superior; span links alimentam um Execution Graph para pipelines multiagente (R28). Monitora taxa de erro, latência, custo e decisões do agente, com auto-instrumentação para OpenAI Agents SDK, LangGraph e CrewAI (R29).
- Fracos e limites. Links para spans de outro trace são armazenados, mas não desenhados (R28). O produto não é suportado nos sites gov (R29). É oferecido apenas como SaaS.
7.5 Braintrust
- Recursos. Avaliação offline e online sobre logs reais (R32), integrações com Claude Agent SDK, OpenAI Agents e Google ADK e mascaramento de dados (R31).
- Fracos e limites. O self-host é híbrido, e a documentação descreve telemetria enviada de volta ao plano de controle da empresa (R30). Um terceiro aponta que o custo cresce com o uso de scoring (R42).
7.6 MLflow Tracing
- Recursos. Totalmente compatível com OTel, ingere e exporta as convenções GenAI e tem um SDK enxuto para produção (R33). Mais de 30 integrações via autolog (R34).
- Fracos e limites. É preciso chamar o autolog explicitamente para cada integração (R34).
7.7 Pydantic Logfire
- Recursos. Camada sobre OTel com SDKs Python e JavaScript (R43), integração com o Pydantic AI e com um gateway de IA (R35, R47). Avaliações e gestão de prompts aparecem em documentação espelhada por um buscador, mas não foram confirmadas em página oficial aberta; por isso a marca ◐ na matriz.
- Fracos e limites. Produto comercial (R47) com self-host apenas no plano Enterprise (R43).
8. Análise comparativa
8.1 Versões e maturidade
Versões são as estáveis mais recentes nos registros PyPI e npm em 10/10/2026 (R40). A numeração 0.x indica SDK ainda anterior à versão 1.0.
| Plataforma | Versão atual | Publicação | Estado de maturidade |
|---|---|---|---|
| Claude Agent SDK / Claude Code | py 0.2.165 · npm 0.3.296 · CLI 2.1.296 | 08–09/10/2026 | Traces e telemetria em beta; numeração 0.x |
| Claude Managed Agents | API, sem pacote | — | Beta (header managed-agents-2026-04-01) |
| OpenAI Agents SDK | py 0.23.1 · JS 0.20.0 | 02/10 e 08/10/2026 | Tracing ativo por padrão; numeração 0.x |
| Google ADK | py 2.11.0 · JS 2.2.1 | 02/10 e 06/10/2026 | Major 2.x; telemetria nativa |
| Microsoft Agent Framework | py 1.21.0 (azure-ai-projects 2.8.0) | 08/10 e 05/10/2026 | Tracing GA para agentes de prompt e hospedados; preview para workflows e externos |
| AWS Bedrock AgentCore | py 1.24.1 | 07/10/2026 | Em evolução (log unificado por agente em 23/07/2026) |
| LangSmith | py 0.14.7 · JS 0.10.11 | 09/10/2026 | SaaS comercial; SDKs em 0.x |
| Langfuse | py 4.17.0 · JS @langfuse/tracing 5.13.1 | 05/10 e 07/10/2026 | Plataforma v4 (OTLP-first) |
| Arize Phoenix | 20.20.0 | 09/10/2026 | Lançamentos frequentes; licença ELv2 |
| Datadog | ddtrace 4.15.6 | 08/10/2026 | SaaS |
| Braintrust | py 0.45.0 · JS 3.37.2 | 07/10 e 09/10/2026 | SaaS e híbrido |
| MLflow Tracing | 3.17.0 | 07/10/2026 | Código aberto |
| Pydantic Logfire | 5.1.1 | 25/09/2026 | Produto comercial |
| OpenTelemetry (Python SDK) | 1.45.1 | 06/10/2026 | Convenções GenAI em Development |
8.2 Matriz de recursos
Legenda: ✔ confirmado na documentação consultada; ◐ parcial ou condicionado; — não encontrado nos documentos consultados.
| Plataforma | Passos (LLM e ferramenta) | Multiagente | OTel | Sessões e threads | Avaliação sobre traces | Hospedagem |
|---|---|---|---|---|---|---|
| Claude Agent SDK | ✔ (beta) | ✔ subagentes | ✔ OTLP | ✔ session.id |
— | Backend à sua escolha |
| Claude Managed Agents | ✔ (Console) | — | — | ✔ | — | Gerenciado |
| OpenAI Agents SDK | ✔ | ✔ handoffs | ◐ via terceiros | ✔ group_id |
✔ trace grading | Dashboard OpenAI |
| Google ADK e Agent Engine | ✔ | ◐ | ✔ nativo | — | — | Cloud Trace |
| Microsoft Foundry e Agent Framework | ✔ | ✔ semântica própria | ✔ | — | ◐ | Application Insights |
| AWS AgentCore | ✔ (com ADOT) | ✔ | ✔ ADOT | ✔ | — | CloudWatch |
| LangSmith | ✔ | ✔ | ✔ | ✔ threads | ✔ | SaaS; enterprise |
| Langfuse | ✔ | ✔ grafo | ✔ | ✔ | ✔ | SaaS; MIT |
| Phoenix e AX | ✔ | ✔ | ✔ | — | ✔ | ELv2; SaaS |
| Datadog | ✔ | ✔ grafo | ✔ | — | ◐ experimentos | SaaS |
| Braintrust | ✔ | ✔ | ✔ | — | ✔ online e offline | SaaS; híbrido |
| MLflow | ✔ | ✔ | ✔ | — | — | OSS ou gerenciado |
| Logfire | ✔ | ✔ | ✔ | — | ◐ | SaaS; enterprise |
Notas: a célula de avaliação da Microsoft é parcial porque a avaliação contínua e a visão "AI agents" do Application Insights (preview) vêm de um blog de terceiros (R39). As células "—" refletem ausência na documentação consultada, não ausência do recurso.
9. Discussão: lacunas, riscos e boas práticas
Convergência incompleta. Todos os fabricantes caminham para OTel, mas com dialetos: o Claude emite spans claude_code.*, o OpenAI Agents SDK usa formato próprio com ponte por terceiros, o Google e a Microsoft seguem as convenções GenAI e a AWS depende de ADOT. Quem mistura fabricantes precisa de um coletor OTel e de um backend que normalize esses dialetos.
Maturidade desigual. Os recursos mais valiosos para agentes (traces do Claude Agent SDK, tracing de workflows do Foundry, convenções GenAI) estão em beta, preview ou Development. Decisões de longo prazo devem prever migração de nomes de spans e atributos.
Privacidade e conteúdo. O Claude Agent SDK não registra conteúdo por padrão (R1), enquanto o OpenAI Agents SDK registra entradas e saídas por padrão (R4). Traces podem conter dados sensíveis (prompts, argumentos, saídas de ferramentas), e a retenção e o controle de acesso devem ser definidos antes da produção. O OpenAI Agents SDK tem ainda a restrição de não funcionar sob Zero Data Retention.
Falhas silenciosas de telemetria. Em pelo menos uma plataforma, falhas de exportação não interrompem o agente nem geram erro visível (R1). A ausência de um trace pode, portanto, significar falha de exportação, e não que nada aconteceu.
Traço não é correção. O trace explica o que o agente fez; a avaliação responde se o resultado é bom. As plataformas com avaliação sobre traces (OpenAI, LangSmith, Langfuse, Phoenix, Braintrust, Logfire) cobrem os dois lados; as demais exigem integrar um avaliador.
Recomendações práticas.
- Instrumente por OTel sempre que possível, para manter a portabilidade entre fabricantes e backends.
- Defina por escrito o que será capturado (conteúdo, argumentos, resultados) e quem pode ler.
- Monitore a própria exportação de telemetria, com alerta para queda de volume de spans.
- Separe duas métricas: terminou sem erro (sinal do trace) e resultado correto (sinal de avaliação).
- Para tarefas longas ou com várias interações, agrupe traces por sessão ou conversa.
10. Implicações conceituais para o SGAEIA em ambientes distribuídos de edge
10.1 Observabilidade não equivale a governança
Na perspectiva do SGAEIA, tracing é uma capacidade de observação e reconstrução, não uma autorização para agir nem uma prova automática de conformidade. Um trace pode demonstrar que um agente chamou uma ferramenta, transferiu controle ou produziu determinado resultado, mas a legitimidade dessa ação depende de regras de autoridade, contexto e política que não são inferidas apenas pela telemetria. Essa distinção preserva o princípio de que capacidade técnica, identidade autenticada e intenção declarada não equivalem a autoridade operacional.
10.2 Evidência precisa sobreviver à distribuição
Em cenários edge-cloud, a execução pode atravessar dispositivos, serviços, domínios administrativos e períodos de conectividade intermitente. Por isso, a utilidade do tracing depende da propagação consistente de contexto, de relógios e identificadores suficientemente confiáveis, de retenção proporcional ao risco e da capacidade de distinguir ausência de evento de falha de exportação. O requisito conceitual não é coletar tudo, mas preservar evidência suficiente para reconstruir decisões e efeitos sem transformar a infraestrutura de observabilidade em um novo canal de exposição.
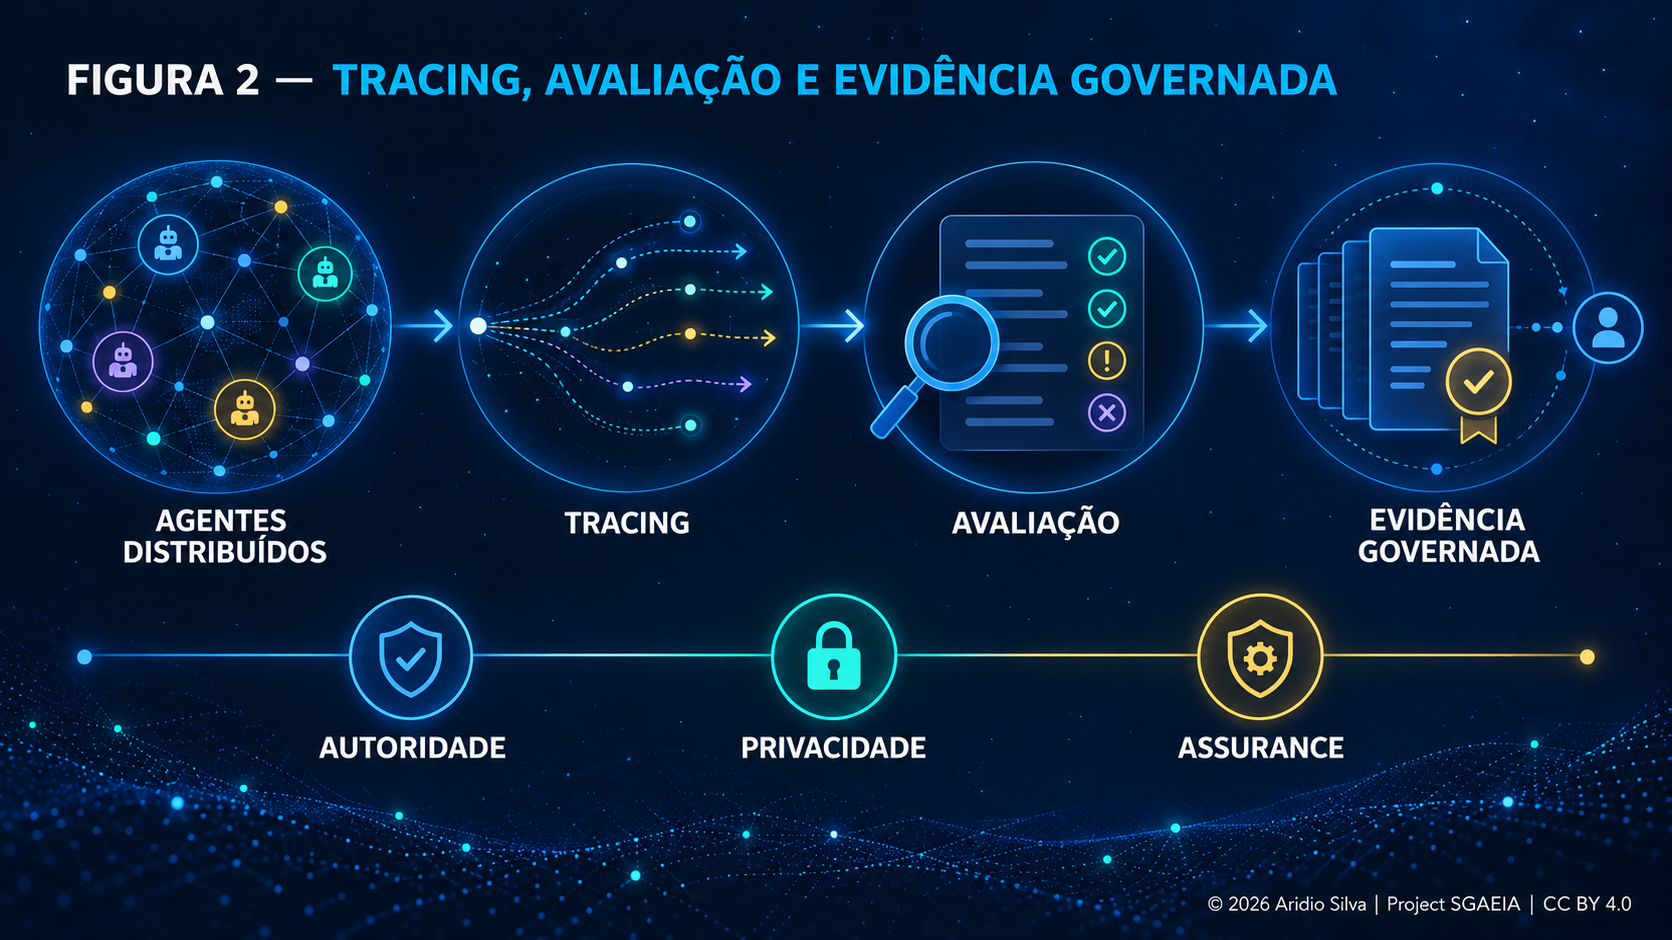
Figura 2 — Tracing, avaliação e evidência no SGAEIA. O trace registra o caminho; a avaliação examina a qualidade e a conformidade do resultado; a evidência governada sustenta auditoria e assurance sob hipóteses explícitas. Esta é uma interpretação conceitual não normativa. © 2026 Aridio Silva | Project SGAEIA | CC BY 4.0.
10.3 A correção do resultado exige um sinal independente
O achado mais importante para sistemas autônomos é que a ausência de exceção não demonstra que o objetivo foi atingido. Um run pode terminar tecnicamente bem e ainda produzir conteúdo incorreto, escolher um caminho inadequado ou realizar uma ação fora do escopo legítimo. A arquitetura de assurance deve, portanto, separar ao menos dois eixos: integridade da execução e qualidade ou conformidade do resultado, evitando que um único status verde oculte falhas semânticas.
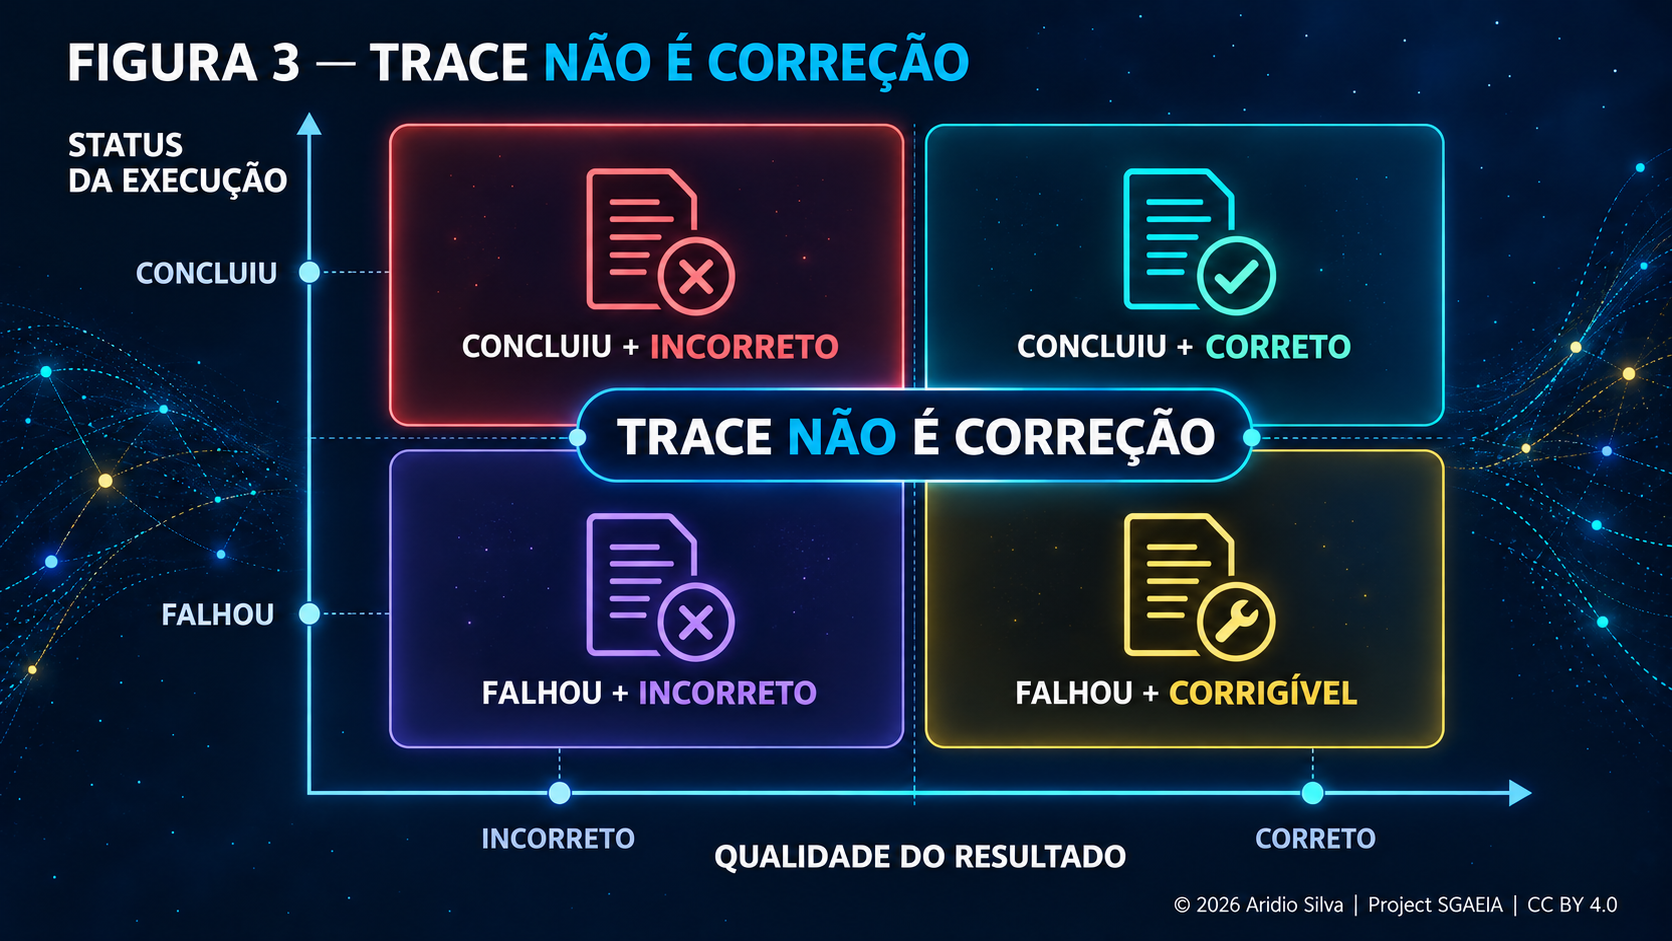
Figura 3 — Trace não é correção. O estado técnico da execução e a qualidade do resultado são dimensões independentes; somente a combinação de tracing e avaliação permite distinguir sucesso operacional de sucesso substantivo. © 2026 Aridio Silva | Project SGAEIA | CC BY 4.0.
10.4 Requisitos de pesquisa e validação futura
Esta interpretação sugere questões para a evolução governada do SGAEIA, mas não promove automaticamente controles ou componentes à arquitetura normativa. Trabalhos futuros devem avaliar a continuidade de contexto entre agentes e domínios, a resistência da cadeia de evidência à supressão e adulteração, o comportamento em modo offline ou degradado, os efeitos de amostragem e redação sobre a auditabilidade e a capacidade de relacionar eventos locais a trajetórias distribuídas. Qualquer requisito, invariante ou mecanismo decorrente desses achados deve seguir o processo Research-to-Architecture e ser validado antes de sustentar uma afirmação de assurance.
11. Conclusão
Rastrear em detalhe a execução de agentes é viável hoje em todas as plataformas analisadas, com um span por passo (chamada ao modelo, ferramenta, handoff) organizado em árvore dentro de um trace e, em alguns casos, de uma sessão. Mas o campo está no meio do amadurecimento: as soluções são, em boa parte, versões preliminares, e várias estão em beta ou preview. Os traces do Claude Agent SDK e o Managed Agents estão em beta, o tracing de workflows e de agentes externos do Foundry está em preview, as convenções GenAI do OpenTelemetry seguem em Development e SDKs centrais ainda têm numeração 0.x (Claude Agent SDK, OpenAI Agents SDK, LangSmith e Braintrust). Nomes de spans, atributos e comportamentos podem mudar entre versões, e qualquer adoção deve prever esse custo de migração.
Respondendo às questões de pesquisa: (QP1) o modelo de trace e span do tracing distribuído se aplica diretamente, com variações de nomenclatura entre plataformas; (QP2) conclusão, erros, duração e passos são respondidos pelos sinais do trace, mas a correção do resultado exige avaliação independente; (QP3) o ecossistema é amplo, porém em transição, com recursos em beta, preview e convenções ainda em status Development; e (QP4) para o SGAEIA, tracing deve ser tratado como uma fonte de evidência governada que complementa, mas não substitui, autoridade, avaliação, validação e assurance.
Trabalhos futuros incluem testes empíricos de sobrecarga de desempenho de cada instrumentação, a verificação dos recursos marcados com "—" diretamente nos produtos e o acompanhamento da estabilização das convenções GenAI do OpenTelemetry.
Glossário
- ADOT (AWS Distro for OpenTelemetry). Distribuição do OpenTelemetry mantida pela AWS, usada para instrumentar agentes e enviar traces ao CloudWatch.
- Agente de IA. Sistema que usa um modelo de linguagem para decidir, em tempo de execução, quais ferramentas chamar e como concluir uma tarefa.
- Amostragem (sampling). Registro de apenas uma fração dos traces para reduzir volume e custo.
- Autolog. Ativação de instrumentação automática por uma única chamada (termo do MLflow).
- Avaliação (eval). Medição da qualidade do resultado de um agente, com notas atribuídas por código, modelo avaliador ou pessoas.
- Backend de observabilidade. Sistema que recebe, armazena e permite consultar traces, métricas e logs.
- Beta, preview, GA e Development. Estágios de maturidade. Beta e preview indicam recurso ainda sujeito a mudanças; GA (general availability) é a disponibilidade geral; Development é o estágio inicial das convenções do OpenTelemetry, em que nomes podem mudar.
- CMK (customer-managed key). Chave de criptografia gerenciada pelo cliente.
- Convenções semânticas. Nomes e atributos padronizados para spans, métricas e eventos (por exemplo,
gen_ai.agent.name). - ELv2 (Elastic License 2.0). Licença com código disponível que permite uso amplo, mas restringe oferecer o software como serviço gerenciado.
- Evento. Registro estruturado de uma ocorrência (prompt, erro de API, decisão de permissão), distinto de métricas e spans.
- Falha semântica. Erro de conteúdo em que o agente conclui sem exceção, mas entrega uma resposta errada.
- Guardrail. Verificação que valida ou bloqueia entradas ou saídas do agente.
- Handoff. Transferência de controle de um agente para outro.
- Hook. Código executado em um ponto definido do ciclo do agente, como antes do uso de uma ferramenta.
- Instrumentação. Código ou biblioteca que gera telemetria, de forma manual ou automática.
- Métrica. Medida numérica agregada ao longo do tempo (tokens, custo, latência).
- MIT. Licença permissiva de código aberto.
- Observabilidade. Capacidade de entender o estado interno de um sistema a partir da telemetria que ele emite.
- OpenInference. Camada de convenções semânticas sobre o OTel, criada pela Arize, com tipos de span como LLM, Tool, Agent e Retriever.
- OpenTelemetry (OTel). Padrão aberto para gerar e exportar telemetria (traces, métricas e logs).
- OTLP. Protocolo do OpenTelemetry para transporte de telemetria.
- Propagação de contexto. Passagem do identificador do trace entre processos, de modo que spans de componentes diferentes componham um único trace (padrão W3C Trace Context).
- Self-host. Hospedagem do software na infraestrutura do próprio usuário.
- Sessão (ou thread). Agrupamento de vários traces de uma mesma conversa ou interação.
- SIEM. Plataforma de gestão de eventos de segurança, usada para auditoria.
- Span. Trecho rastreado da execução; registra uma etapa com início, fim, pai, status e atributos.
- Span link. Ligação entre spans sem relação de pai e filho, por exemplo quando a saída de um alimenta a entrada de outro.
- Subagente. Agente acionado por outro agente durante a execução.
- Trace. Registro completo de uma operação, composto por spans.
- Trace grading. Atribuição de notas a traces de agentes para identificar erros e regressões (termo da OpenAI).
- Tracing distribuído. Técnica de registrar o caminho de uma requisição por vários componentes.
- Uso de ferramenta (tool use). Chamada de um recurso externo pelo agente (API, banco de dados, busca, execução de código).
- ZDR (Zero Data Retention). Política em que o fornecedor não retém dados das requisições; no OpenAI Agents SDK, o tracing não está disponível sob ZDR.
Referências
Todas as páginas foram consultadas em 10/10/2026. Marcação de validação: [A] página aberta integralmente pela ferramenta de leitura; [B] página recuperada pela busca, com título e trecho conferidos contra a afirmação do texto; [C] dados obtidos por API de registro. Fontes marcadas como "terceiros" não são oficiais.
Fabricantes e padrões
- R1. Anthropic. Observability with OpenTelemetry (Agent SDK). [A]
- R2. Anthropic. Monitoring (Claude Code). [A]
- R3. Anthropic. Managed Agents: observability. [B]
- R4. OpenAI. Tracing (Agents SDK). [A]
- R5. OpenAI. Trace grading. [B]
- R6. OpenAI. Evaluate agent workflows. [B]
- R7. Google. Agent activity traces (ADK). [B]
- R8. Google. Observability for agents (ADK). [B]
- R9. Google Cloud. Trace an agent (Agent Engine). [B]
- R10. Google Cloud. Observability for AI agent developers. [B]
- R11. Microsoft. Trace agent concept (Foundry). [B]
- R12. Microsoft. Set up tracing in Foundry. [B]
- R13. Microsoft. Quickstart: tracing a hosted agent. [B]
- R14. Microsoft. Enable observability for agents (Agent Framework). [B]
- R15. AWS. Observability for agentic resources in AgentCore. [A]
- R16. AWS. Add observability to AgentCore resources. [B]
- R17. AWS. Amazon Bedrock AgentCore now delivers unified observability with traces and logs in a single log group (23/07/2026). [B]
- R18. OpenTelemetry. OpenTelemetry GenAI Semantic Conventions. Repositório oficial para o qual a antiga documentação de spans de agentes passou a apontar. [A]
- R19. Dash0 (terceiros). OpenTelemetry GenAI semantic conventions explained. [B]
- R20. DEV Community (terceiros). OpenTelemetry's GenAI semantic conventions are not stable yet. [B]
- R44. Microsoft. Tracing in Microsoft Foundry (página anterior, com a menção à Outshift). [B]
Plataformas independentes
- R21. LangChain. Observability concepts (LangSmith). [B]
- R22. LangChain. Trace with OpenTelemetry (LangSmith). [B]
- R23. LangChain. Observability how-to guides (LangSmith). [B]
- R24. Langfuse. Engineering clarifications. [B]
- R25. Langfuse. Data model. [B]
- R26. Arize. Phoenix (repositório). [B]
- R27. Atlan (terceiros). What is Arize. [B]
- R28. Datadog. OpenTelemetry instrumentation. [B]
- R29. Datadog. Agent monitoring. [B]
- R30. Braintrust. Self-hosting. [B]
- R31. Braintrust. Release notes. [B]
- R32. Braintrust. Glossary. [B]
- R33. MLflow. Tracing for LLM and agent observability. [B]
- R34. Databricks. Automatic tracing and integrations. [B]
- R35. Pydantic. Logfire: AI observability. [B]
- R45. Langfuse. Integração AI SDK C++ (modelo de dados v4, OTLP-first). [B]
- R47. Pydantic. Pydantic AI: Logfire. [B]
Fontes de terceiros e dados de versão
- R36. Inference.net (terceiros). Claude Agent SDK tracing and evaluation in production. [B]
- R37. ClickHouse (terceiros). What is AI agent observability. [B]
- R38. BenchLM (terceiros). Best LLM observability tools. [B]
- R39. Jannik Reinhard (terceiros). Microsoft Foundry observability. [B]
- R40. Registros PyPI e npm, consultados via API em 10/10/2026 para versão e data de publicação. [C]
- R41. Latitude (terceiros). LLM observability tools compared. [B]
- R42. RFP.wiki (terceiros). Braintrust. [B]
- R43. Pydantic. Logfire FAQ. [B]
- R46. Inference.net (terceiros). Arize Phoenix alternatives for agent observability. [B]
Sobre o autor
Aridio Silva é pesquisador independente no Brasil, dedicado à arquitetura, segurança, governança e confiabilidade de sistemas de inteligência artificial autônomos e distribuídos.
Sua pesquisa concentra-se em Agentic AI, Multi-Agent Systems, Edge AI, AI Security, Zero Trust, Security-by-Design, AI Governance, Spec-Driven Development e continuous security assurance.
É criador e pesquisador responsável pelo SGAEIA — Secure Governed Autonomous Edge Intelligence Architecture, iniciativa de pesquisa que investiga fundamentos arquiteturais para sistemas autônomos de AI seguros, governados, auditáveis e confiáveis em ambientes distribuídos de edge e cloud.
Recursos de pesquisa e do projeto
- ORCID: https://orcid.org/0009-0008-2411-6995
- Google Scholar: https://scholar.google.com/citations?user=rPn5O48AAAAJ
- Zenodo — SGAEIA Community: https://zenodo.org/communities/sgaeia
- OpenAIRE: https://explore.openaire.eu/search/find?fv0=Aridio%20Silva&f0=q
- Medium: https://medium.com/@aridiosilva
- DEV Community: https://dev.to/aridiosilva
- GitHub: https://github.com/aridiosilva
- LinkedIn: https://www.linkedin.com/in/aridio-silva-74997111/
- Homepage: https://aridiosilva.com
- SGAEIA Homepage: https://aridiosilva.com/sgaeia
- SGAEIA LinkedIn: https://www.linkedin.com/company/sgaeia/
Figuras
A capa não é numerada. As Figuras 1–3 são ilustrações conceituais públicas e não revelam protocolos, algoritmos, máquinas de estado, políticas internas, limiares ou mecanismos privados do SGAEIA.
Licença
Exceto quando indicado de outro modo, o texto e as ilustrações conceituais originais deste artigo são licenciados sob a Creative Commons Attribution 4.0 International (CC BY 4.0).
© 2026 Aridio Silva. É permitido compartilhar e adaptar esta obra para qualquer finalidade, desde que seja atribuída a autoria adequada.
O artefato de software e pesquisa do SGAEIA permanece sujeito à sua própria licença Apache 2.0.
Autonomous AI. Governed by Design. Trusted by Evidence.
Continuidade da série
Este trabalho é o SGAEIA Research Series — Article 18. A edição canônica está disponível para leitura aberta. O registro persistente está identificado pelo DOI 10.5281/zenodo.23284753. As edições de distribuição estão disponíveis no Medium e na DEV Community.
Citação sugerida
Silva, Aridio. (2026). Rastreamento da Execução de Agentes de AI: Fundamentos, Estado da Arte e Implicações para Sistemas Multiagentes Distribuídos. SGAEIA Research Series, Article 18. https://doi.org/10.5281/zenodo.23284753. Edição canônica: https://aridiosilva.com/publications/artigo18/pt/. CC BY 4.0.