SGAEIA Research Series — Article 22
Aridio Silva
Independent Researcher, Brazil
Creator of SGAEIA — Secure Governed Autonomous Edge Intelligence Architecture
ORCID: 0009-0008-2411-6995
DOI: https://doi.org/10.5281/zenodo.23540392
Publicado em: 21 de outubro de 2026
Licença: Creative Commons Attribution 4.0 International — CC BY 4.0
Sumário
- Resumo
- Introdução e escopo
- Visão geral do fluxo
- Entrada e tokenização
- Embeddings e codificação posicional
- Self-attention (autoatenção)
- Multi-head attention e máscaras
- Conexão residual e normalização
- Rede feed-forward (FFN)
- Empilhamento multicamadas
- Pesos: o que são e como são aprendidos
- Saída: logits, softmax e decodificação
- Estudo de caso: desambiguação de “banco” e interpretabilidade
- Propriedades emergentes e leis de escala
- Limitações, ressalvas e debates em aberto
- Da inferência à execução governada: implicações para o SGAEIA
- Conclusão
- Glossário
- Referências bibliográficas
- Códigos-fonte (Python)
- Sobre o autor
- Recursos de pesquisa e do projeto
- Figuras
- Licença
- Continuidade da série
- Citação sugerida
Resumo
Este artigo apresenta uma explicação técnica, formal e didática do processo de inferência em modelos de linguagem baseados em Transformers, desde a tokenização da entrada até a seleção do próximo token. A exposição combina fórmulas, exemplos numéricos reproduzíveis e seis figuras para mostrar embeddings, codificação posicional, self-attention, máscaras, conexões residuais, normalização, redes feed-forward, logits, softmax e estratégias de decodificação. O estudo de caso da palavra ambígua “banco” demonstra, em escala reduzida, como o contexto altera representações sem pretender reproduzir o comportamento de um modelo treinado real. Por fim, o texto distingue a inferência do modelo da execução governada de um sistema agentivo e apresenta uma interpretação pública e não normativa de suas implicações para o SGAEIA.
Palavras-chave: AI; Transformer; inferência; LLM; atenção; tokenização; embeddings; softmax; propriedades emergentes; SGAEIA.
1. Introdução e escopo
Função desta seção. Fixa o objetivo, as convenções e os limites do texto antes de qualquer técnica. É necessária porque os números e as figuras que seguem são didáticos; sem este aviso, poderiam ser lidos como medições de um modelo real.
Este documento descreve, etapa por etapa, o que ocorre dentro de um modelo de linguagem baseado na arquitetura Transformer (Vaswani et al., 2017), desde o texto de entrada até o token de saída, usando como fio condutor a frase ambígua "O banco estava lotado". O objetivo é tornar a "caixa-preta" inteligível: cada etapa traz o conceito, o mecanismo matemático, a técnica adotada, um exemplo numérico e as referências que a sustentam.
Convenções. Referências no texto seguem o formato (Autor, ano) e estão listadas na seção 18. Termos técnicos aparecem em negrito na primeira ocorrência e estão definidos no Glossário (seção 17). Matrizes são escritas em maiúsculas (Q, K, V) e dimensões como n (tamanho da sequência), d_model (dimensão do modelo) e d_k (dimensão de cada cabeça).
Aviso sobre os exemplos numéricos. Os números das seções 3 a 11 foram calculados por código (Python/NumPy) com dimensões reduzidas e vetores escolhidos à mão para fins didáticos. Eles ilustram a aritmética do mecanismo, não são medições de um modelo treinado real. Em modelos reais, os pesos são aprendidos e as dimensões são muito maiores (por exemplo, d_model = 512 no Transformer original e 768 no BERT-base).
Escopo. O texto descreve o Transformer em termos gerais (variantes codificador, decodificador e codificador-decodificador).
© 2026 Aridio Silva – Pesquisador Independente · ORCID 0009-0008-2411-6995
2. Visão geral do fluxo
Por que o fluxo tem estas etapas, nesta ordem. Cada etapa resolve um problema que a anterior deixa em aberto. A rede só opera sobre números (tokenização); números inteiros não têm geometria nem ordem (embeddings e posição); cada token precisa de contexto (atenção); a mistura contextual precisa ser transformada, estabilizada e repetida em profundidade (FFN, Add & Norm, empilhamento); o comportamento depende de pesos que precisam ser aprendidos (treino); e o resultado final precisa virar uma palavra (logits, softmax e decodificação). A tabela resume o problema que cada etapa resolve e o que faltaria sem ela.
| Etapa | Problema que resolve | Sem ela |
|---|---|---|
| Tokenização | A rede só processa números, e o vocabulário precisa ser finito | Não há entrada numérica; palavras raras ficariam sem representação ou as sequências ficariam longas demais |
| Embedding | IDs inteiros são rótulos arbitrários, sem noção de similaridade | Cada token seria um vetor one-hot com uma dimensão por token do vocabulário (dezenas de milhares), esparso e sem similaridade entre tokens |
| Codificação posicional | A atenção, por construção, não usa a ordem das palavras | Atenção sem máscara não distingue ordens diferentes das mesmas palavras (Vaswani et al., 2017) |
| Self-attention | Cada token precisa de informação dos demais | Cada token seria interpretado isoladamente; "banco" teria sempre o mesmo vetor |
| Multi-head | Várias relações precisam ser captadas ao mesmo tempo | Uma única média ponderada por camada, que inibe atender a subespaços de representação distintos (Vaswani et al., 2017) |
| Add & Norm | Sinal e gradiente precisam atravessar muitas camadas | Treino instável ou degradado em pilhas profundas (He et al., 2016; Ba et al., 2016; Xiong et al., 2020) |
| FFN | A atenção apenas combina Values; falta transformação por token | Sem a parte da camada que concentra cerca de dois terços dos parâmetros (Geva et al., 2021) |
| Empilhamento | Relações complexas exigem composição em passos | Só relações diretas em um passo; certos circuitos exigem duas ou mais camadas (Elhage et al., 2021; Olsson et al., 2022) |
| Treino | Pesos aleatórios não produzem linguagem | Um circuito sem comportamento útil, como nos exemplos com pesos aleatórios |
| Saída | Um vetor de números precisa virar um token | Sem logits, softmax e decodificação não há distribuição nem palavra escolhida |
A inferência em um modelo de linguagem é a execução do modelo já treinado, com pesos fixos, para produzir uma saída a partir de uma entrada. No caso de um modelo gerador, essa execução é um ciclo: o modelo calcula uma distribuição de probabilidade sobre o próximo token, um token é escolhido, anexado à entrada, e o ciclo se repete (geração autorregressiva). A computação de uma passagem completa pelas camadas chama-se forward pass (propagação direta).
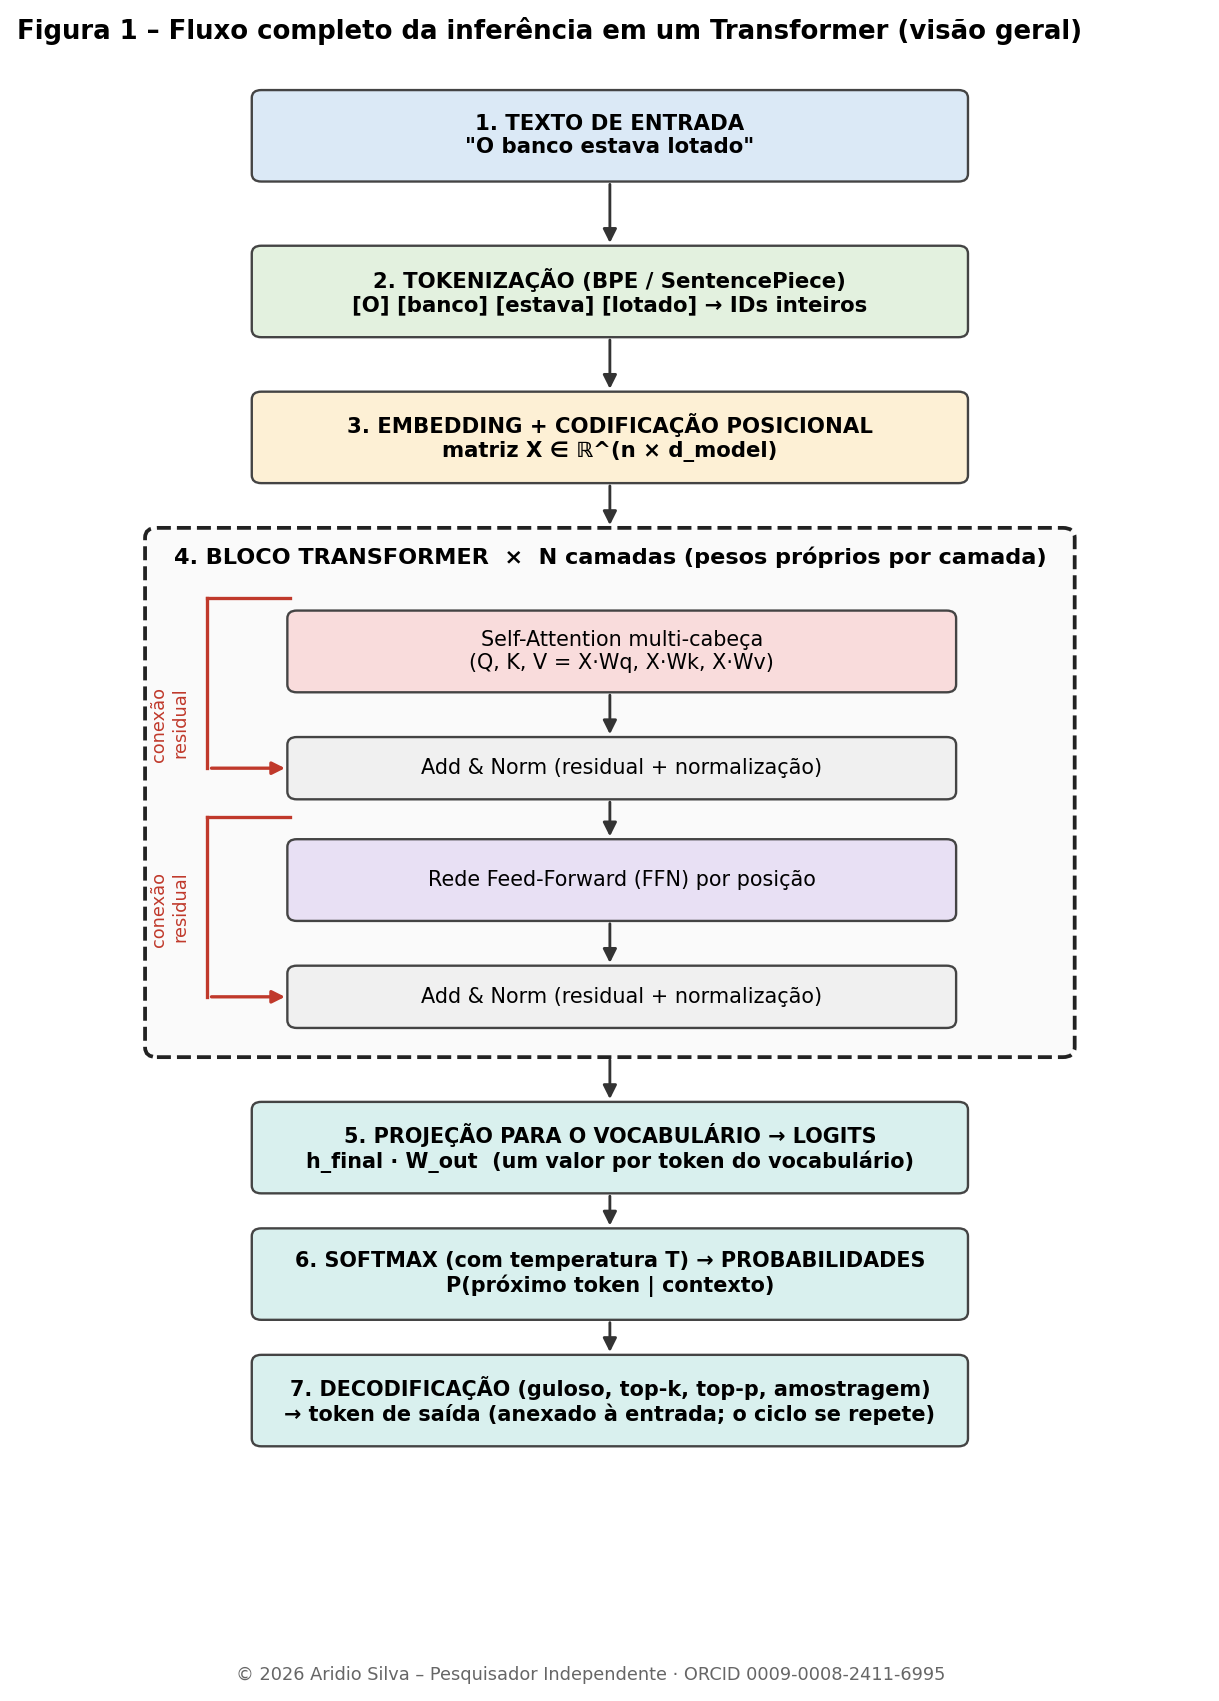
A arquitetura original combina um codificador e um decodificador (Vaswani et al., 2017). Duas famílias derivadas dominam o uso atual: modelos somente codificador, como o BERT (Devlin et al., 2019), que veem a sequência nos dois sentidos, e modelos somente decodificador, como a série GPT (Radford et al., 2018; Radford et al., 2019; Brown et al., 2020), que geram texto da esquerda para a direita. Os mecanismos descritos nas próximas seções valem para todas, com a diferença principal na máscara de atenção (seção 6).
| Etapa | Operação | Técnica principal | Referência-chave |
|---|---|---|---|
| 1. Tokenização | Texto → IDs inteiros | BPE, SentencePiece | Sennrich et al., 2016; Kudo e Richardson, 2018 |
| 2. Embedding e posição | IDs → vetores + ordem | Matriz de embeddings; senoidal ou RoPE | Mikolov et al., 2013; Vaswani et al., 2017; Su et al., 2021 |
| 3. Self-attention | Mistura contextual entre tokens | Produto escalar escalonado e softmax | Bahdanau et al., 2015; Vaswani et al., 2017 |
| 4. Multi-head | Várias relações em paralelo | Subespaços de dimensão d_k | Vaswani et al., 2017; Voita et al., 2019 |
| 5. Add & Norm | Estabilidade do sinal | Conexão residual; LayerNorm, RMSNorm | He et al., 2016; Ba et al., 2016; Zhang e Sennrich, 2019 |
| 6. FFN | Transformação não linear por posição | MLP com ReLU, GELU ou SwiGLU | Geva et al., 2021; Shazeer, 2020 |
| 7. Empilhamento | Refinamento em profundidade | N camadas | Tenney et al., 2019 |
| 8. Saída | Logits → probabilidades → token | Softmax, temperatura, top-k, top-p | Holtzman et al., 2020 |
O treinamento (seção 10) é a etapa que define os pesos. A inferência apenas os utiliza.
3. Etapa 1 – Entrada e tokenização
Por que esta etapa é necessária. Computadores aplicam operações aritméticas a números; sem converter o texto em IDs, não há entrada para a rede. O vocabulário precisa ser finito e fixo porque a camada de saída tem uma dimensão por token (seção 11). A escolha por subpalavras resolve um compromisso real: palavras inteiras deixam termos novos sem representação, e caracteres isolados geram sequências longas, o que encarece a atenção, cujo custo cresce com o quadrado do comprimento (seção 5; Sennrich et al., 2016).
Conceito. Redes neurais operam sobre números, não sobre texto. A tokenização converte a cadeia de caracteres em uma sequência de tokens (unidades do vocabulário) e cada token em um ID inteiro. O vocabulário é um conjunto finito, fixado antes do treinamento, tipicamente de dezenas de milhares de entradas.
Por que subpalavras. Vocabulários de palavras inteiras não representam palavras raras ou novas (problema das palavras fora do vocabulário, ou OOV), e vocabulários de caracteres geram sequências longas demais. As unidades de subpalavra equilibram os dois extremos: palavras frequentes viram um token, e palavras raras são decompostas em pedaços reutilizáveis (Sennrich et al., 2016).
Técnicas adotadas.
- BPE (Byte Pair Encoding): parte de caracteres e funde, iterativamente, o par adjacente mais frequente em um novo símbolo. Foi proposto como algoritmo de compressão por Gage (1994) e adaptado à tradução automática por Sennrich et al. (2016). A variante em nível de bytes é usada em modelos da série GPT (Radford et al., 2019).
- WordPiece: escolhe as fusões pelo ganho de verossimilhança do modelo de linguagem, em vez da simples frequência (Schuster e Nakajima, 2012; Wu et al., 2016). É usada no BERT (Devlin et al., 2019).
- Unigram LM e SentencePiece: o Unigram parte de um vocabulário grande e poda o que contribui menos (Kudo, 2018). O SentencePiece implementa BPE e Unigram diretamente sobre o texto bruto, sem pré-tokenização por espaços, o que o torna independente de idioma (Kudo e Richardson, 2018).
Exemplo numérico (BPE em corpus didático). Corpus com a frequência de cada palavra, onde </w> marca o fim de palavra: low (5), lower (2), newest (6), widest (3). Início: cada palavra é uma sequência de caracteres. Em cada passo, funde-se o par mais frequente (empates resolvidos pela ordem de ocorrência). Resultado calculado por código:
| Passo | Par fundido | Frequência do par | Novo símbolo |
|---|---|---|---|
| 1 | e + s | 9 | es |
| 2 | es + t | 9 | est |
| 3 | est + </w> |
9 | est</w> |
| 4 | l + o | 7 | lo |
| 5 | lo + w | 7 | low |
| 6 | n + e | 6 | ne |
| 7 | ne + w | 6 | new |
| 8 | new + est</w> |
6 | newest</w> |
Após 8 fusões, "newest" é um único token (newest</w>), "low" tem o token low seguido de </w>, e "widest" é decomposta em w, i, d, est</w>: a palavra nunca vista inteira reaproveita o pedaço est</w> aprendido em "newest".
Aplicação à frase-guia. Em um vocabulário real, "O banco estava lotado" costuma gerar poucos tokens por palavra, pois são palavras comuns do português. Para os fins deste documento, adota-se a simplificação 4 palavras = 4 tokens: [O] [banco] [estava] [lotado], com IDs inteiros ilustrativos (por exemplo, 12, 4871, 905, 23019; os valores reais dependem do tokenizador). Observe que o ID de "banco" é o mesmo nos dois sentidos da palavra: a tokenização não desambigua. A distinção só surgirá nas camadas de atenção (seção 12).
4. Etapa 2 – Embeddings e codificação posicional
Por que esta etapa é necessária. Um ID inteiro é um rótulo arbitrário: o ID 4871 não é "mais parecido" com o 4872 em significado. O embedding converte cada rótulo em um vetor no qual o treino pode organizar similaridade (Bengio et al., 2003; Mikolov et al., 2013), e as operações seguintes (somas, produtos escalares) só fazem sentido sobre vetores. A codificação posicional é necessária porque a atenção, por construção, não usa a ordem: "o gato come o peixe" e "o peixe come o gato" têm os mesmos tokens, e sem informação de posição a atenção sem máscara os trata de forma equivalente a menos de permutação (Vaswani et al., 2017). Em decodificadores com máscara causal, parte da posição pode ser inferida pelo número de tokens visíveis, mas a codificação explícita é a prática padrão.
Embedding. Cada ID seleciona uma linha de uma matriz de pesos W_E de dimensão |V| × d_model, produzindo um vetor denso que representa o token. A ideia de representar palavras como vetores contínuos, em que proximidade geométrica reflete similaridade de uso, vem dos modelos neurais de linguagem (Bengio et al., 2003) e do word2vec (Mikolov et al., 2013). No Transformer, a matriz é aprendida em conjunto com o resto do modelo, os vetores são multiplicados por √d_model e a mesma matriz costuma ser compartilhada com a projeção de saída (Vaswani et al., 2017; Press e Wolf, 2017). Um ponto central: o embedding de entrada é estático, ou seja, "banco" recebe o mesmo vetor em qualquer frase. A contextualização acontece depois, na atenção.
Codificação posicional. A atenção, por si só, trata a entrada como um conjunto: embaralhar os tokens embaralha a saída da mesma forma, sem distinguir ordem. Por isso se soma ao embedding um vetor que depende da posição. A proposta original usa funções senoidais de frequências geométricas (Vaswani et al., 2017):
$$PE_{(pos,,2i)} = \sin!\left(\frac{pos}{10000^{2i/d_{model}}}\right), \qquad PE_{(pos,,2i+1)} = \cos!\left(\frac{pos}{10000^{2i/d_{model}}}\right)$$
Cada par de dimensões oscila em uma frequência diferente, e a diferença entre posições pode ser expressa como transformação linear dos vetores, o que facilita ao modelo aprender relações de distância relativa (Vaswani et al., 2017).
Alternativas adotadas na literatura.
- Posições aprendidas: uma tabela treinável, usada no BERT e no GPT-2 (Devlin et al., 2019; Radford et al., 2019).
- Posições relativas: a atenção passa a depender da distância entre tokens (Shaw et al., 2018).
- RoPE (rotary embeddings): rotaciona Q e K conforme a posição, codificando posição relativa no próprio produto escalar (Su et al., 2021). É usada em modelos como o LLaMA (Touvron et al., 2023).
- ALiBi: adiciona um viés linear por distância aos scores de atenção, melhorando a extrapolação para sequências mais longas que as do treino (Press et al., 2022).
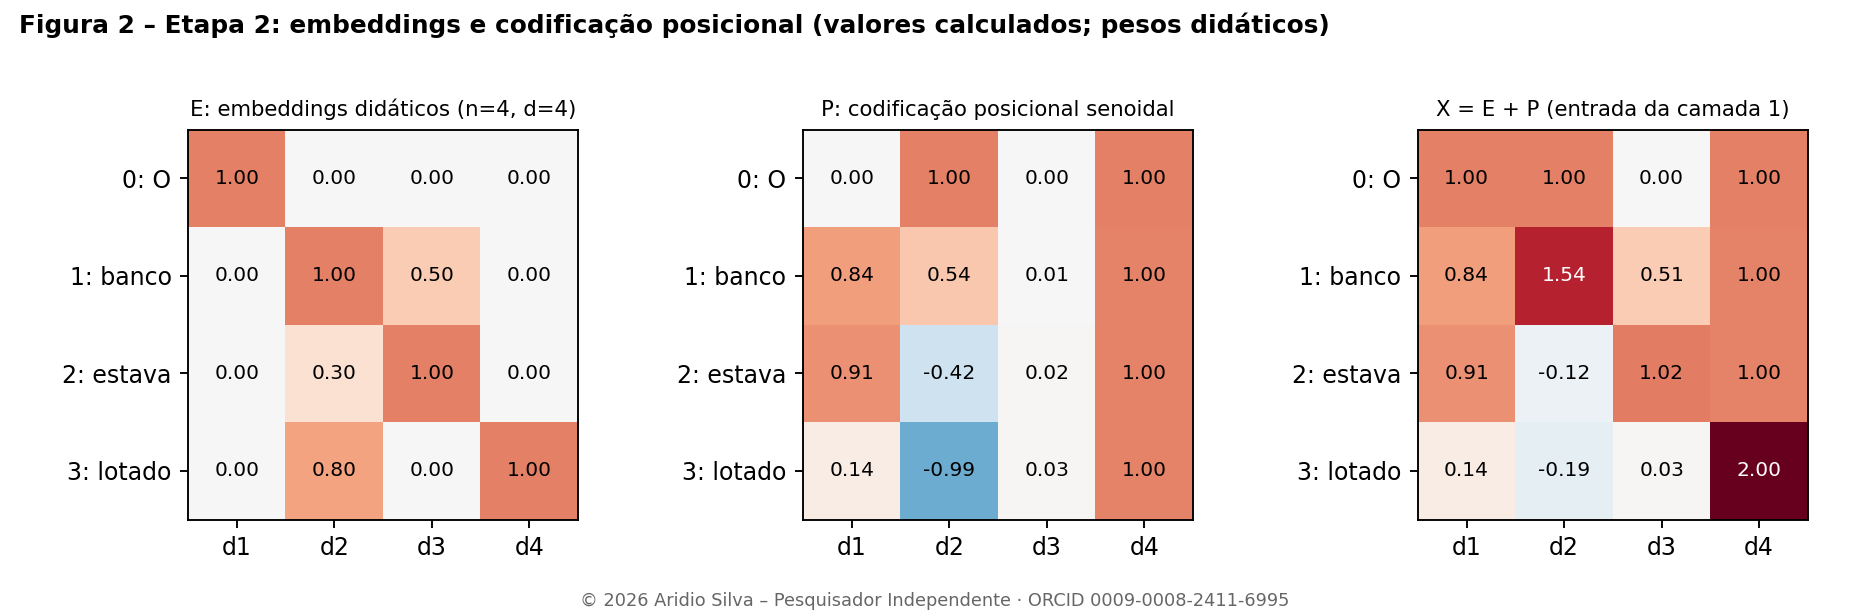
Exemplo numérico. Com d_model = 4 (didático; o Transformer original usa 512), embeddings escolhidos à mão para os quatro tokens e a codificação senoidal calculada pela fórmula acima. Para "banco" (posição 1): PE = [sen(1), cos(1), sen(0,01), cos(0,01)] = [0,841; 0,540; 0,010; 1,000]. Somando ao embedding [0; 1; 0,5; 0] obtém-se x = [0,841; 1,540; 0,510; 1,000]. A Figura 2 mostra as três matrizes; X = E + P, de dimensão 4 × 4, é a entrada da primeira camada.
5. Etapa 3 – Self-attention (autoatenção)
Por que esta etapa é necessária. O sentido de uma palavra depende dos vizinhos, e o embedding de entrada é estático (seção 4): "banco" começa igual em qualquer frase. É preciso um mecanismo em que cada token consulte os demais, com pesos que dependam do conteúdo, e não de posições fixas. Modelos recorrentes passam a informação passo a passo, de modo que dependências distantes atravessam muitas operações; na atenção, quaisquer duas posições se ligam em um passo, e o cálculo é paralelizável (Vaswani et al., 2017). A separação em Query, Key e Value é uma escolha de projeto: desacopla o que o token procura, o que ele oferece para ser encontrado e o conteúdo que ele repassa. A divisão por √d_k é necessária para evitar que o softmax sature quando d_k é grande.
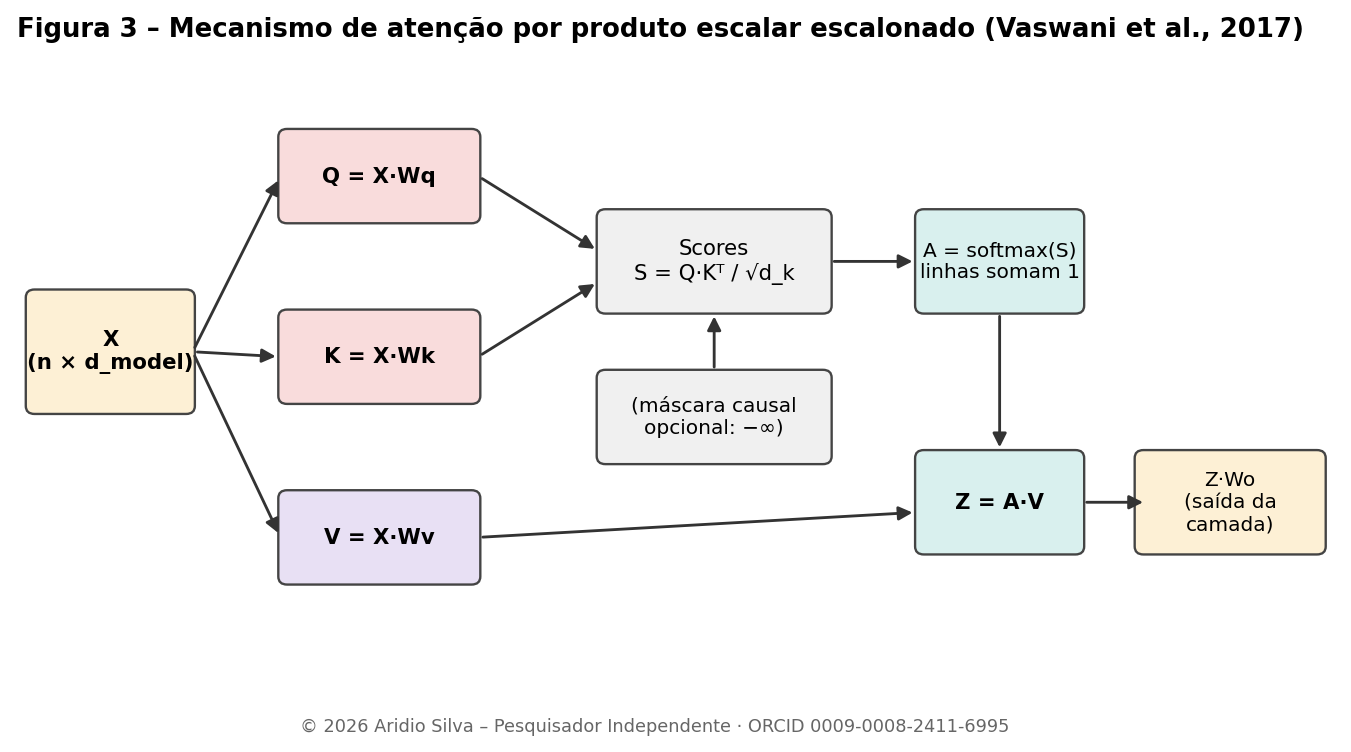
Conceito. A self-attention permite que cada token recalcule sua representação como uma média ponderada das representações de todos os tokens da sequência (incluindo ele mesmo), com pesos que dependem do conteúdo. O mecanismo de atenção surgiu na tradução automática, para alinhar palavras de saída a palavras de entrada (Bahdanau et al., 2015), e o Transformer o generalizou para operar da sequência sobre ela mesma (Vaswani et al., 2017).
Três papéis por token. Três matrizes de pesos treináveis projetam cada vetor de entrada:
- Query (Q = X·Wq): o que este token procura.
- Key (K = X·Wk): o que este token oferece para ser encontrado.
- Value (V = X·Wv): o conteúdo que este token repassa se for selecionado.
Fórmula (produto escalar escalonado).
$$\mathrm{Attention}(Q,K,V) = \mathrm{softmax}!\left(\frac{QK^{\top}}{\sqrt{d_k}}\right)V$$
- QKᵀ mede a compatibilidade entre cada Query e cada Key (produto escalar: valor alto quando os vetores apontam na mesma direção).
- Divisão por √d_k: se as componentes de q e k têm média 0 e variância 1, o produto escalar tem variância d_k. Sem a divisão, os scores crescem com a dimensão e empurram o softmax para regiões de gradiente quase nulo (Vaswani et al., 2017).
- Softmax: converte cada linha de scores em pesos positivos que somam 1.
- Multiplicação por V: o resultado é a média dos Values ponderada por esses pesos, o token contextualizado.
Exemplo numérico (d_model = 4, d_k = 2, valores calculados por código). Usando X da seção 4 e matrizes Wq, Wk, Wv escolhidas à mão, obtém-se, para o token "banco" (posição 1):
| Passo | O | banco | estava | lotado |
|---|---|---|---|---|
| Score q·k (QKᵀ) | 4,476 | 6,130 | 5,353 | 4,375 |
| Score / √2 | 3,165 | 4,334 | 3,785 | 3,093 |
| Peso (softmax) | 0,143 | 0,459 | 0,265 | 0,133 |
Os pesos somam 1,000. A saída para "banco" é Z = 0,143·v_O + 0,459·v_banco + 0,265·v_estava + 0,133·v_lotado = [1,043; 1,360], onde v_O = [1,000; 1,500], v_banco = [1,096; 2,040], v_estava = [1,419; 0,384] e v_lotado = [0,156; 0,810]. O vetor de "banco" deixou de ser só "banco": incorporou, em proporção, informação dos demais tokens. Como os pesos deste exemplo foram escolhidos à mão, não se deve ler significado linguístico no padrão obtido; em um modelo treinado, são os próprios Wq, Wk e Wv que aprendem quais relações importam.
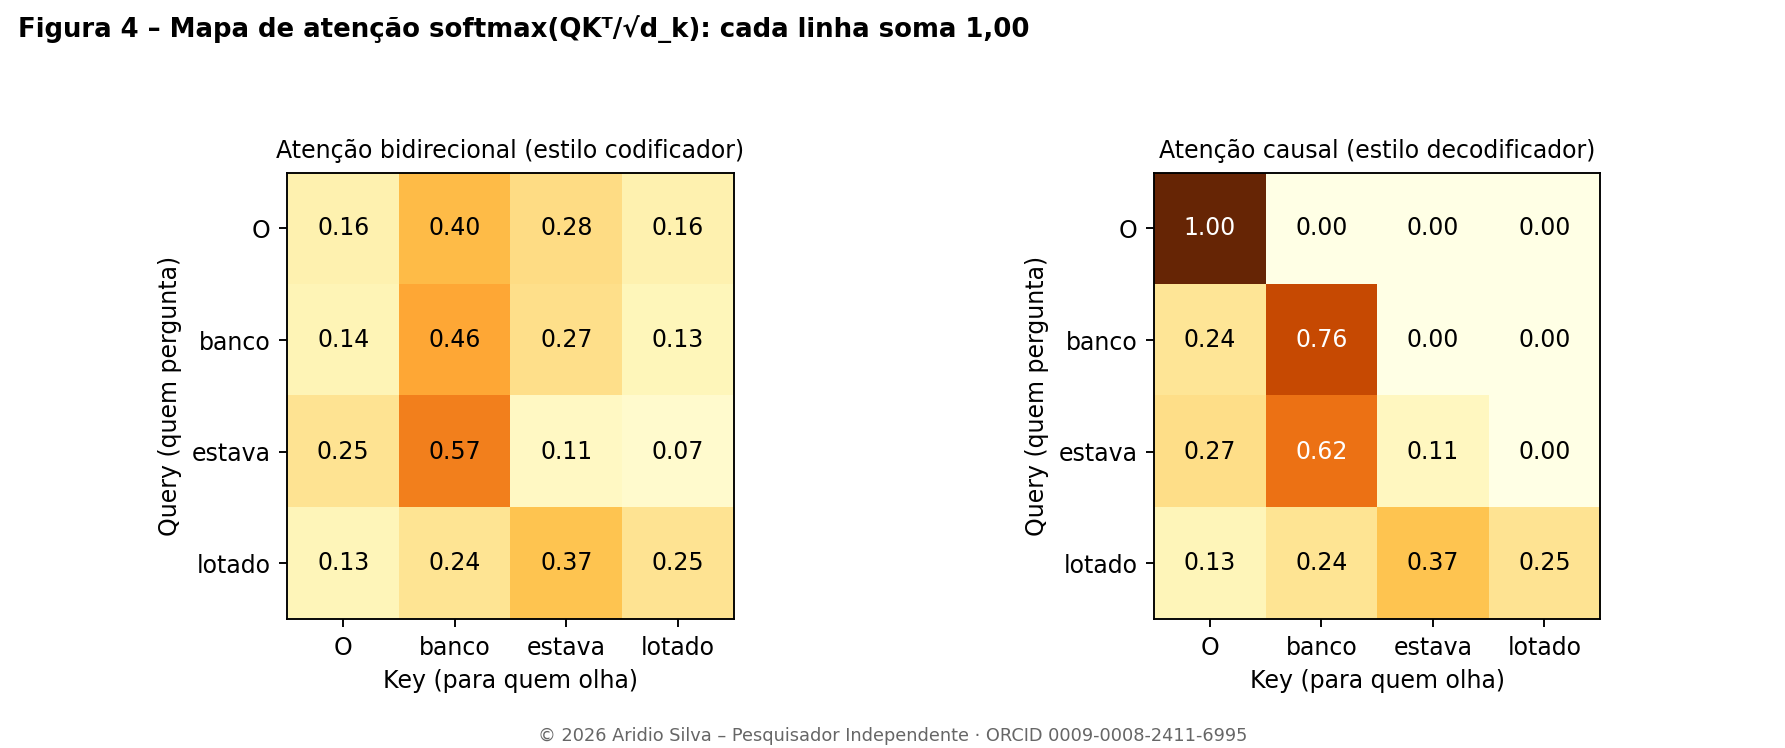
Como ler o mapa (Figura 4). Linhas são as Queries (quem pergunta); colunas são as Keys (para quem olha); cada linha soma 1. À esquerda, todos os tokens veem todos (estilo codificador). À direita, a máscara causal zera as posições futuras (seção 6).
Custo. A matriz de scores tem n × n entradas, então tempo e memória crescem quadraticamente com o comprimento da sequência. Implementações como o FlashAttention reduzem o tráfego de memória sem alterar o resultado matemático (Dao et al., 2022).
6. Etapa 4 – Multi-head attention e máscaras
Por que esta etapa é necessária. Uma única atenção produz uma só média ponderada por token, o que, segundo Vaswani et al. (2017), inibe atender ao mesmo tempo a informações de subespaços de representação diferentes. Várias cabeças permitem relações distintas em paralelo sem aumentar o custo total, pois cada cabeça trabalha em dimensão menor. A máscara causal é necessária para a geração: no treino todo o texto está disponível, e sem a máscara o modelo "veria" o token que deve prever, aprendendo a copiá-lo e falhando na inferência, em que o futuro não existe. A máscara de preenchimento evita que posições vazias influenciem o resultado. As variantes de K e V compartilhados e o KV cache existem porque, na geração, reler e recalcular todo o passado a cada token seria proibitivo (Pope et al., 2023).
Conceito. Uma única atenção produz uma só média ponderada por token. A multi-head attention executa h atenções em paralelo, cada uma com suas próprias matrizes Wq, Wk, Wv e operando em um subespaço de dimensão d_k = d_model / h. As saídas das cabeças são concatenadas e projetadas por uma matriz Wo (Vaswani et al., 2017):
$$\mathrm{MultiHead}(X) = \mathrm{Concat}(\mathrm{head}_1,\dots,\mathrm{head}_h),W^{O}, \qquad \mathrm{head}_i = \mathrm{Attention}(XW^{Q}_i,,XW^{K}_i,,XW^{V}_i)$$
Exemplo numérico (Transformer original, versão base). Com d_model = 512 e h = 8, cada cabeça tem d_k = d_v = 64, e o custo computacional total é semelhante ao de uma única cabeça de dimensão 512 (Vaswani et al., 2017). As quatro matrizes de projeção de uma camada de atenção têm, juntas, 4 × 512 × 512 = 1.048.576 pesos (sem contar vieses). Observação de coerência: h deve dividir d_model; por isso 12 cabeças não se aplicam a d_model = 512 (o BERT-base usa 12 cabeças com d_model = 768, ou seja, d_k = 64; Devlin et al., 2019).
Por que várias cabeças. Cada cabeça pode aprender um tipo de relação. Estudos de análise de atenção no BERT encontraram cabeças que se concentram em delimitadores, em deslocamentos posicionais fixos e em relações sintáticas como a de verbo e objeto direto (Clark et al., 2019). Há também evidência de que muitas cabeças são redundantes: um subconjunto pequeno responde pela maior parte do desempenho, e as demais podem ser podadas com pouca perda (Voita et al., 2019; Michel et al., 2019).
Variantes para inferência eficiente. Em Multi-Query Attention todas as cabeças compartilham um único par de matrizes K e V (Shazeer, 2019). Em Grouped-Query Attention, grupos de cabeças compartilham K e V, em um meio-termo entre qualidade e memória (Ainslie et al., 2023). Ambas reduzem o tamanho do KV cache, o armazenamento dos K e V já calculados que evita recomputar o passado a cada novo token gerado (Pope et al., 2023).
Máscaras de atenção.
- Bidirecional (codificador): cada posição vê todas as outras. É o regime do BERT (Devlin et al., 2019).
- Causal (decodificador): antes do softmax, os scores das posições futuras recebem −∞, e seus pesos tornam-se exatamente 0. Isso preserva a propriedade autorregressiva: a previsão da posição t depende apenas das posições até t (Vaswani et al., 2017; Radford et al., 2019).
- De preenchimento (padding): ignora posições vazias usadas para igualar o tamanho dos lotes.
Exemplo numérico da máscara causal. Na linha de "banco", os scores escalonados eram [3,165; 4,334; 3,785; 3,093]. Com máscara causal, as duas últimas posições ("estava" e "lotado", futuras) viram −∞, e o softmax sobre [3,165; 4,334] resulta em [0,237; 0,763; 0; 0]. Portanto, em um modelo gerador, "banco" não pode olhar para "lotado"; a desambiguação por palavras posteriores só ocorre quando elas já foram lidas, ou seja, nas posições seguintes. Em modelos bidirecionais, como o da Figura 4, o olhar para a frente é permitido.
7. Etapa 5 – Conexão residual e normalização (Add & Norm)
Por que esta etapa é necessária. Empilhar muitas camadas obriga o sinal, e o gradiente no treino, a atravessar muitas transformações. Sem um atalho, redes mais profundas passam a ter desempenho pior no treino, o chamado problema de degradação, que a conexão residual mitiga (He et al., 2016). A residual também preserva a informação original e deixa cada subcamada aprender apenas uma correção. A normalização mantém a escala dos valores estável ao longo da profundidade (Ba et al., 2016), e sua posição (Pré-LN ou Post-LN) afeta a estabilidade do treino sem aquecimento cuidadoso (Xiong et al., 2020). Sem essas etapas, a profundidade que dá capacidade ao modelo não seria treinável de forma confiável.
Conexão residual. Depois de cada subcamada (atenção ou FFN), a entrada da subcamada é somada à sua saída: y = x + Subcamada(x). A ideia vem das redes residuais da visão computacional (He et al., 2016). Ela cria um caminho direto para o sinal e para o gradiente, o que viabiliza o treinamento de pilhas profundas, e faz cada subcamada aprender uma correção ao que já existe, em vez de reconstruir tudo. Na interpretação de circuitos, esse caminho é o fluxo residual, um canal que todas as camadas leem e no qual escrevem (Elhage et al., 2021).
Normalização. Sem controle de escala, os valores podem crescer ou encolher ao longo das camadas e desestabilizar o treino. A LayerNorm normaliza cada token separadamente, ao longo de suas d_model componentes (e não ao longo do lote), e depois aplica uma escala γ e um deslocamento β aprendidos (Ba et al., 2016):
$$\mathrm{LN}(x) = \gamma \odot \frac{x - \mu}{\sqrt{\sigma^{2} + \epsilon}} + \beta, \qquad \mu = \tfrac{1}{d}\sum_i x_i, \quad \sigma^{2} = \tfrac{1}{d}\sum_i (x_i - \mu)^2$$
A RMSNorm omite a subtração da média e normaliza apenas pela raiz do valor quadrático médio, com custo menor e desempenho comparável (Zhang e Sennrich, 2019); é adotada em modelos como o LLaMA (Touvron et al., 2023).
Pós-LN e Pré-LN. O Transformer original aplica a normalização depois da soma residual (Post-LN). Muitos modelos atuais a aplicam antes de cada subcamada (Pré-LN), variante que treina de forma mais estável e dispensa o aquecimento (warm-up) cuidadoso da taxa de aprendizado (Xiong et al., 2020).
Exemplo numérico (token "banco", versão causal, γ = 1, β = 0). A saída da atenção projetada por Wo é o = [1,074; 1,912; 0,537; 0,956]. A entrada era x = [0,841; 1,540; 0,510; 1,000]. Soma residual: r = x + o = [1,915; 3,453; 1,047; 1,956]. Média μ = 2,093 e variância σ² = 0,748. LayerNorm (ε = 10⁻⁵): [(1,915 − 2,093)/0,865; …] = [−0,205; 1,572; −1,209; −0,158], com média 0 e variância 1. Para comparação, a RMSNorm do mesmo vetor, com raiz do quadrático médio 2,264, dá [0,846; 1,525; 0,462; 0,864]: mantém a proporção entre componentes, sem centralizar em zero.
8. Etapa 6 – Rede feed-forward (FFN)
Por que esta etapa é necessária. Na atenção, os pesos dependem do conteúdo, mas a saída é uma média ponderada de Values obtidos por projeções lineares (V = X·Wv, e depois Wo); a única não linearidade ali está no softmax, que decide os pesos. A FFN acrescenta uma transformação não linear aplicada a cada token, depois que a informação de contexto foi reunida. Há também uma razão de capacidade: as FFNs concentram cerca de dois terços dos parâmetros de um Transformer e funcionam como memórias de padrões (Geva et al., 2021). A expansão para d_ff = 4 × d_model no modelo original é uma escolha de projeto que aumenta essa capacidade (Vaswani et al., 2017).
Conceito. Após a atenção, cada posição passa por uma pequena rede neural de duas camadas lineares com uma não linearidade no meio, aplicada independentemente a cada token e com os mesmos pesos para todas as posições da camada (Vaswani et al., 2017):
$$\mathrm{FFN}(x) = \max(0,; xW_1 + b_1),W_2 + b_2$$
A atenção mistura informação entre tokens. A FFN transforma a informação dentro de cada token, expandindo-a para uma dimensão maior d_ff (no original, 2048, ou seja, 4 × d_model), aplicando a não linearidade e comprimindo de volta a d_model.
Funções de ativação adotadas. ReLU no Transformer original; GELU no BERT e no GPT (Hendrycks e Gimpel, 2016; Devlin et al., 2019; Radford et al., 2019); variantes com porta (GLU), como a SwiGLU, em modelos recentes (Shazeer, 2020; Touvron et al., 2023).
Interpretação. Geva et al. (2021) propõem que a FFN funciona como uma memória chave-valor: as colunas de W1 detectam padrões no vetor de entrada (chaves), e as linhas de W2 contribuem com informação associada (valores). Essa leitura ajuda a explicar por que boa parte do conhecimento factual parece residir nas FFNs, e não na atenção. Trata-se de uma hipótese interpretativa sustentada por análise empírica, e não de um fato demonstrado em todos os modelos.
Exemplo numérico de parâmetros (Transformer base). W1 tem 512 × 2048 = 1.048.576 pesos e W2 tem 2048 × 512 = 1.048.576, total de 2.097.152 por camada (sem vieses). Somando os 1.048.576 da atenção (seção 6), a camada tem cerca de 3,15 milhões de pesos, dos quais a FFN responde por cerca de dois terços.
Exemplo numérico de cálculo (d_model = 4, d_ff = 8; W1 e W2 gerados aleatoriamente com semente fixa, sem treino). Para o token "estava" (posição 2), a entrada da FFN é o vetor normalizado [1,389; −0,901; −0,999; 0,511]. Após W1 e ReLU, a camada oculta é [0,907; 0,660; 0,330; 0; 0,623; 0; 1,541; 0,759]: seis das oito unidades ficaram ativas e duas foram zeradas pela ReLU. Após W2, a saída é [0,231; 0,954; 0,437; −0,291]. Somando à entrada (residual) e normalizando, obtém-se [1,613; −0,351; −1,121; −0,141]. Já para "banco" (posição 1), todas as oito unidades ocultas ficaram em zero neste exemplo, logo a saída da FFN é zero e o vetor atravessa a subcamada inalterado pelo caminho residual. Em um modelo treinado, o padrão de ativação esparso é aprendido, e cada token ativa um subconjunto diferente de unidades.
9. Etapa 7 – Empilhamento multicamadas
Por que esta etapa é necessária. Uma camada capta relações em um passo. Muitas tarefas exigem composição: identificar o token, relacioná-lo ao contexto, inferir o sentido e só então prever. O empilhamento permite esse refinamento sucessivo, e as análises de sondagem mostram níveis de informação distintos ao longo das camadas (Jawahar et al., 2019; Tenney et al., 2019; Belrose et al., 2023). Alguns mecanismos documentados exigem ao menos duas camadas de atenção, como os induction heads (Elhage et al., 2021; Olsson et al., 2022). Mais camadas aumentam a capacidade, mas também o custo; por isso o número de camadas é uma escolha de projeto, como mostra a tabela abaixo.
Mecanismo. Um bloco Transformer é a sequência atenção → Add & Norm → FFN → Add & Norm. O modelo empilha N blocos: a saída da camada l é a entrada da camada l + 1, e cada camada tem seus próprios pesos. A matriz de tamanho n × d_model mantém a mesma forma ao longo de toda a pilha; o que muda é o conteúdo de cada vetor, que vai sendo refinado.
| Modelo | Camadas | d_model | Cabeças | Parâmetros | Fonte |
|---|---|---|---|---|---|
| Transformer base (original) | 6 + 6 | 512 | 8 | 65 milhões | Vaswani et al., 2017 |
| BERT-base | 12 | 768 | 12 | 110 milhões | Devlin et al., 2019 |
| BERT-large | 24 | 1024 | 16 | 340 milhões | Devlin et al., 2019 |
| GPT-3 (maior versão) | 96 | 12288 | 96 | 175 bilhões | Brown et al., 2020 |
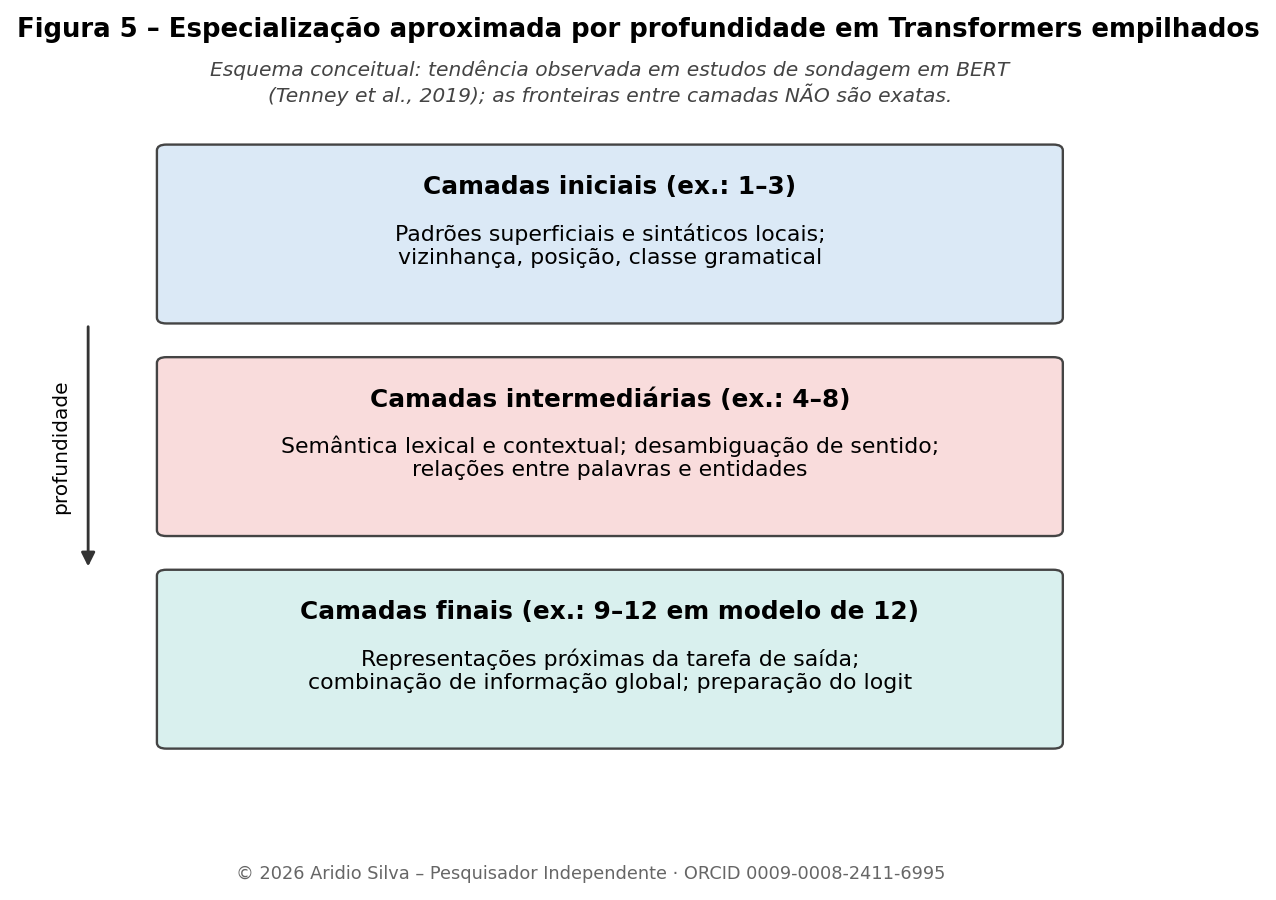
O que cada profundidade tende a representar. Estudos de sondagem (probing) no BERT indicam uma divisão aproximada: camadas iniciais captam padrões superficiais e de ordem local; camadas intermediárias, estrutura sintática; camadas mais altas, relações semânticas e de longo alcance (Jawahar et al., 2019). Tenney et al. (2019) observaram que as etapas do pipeline clássico de PLN (classes gramaticais, análise sintática, entidades, papéis semânticos, correferência) são recuperáveis nessa ordem ao longo das camadas. A Figura 5 resume essa tendência.
Refinamento iterativo da previsão. Técnicas como a logit lens e a tuned lens projetam o estado intermediário de cada camada sobre o vocabulário e mostram que a distribuição prevista para o próximo token vai se tornando mais precisa camada após camada (Belrose et al., 2023).
Circuitos que exigem profundidade. Os induction heads (cabeças de indução) são um exemplo documentado: uma cabeça na camada anterior copia informação do token anterior, e uma cabeça posterior a usa para localizar ocorrências passadas de um padrão e prever a sua continuação. Esse mecanismo requer ao menos duas camadas de atenção e foi associado ao surgimento de in-context learning durante o treino (Elhage et al., 2021; Olsson et al., 2022).
Ressalva. As fronteiras por camada variam conforme o modelo, a tarefa e o método de análise. Os intervalos de camadas usados em divulgações didáticas (por exemplo, "a camada 6 resolve o sentido de banco") são ilustrações, e não resultados medidos neste documento.
10. Etapa 8 – Pesos: o que são e como são aprendidos
Por que esta etapa é necessária. Com pesos aleatórios, as etapas anteriores produzem saídas sem relação com a linguagem, como nos exemplos numéricos deste documento. O treino é o que transforma a arquitetura em um modelo útil. A previsão do próximo token é um objetivo adequado porque fornece sinal de aprendizado em qualquer texto, sem rótulos humanos. A retropropagação é necessária porque milhões a bilhões de parâmetros só podem ser ajustados com gradientes calculados de modo eficiente (Rumelhart et al., 1986), e o otimizador, o aquecimento e a regularização existem para que esse ajuste seja estável (Kingma e Ba, 2015; Loshchilov e Hutter, 2019; Vaswani et al., 2017). Esta etapa também justifica a inferência com pesos fixos: o que o modelo "sabe" já foi gravado nos pesos.
O que são os pesos. Os pesos (ou parâmetros) são os números ajustáveis do modelo: a matriz de embeddings; em cada camada, Wq, Wk, Wv, Wo, W1, W2, vieses e os γ e β da normalização; e a projeção final para o vocabulário. Durante a inferência eles são fixos. Todo o "conhecimento" do modelo está nesses valores.
Objetivo de treinamento. Modelos geradores são treinados para prever o próximo token. Dada a sequência x₁…x_T, minimiza-se a entropia cruzada média entre a distribuição prevista e o token que de fato veio a seguir:
$$\mathcal{L} = -\frac{1}{T}\sum_{t=1}^{T} \log p_\theta!\left(x_t \mid x_{<t}\right), \qquad \mathrm{PPL} = e^{\mathcal{L}}$$
O BERT usa um objetivo diferente, a predição de tokens mascarados (masked language modeling), em que se escondem alguns tokens e o modelo os reconstrói olhando para os dois lados (Devlin et al., 2019). Em ambos os casos não há rótulo humano de significado: o sinal é o próprio texto. Isso é o que fundamenta a ideia de que a desambiguação é uma estratégia emergente para reduzir o erro de predição (seção 13).
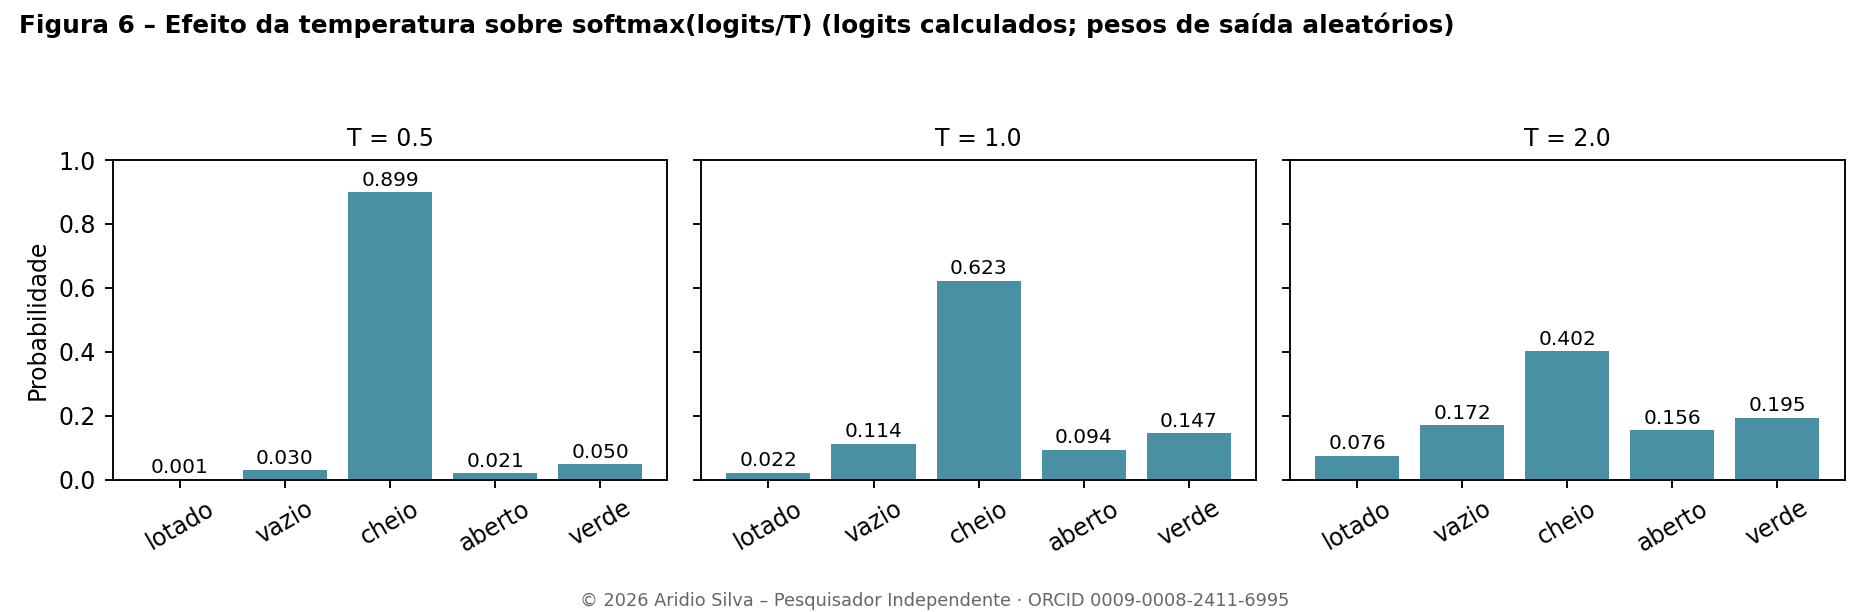
Exemplo numérico. Na saída calculada da seção 11 (pesos aleatórios), a probabilidade atribuída a "lotado" é p = 0,022 e a atribuída a "cheio" é 0,623. Se o token correto fosse "lotado", a perda seria −ln(0,022) = 3,806; se fosse "cheio", −ln(0,623) = 0,473. O gradiente da perda em relação aos logits é simplesmente p − y, onde y é o vetor one-hot do token correto: para o alvo "lotado", [−0,978; 0,114; 0,623; 0,094; 0,147], ou seja, o treino empurra o logit de "lotado" para cima e os dos demais para baixo, proporcionalmente ao erro.
Retropropagação e otimização. O gradiente é propagado de volta por todas as camadas pela regra da cadeia, algoritmo conhecido como backpropagation (Rumelhart et al., 1986), e os pesos são atualizados por um otimizador. O Transformer original usou o Adam (Kingma e Ba, 2015) com taxa de aprendizado que cresce linearmente durante um período de aquecimento e depois decai, além de dropout e label smoothing (Vaswani et al., 2017). A variante AdamW, que desacopla a regularização por decaimento de pesos do passo adaptativo, é a escolha comum em modelos atuais (Loshchilov e Hutter, 2019).
Paralelismo no treino e sequência na inferência. No treino, com a máscara causal, todas as posições são calculadas ao mesmo tempo (o texto correto já é conhecido). Na inferência, o token t + 1 depende do token t escolhido, então a geração é sequencial, e o KV cache (seção 6) evita refazer o passado.
Fases de treinamento. Uma prática comum é o pré-treinamento em grande volume de texto bruto, seguido de ajustes para uso específico: fine-tuning supervisionado e alinhamento com preferências humanas, como na abordagem de aprendizado por reforço com feedback humano (Ouyang et al., 2022).
Escala. A perda de modelos de linguagem cai de forma regular, segundo leis de potência, com o aumento de parâmetros, dados e computação (Kaplan et al., 2020). Hoffmann et al. (2022) mostraram que, para um orçamento de computação fixo, parâmetros e volume de dados devem crescer em proporção, e que muitos modelos grandes estavam subtreinados em dados.
11. Etapa 9 – Saída: logits, softmax e decodificação
Por que esta etapa é necessária. A última camada entrega um vetor de d_model números, e o usuário precisa de um token. Os logits mapeiam esse vetor para uma pontuação por token do vocabulário. O softmax os converte em uma distribuição válida (positiva, somando 1), indispensável para a perda de entropia cruzada no treino e para sortear ou escolher o token na inferência. A temperatura e as regras de decodificação são necessárias porque escolher sempre o token mais provável tende a produzir texto repetitivo e degenerado, enquanto sortear sem restrição inclui tokens improváveis; as estratégias top-k e top-p equilibram esses extremos (Holtzman et al., 2020).
Logits. O vetor da última camada na posição atual (h_final, de dimensão d_model) é multiplicado por uma matriz de saída W_out de dimensão d_model × |V|. O resultado são os logits: um número real, sem limites, para cada token do vocabulário. Em muitos modelos, W_out é a transposta da matriz de embeddings (weight tying; Press e Wolf, 2017; Vaswani et al., 2017).
Softmax e temperatura. O softmax converte logits em probabilidades que somam 1. A temperatura T divide os logits antes do softmax: T < 1 concentra a probabilidade nos tokens mais prováveis (saída mais determinística), e T > 1 a espalha (saída mais variada). O uso de temperatura no softmax foi popularizado na destilação de modelos (Hinton et al., 2015).
$$p_i = \frac{e^{z_i / T}}{\sum_{j} e^{z_j / T}}$$
Exemplo numérico. Vocabulário didático de cinco tokens e logits calculados a partir do vetor da posição "estava" (pesos de saída aleatórios, sem treino): lotado −0,818; vazio 0,815; cheio 2,516; aberto 0,626; verde 1,070. Com T = 1, o softmax dá lotado 0,022; vazio 0,114; cheio 0,623; aberto 0,094; verde 0,147 (soma 1,000). Com T = 0,5, "cheio" sobe para 0,899; com T = 2, cai para 0,402 e a distribuição se achata (Figura 6). Em um modelo treinado, esses pesos teriam sido ajustados para que palavras plausíveis após "O banco estava", como "lotado", recebessem probabilidade alta; aqui o exemplo serve apenas para mostrar a aritmética.
Estratégias de decodificação. A escolha do token a partir da distribuição é uma etapa separada do modelo:
- Gulosa (greedy): escolhe sempre o token de maior probabilidade. No exemplo: "cheio".
- Amostragem: sorteia o token conforme as probabilidades.
- Top-k: restringe o sorteio aos k tokens mais prováveis e renormaliza (Fan et al., 2018). Com k = 2: cheio 0,809 e verde 0,191.
- Top-p (nucleus): restringe ao menor conjunto cuja probabilidade acumulada atinge p (Holtzman et al., 2020). Com p = 0,9, o conjunto é {cheio, verde, vazio, aberto} (acumulado 0,978), renormalizado para 0,637; 0,150; 0,117; 0,096.
- Busca em feixe (beam search): mantém várias sequências candidatas em paralelo e escolhe a de maior probabilidade total.
Fechamento do ciclo. O token escolhido é anexado à entrada e todo o fluxo se repete, aproveitando o KV cache, até que um token de fim de sequência seja gerado ou se atinja o limite de comprimento.
12. Estudo de caso: desambiguação de "banco" e interpretabilidade
Função desta seção. Integra as etapas 3 a 9 em um único exemplo mínimo. É necessária porque, sem ela, cada mecanismo ficaria descrito isoladamente, e não se veria como eles juntos resolvem a ambiguidade de "banco".
O problema. "Banco" pode designar uma instituição financeira ou um assento. A tokenização atribui o mesmo ID nos dois casos, e o embedding de entrada é o mesmo (seções 3 e 4). O modelo não consulta um dicionário nem aplica regras do tipo se … então. O que distingue os sentidos é o contexto: a atenção mistura no vetor de "banco" informação dos tokens vizinhos, e esse vetor misturado, nas camadas seguintes, passa a se comportar de modo diferente.
Evidência empírica. Em modelos treinados, os vetores contextualizados da mesma palavra tendem a formar agrupamentos separados conforme o sentido (Reif et al., 2019), e as representações ficam mais específicas ao contexto nas camadas mais altas (Ethayarajh, 2019).
Demonstração numérica (brinquedo didático). Embeddings de 4 dimensões escolhidos à mão, com eixos [dinheiro, assento, pessoas, madeira]: banco = [0,7; 0,7; 0; 0] (ambíguo), lotado = [0; 0; 1; 0], clientes = [0,8; 0; 0,7; 0], praça = [0; 0,8; 0; 0,2], madeira = [0; 0,3; 0; 1], velho = [0; 0,2; 0; 0,5], estava = [0; 0; 0,1; 0]; os artigos "O", "da" e "de" são vetores nulos. Atenção de uma cabeça com Wq = Wk = 2·I, Wv = I e d_k = 4. Em cada contexto, calcula-se o vetor contextualizado de "banco" e compara-se, por similaridade de cosseno, com dois protótipos: instituição financeira = [1; 0; 0,5; 0] e assento = [0; 1; 0; 0,5].
| Contexto | Maior peso de atenção de "banco" | Vetor contextualizado | Cosseno com instituição | Cosseno com assento |
|---|---|---|---|---|
| Isolado: "banco" | 1,000 (ele mesmo) | [0,700; 0,700; 0; 0] | 0,632 | 0,632 |
| "O banco estava lotado de clientes" | 0,501 (ele mesmo); 0,216 (clientes) | [0,524; 0,351; 0,229; 0] | 0,851 | 0,468 |
| "O banco da praça estava velho de madeira" | 0,443 (ele mesmo); 0,191 (praça) | [0,310; 0,509; 0,006; 0,175] | 0,452 | 0,858 |
Isolado, o vetor é equidistante dos dois sentidos (0,632 contra 0,632). No contexto de "lotado de clientes", ele se aproxima da instituição (0,851 contra 0,468). No contexto de "praça … madeira", aproxima-se do assento (0,858 contra 0,452). O mecanismo é o mesmo nos dois casos; só mudam os vizinhos. Em um modelo real, os pesos Wq, Wk, Wv e o conhecimento nas FFNs resultam do treino, e a distinção se distribui por muitas cabeças e camadas, não por um único passo como neste brinquedo.
Por que isso surge do treino. Para prever bem a palavra seguinte em frases como "O banco estava lotado de ___", o modelo precisa registrar se a frase trata de uma agência ou de um assento. Estatisticamente, "lotado" co-ocorre com clientes, filas e agências. A representação do sentido é, portanto, um subproduto útil da minimização do erro de predição (seção 13).
Cuidados na interpretação dos mapas de atenção. Visualizar pesos de atenção (por exemplo, com ferramentas como a de Vig, 2019) é um primeiro passo de análise, mas peso de atenção não equivale a explicação causal: pesos diferentes podem produzir a mesma previsão, e a atenção de uma camada é apenas uma parte do cálculo (Jain e Wallace, 2019; Wiegreffe e Pinter, 2019). Conclusões sobre o que o modelo "usa" exigem experimentos de intervenção ou análise de circuitos (Elhage et al., 2021; Olsson et al., 2022).
13. Propriedades emergentes e leis de escala
Função desta seção. Explica por que um comportamento como a desambiguação pode existir sem ter sido programado, o que liga o resultado da seção 12 ao treino da seção 10. É necessária para situar o debate sobre emergência sem afirmar mais do que a literatura sustenta.
Conceito. Uma propriedade emergente é uma característica do sistema como um todo que não está programada em nenhum de seus componentes e surge da interação entre eles em grande número (Anderson, 1972). No Transformer, o código contém apenas multiplicações de matrizes, somas, normalizações e softmax; a meta de treino é apenas prever o próximo token. Nada ali menciona sentidos de palavras, sintaxe ou raciocínio, e ainda assim representações desse tipo aparecem nos pesos aprendidos (seções 9 e 12). A analogia usual é a do formigueiro: nenhuma formiga individual "sabe" construir uma ponte, mas a colônia a constrói.
Habilidades emergentes com a escala. Wei et al. (2022a) definem como emergente uma habilidade ausente em modelos menores e presente em modelos maiores, de modo que não se prevê sua aparição por extrapolação simples das curvas dos modelos menores. Exemplos discutidos na literatura incluem o few-shot prompting em grandes modelos (Brown et al., 2020) e o raciocínio por cadeia de pensamento (Wei et al., 2022b).
Leis de escala. Enquanto a perda média de predição melhora de modo suave e previsível com parâmetros, dados e computação (Kaplan et al., 2020; Hoffmann et al., 2022), o desempenho em tarefas específicas pode parecer mudar de forma abrupta. Ganguli et al. (2022) discutem essa combinação de previsibilidade na perda e surpresa nas capacidades.
Debate: emergência real ou efeito da métrica? Schaeffer et al. (2023) argumentam que parte dos saltos observados decorre de métricas descontínuas, como acerto exato, e que métricas contínuas sobre os mesmos modelos mostram progresso gradual. O debate permanece aberto, e a literatura recomenda cautela ao afirmar que uma capacidade "surge de repente".
Não confundir com grokking. O termo grokking designa um fenômeno distinto: em tarefas algorítmicas pequenas, a generalização aparece muito depois de o modelo já ter memorizado o conjunto de treino (Power et al., 2022), e foi analisado com técnicas de interpretabilidade mecanicista (Nanda et al., 2023). Ele ocorre ao longo do tempo de treino, e a emergência por escala ocorre ao longo do tamanho do modelo.
Aplicação ao caso "banco". A desambiguação de sentidos comuns já é observada em modelos relativamente pequenos, como o BERT-base, com 110 milhões de parâmetros (Reif et al., 2019). Portanto, não há base para afirmar um limiar fixo de camadas ou de parâmetros a partir do qual essa capacidade "aparece". O que a literatura sustenta é que a capacidade resulta do treino e que sua qualidade e abrangência crescem com a escala.
Implicações. Se capacidades podem surgir sem serem projetadas, a avaliação e a interpretabilidade tornam-se parte central do desenvolvimento: é preciso testar o modelo, e não apenas ler o código, para saber o que ele faz (Ganguli et al., 2022; Olsson et al., 2022).
14. Limitações, ressalvas e debates em aberto
Função desta seção. Delimita o que o documento mostra e o que não mostra. É necessária porque os exemplos são simplificados e porque o próprio mecanismo tem limites e pontos em debate que o leitor deve conhecer.
Limitações deste documento.
- Os exemplos numéricos usam dimensões minúsculas, uma única cabeça e pesos escolhidos à mão ou aleatórios. Mostram a aritmética, não o comportamento de um modelo treinado.
- Foram omitidos, por simplicidade: vieses em todas as projeções, dropout, a atenção cruzada (cross-attention) do decodificador do modelo original, e variantes como misturas de especialistas (mixture of experts) e arquiteturas alternativas à atenção, como modelos de espaço de estados (Gu e Dao, 2023).
- Detalhes como o número exato de camadas, a função de ativação, o tipo de normalização e a codificação posicional variam entre modelos e nem sempre são divulgados.
Debates e limitações do próprio mecanismo.
- Atenção e explicação. Pesos de atenção não são, por si sós, uma explicação confiável do comportamento do modelo (Jain e Wallace, 2019; Wiegreffe e Pinter, 2019).
- Custo quadrático e contexto longo. O custo da atenção cresce com o quadrado do comprimento da sequência, e modelos de contexto longo podem usar pior a informação situada no meio do contexto (Liu et al., 2024).
- Alucinação. O modelo calcula tokens prováveis dado o contexto; não há, na arquitetura, um passo que verifique a veracidade do que gera. Saídas fluentes porém factualmente incorretas são um problema documentado (Ji et al., 2023).
- "Só estatística" ou "modelo de mundo"? Há posições divergentes. Uma sustenta que modelos treinados apenas com forma textual não alcançam compreensão de significado (Bender e Koller, 2020). Outra reúne evidências de que modelos treinados para prever o próximo token podem construir representações internas de estruturas do domínio, como o estado de um tabuleiro de Othello (Li et al., 2023). A caracterização de "compreensão" permanece em discussão, e este documento se limita a descrever os mecanismos e as evidências citadas.
- Emergência. Ver seção 13: a natureza dos saltos de capacidade com a escala é debatida (Wei et al., 2022a; Schaeffer et al., 2023).
15. Da inferência à execução governada: implicações para o SGAEIA
Função desta seção. Esta seção estabelece a ponte entre a mecânica interna do Transformer e o problema arquitetural investigado pelo SGAEIA. Sua classificação epistemológica é SGAEIA Interpretation: trata-se de uma leitura conceitual e pública dos mecanismos descritos neste artigo, e não de evidência de implementação, eficácia, certificação ou validação em produção do SGAEIA.
A inferência termina, no limite deste artigo, com uma distribuição de probabilidades e a seleção de um token. Um sistema agentivo acrescenta outras camadas: memória, planejamento, ferramentas, credenciais, delegação, políticas, runtime e capacidade de modificar estado externo. Por isso, a saída do modelo deve ser tratada como uma proposta ou sinal computacional, não como autorização para produzir um efeito. Essa separação entre capacidade do modelo e ação governada é central na arquitetura pública do SGAEIA e em sua análise da transição do modelo para o agente (Silva, 2026a; Silva, 2026b; Silva, 2026c).
| Componente observado | O que o mecanismo produz | Questão de governança associada | Interpretação SGAEIA |
|---|---|---|---|
| Entrada, tokenização e contexto | Representação numérica condicionada pelos dados fornecidos | Origem, integridade, sensibilidade e limites do contexto | A proveniência da entrada deve permanecer distinguível da interpretação produzida pelo modelo |
| Atenção, camadas e KV cache | Estado contextual intermediário e reutilização de informação anterior | Confidencialidade, isolamento, retenção e contaminação de estado | Estado útil à inferência não equivale a memória autorizada para qualquer finalidade |
| Logits, softmax e amostragem | Distribuição probabilística e escolha possivelmente não determinística | Incerteza, repetibilidade e adequação do resultado ao risco | Probabilidade alta não constitui verdade, conformidade ou permissão |
| Token ou plano produzido | Conteúdo que pode sugerir uma decisão ou ação | Quem pode aceitar, rejeitar ou restringir a proposta | Capacidade não equivale a autoridade; proposta não equivale a permissão |
| Chamada de ferramenta e efeito externo | Alteração potencial de dados, serviços ou ambiente | Identidade, escopo, política, delegação, revogação e consequência | O efeito deve atravessar uma fronteira de execução governada externa ao modelo |
Essa separação é particularmente importante porque interpretabilidade parcial não elimina a necessidade de controles externos. Pesos de atenção, estados intermediários, explicações geradas e cadeias de raciocínio podem fornecer sinais úteis, mas nenhum deles demonstra sozinho a causa completa de uma decisão, a legitimidade de uma ação ou a estabilidade futura do comportamento. A formulação pública do SGAEIA trata essa limitação como um problema de supervisão: quanto menor a confiança na compreensão do processo interno, menos a segurança pode depender exclusivamente dessa compreensão e mais deve depender de autoridade limitada, execução mediada, revogação e recuperação (Silva, 2026d).
Também é necessário distinguir observabilidade de evidência. Registrar prompt e resposta ajuda a reconstruir parte da interação, mas não basta para demonstrar qual identidade iniciou a operação, que política estava vigente, qual autoridade permitiu uma ferramenta, que delegações ocorreram e qual efeito foi realmente observado. Em sistemas distribuídos ou multiagentes, traces e spans ajudam a reconstruir trajetórias, enquanto avaliação e evidência governada respondem a perguntas diferentes sobre resultado, legitimidade e assurance. Essa relação entre rastreamento, avaliação e evidência é analisada na pesquisa pública do SGAEIA sobre execução de agentes (Silva, 2026e).
O vínculo com o SGAEIA não transforma os exemplos didáticos deste artigo em controles arquiteturais. A tabela acima organiza questões de pesquisa e propriedades públicas em nível alto, preservando a fronteira entre explicação e mecanismo privado. A conclusão operacional é limitada, mas importante: entender como um LLM produz um token é condição necessária para governar um sistema baseado em LLMs, porém não é condição suficiente para autorizar, observar, conter ou assegurar os efeitos desse sistema.
16. Conclusão
Abrir a caixa-preta da inferência permite acompanhar a transformação do texto em IDs, vetores, relações de atenção, representações contextuais, logits e probabilidades. Os exemplos reduzidos mostram a aritmética de cada etapa e tornam explícito onde entram os pesos aprendidos, as máscaras, a normalização, a não linearidade e a regra de decodificação. Eles também deixam claro o limite da demonstração: números didáticos explicam o mecanismo, mas não medem um modelo real nem sustentam, por si sós, afirmações sobre raciocínio, segurança ou confiabilidade.
O estudo de caso de “banco” evidencia por que a representação de um token não permanece estática depois que o contexto atravessa as camadas. Ao mesmo tempo, as ressalvas sobre mapas de atenção, emergência e alucinação impedem que a explicação matemática seja confundida com transparência causal completa. A inferência é probabilística, contextual e dependente de pesos, configuração e estratégia de decodificação; sua análise deve preservar essas condições em vez de converter fluência em certeza.
Para o SGAEIA, a principal implicação é a separação entre inferência e efeito. O modelo pode propor um caminho, mas a autoridade determina se esse caminho é alcançável, e políticas e evidências determinam se ele pode tornar-se uma ação legítima. Portanto, abrir a caixa-preta de um sistema agentivo exige explicar não apenas como o token foi produzido, mas também quem autorizou cada ação, sob quais limites, com quais registros e com que capacidade de interrupção, revogação e recuperação.
17. Glossário de termos, conceitos e técnicas
Função desta seção. Fixa a terminologia usada no texto. É necessária porque os termos vêm de áreas distintas (linguística computacional, otimização, interpretabilidade) e muitos têm nomes em inglês sem tradução consolidada.
Ordem alfabética. A coluna "Seção" indica onde o termo é desenvolvido.
| Termo | Definição | Seção |
|---|---|---|
| Adam / AdamW | Otimizadores baseados em gradiente com taxa de aprendizado adaptativa por parâmetro; o AdamW separa o decaimento de pesos do passo de atualização. | 10 |
| ALiBi | Técnica de posição que soma aos scores de atenção um viés linear proporcional à distância entre tokens. | 4 |
| Alucinação | Saída fluente porém factualmente incorreta ou sem sustentação no contexto. | 14 |
| Atenção (attention) | Operação que calcula uma média ponderada de vetores, com pesos obtidos por compatibilidade entre uma consulta e chaves. | 5 |
| Atenção cruzada (cross-attention) | Atenção em que as Queries vêm de uma sequência (decodificador) e as Keys e Values de outra (codificador). | 14 |
| Autoridade | Conjunto legitimamente concedido e delimitado de ações, recursos, alvos, condições e efeitos que um ator pode exercer; capacidade técnica não implica autoridade. | 15 |
| Autorregressivo | Que gera um elemento de cada vez, condicionado aos elementos já gerados. | 2, 11 |
| Backpropagation | Algoritmo que calcula gradientes da perda em relação a todos os pesos, propagando o erro da saída para a entrada pela regra da cadeia. | 10 |
| Beam search | Busca em feixe: mantém várias sequências candidatas e escolhe a de maior probabilidade total. | 11 |
| BERT | Modelo somente codificador, treinado com predição de tokens mascarados e atenção bidirecional. | 2, 10 |
| BPE (Byte Pair Encoding) | Algoritmo de tokenização que funde iterativamente o par de símbolos adjacentes mais frequente. | 3 |
| Cabeça de atenção (head) | Uma das h atenções paralelas da multi-head attention, com matrizes Wq, Wk, Wv próprias. | 6 |
| Camada (layer) | Um bloco Transformer completo: atenção, Add & Norm, FFN, Add & Norm. | 9 |
| Chain-of-thought | Técnica de prompt em que o modelo gera passos intermediários de raciocínio antes da resposta. | 13 |
| Codificação posicional | Vetor somado ao embedding para informar a posição do token na sequência. | 4 |
| Codificador / decodificador | Pilhas de camadas: o codificador lê a entrada com atenção bidirecional; o decodificador gera a saída com atenção causal. | 2 |
| Conexão residual | Soma da entrada de uma subcamada à sua saída, y = x + f(x). | 7 |
| Contexto | Conjunto de tokens anteriores (ou de toda a sequência, em modelos bidirecionais) que condiciona uma previsão. | 5, 12 |
| Cosseno (similaridade de) | Medida de alinhamento entre dois vetores: produto escalar dividido pelo produto das normas, entre −1 e 1. | 12 |
| d_model, d_k, d_ff | Dimensão do modelo, de cada cabeça de atenção (d_model / h) e da camada oculta da FFN, respectivamente. | 4, 6, 8 |
| Decodificação | Regra que escolhe o token de saída a partir da distribuição de probabilidade (gulosa, top-k, top-p, feixe). | 11 |
| Dropout | Regularização que zera aleatoriamente ativações durante o treino. | 10 |
| Embedding | Vetor denso aprendido que representa um token (ou uma posição). | 4 |
| Emergência / propriedade emergente | Característica do sistema que surge da interação de muitos componentes sem estar programada neles. | 13 |
| Entropia cruzada | Função de perda que mede o quanto a distribuição prevista se afasta do token correto: −log p(correto). | 10 |
| Evidência governada | Registro atribuível e verificável que conecta contexto, identidade, política, autoridade, execução e efeito observado para sustentar uma afirmação de governança ou assurance. | 15 |
| Execução governada | Mediação externa ao modelo que avalia identidade, autoridade, política, risco e evidência antes de permitir que uma proposta produza efeito. | 15 |
| Few-shot | Uso do modelo com poucos exemplos fornecidos no próprio prompt, sem atualizar pesos. | 13 |
| Fine-tuning | Treino adicional, após o pré-treinamento, para uma tarefa ou comportamento específico. | 10 |
| Forward pass | Passagem da entrada pelas camadas até a saída, sem atualizar pesos na inferência. | 2 |
| Feed-forward (FFN) | Rede de duas camadas lineares com não linearidade, aplicada a cada posição de forma independente. | 8 |
| GELU | Função de ativação suave, usada em BERT e GPT. | 8 |
| Gradiente | Vetor de derivadas da perda em relação aos pesos; indica como ajustá-los. | 10 |
| Grokking | Generalização que surge muito depois da memorização do conjunto de treino em tarefas algorítmicas pequenas. | 13 |
| Induction head | Circuito de duas cabeças que localiza ocorrências passadas de um padrão e prevê sua continuação. | 9 |
| Inferência | Execução do modelo treinado, com pesos fixos, para gerar uma saída. | 2 |
| Interpretabilidade | Conjunto de métodos para entender o que o modelo computa e por quê. | 12 |
| Key (chave) | Projeção X·Wk que representa o que cada token oferece para ser encontrado. | 5 |
| KV cache | Armazenamento dos Keys e Values já calculados, reaproveitados a cada novo token gerado. | 6 |
| Label smoothing | Suavização do alvo no treino, reduzindo a confiança extrema nas previsões. | 10 |
| LayerNorm | Normalização por token ao longo das dimensões, com escala γ e deslocamento β aprendidos. | 7 |
| Lei de escala | Relação regular (lei de potência) entre perda e parâmetros, dados e computação. | 10, 13 |
| Logit | Pontuação real, sem limites, atribuída a cada token do vocabulário antes do softmax. | 11 |
| Logit lens / tuned lens | Técnicas que projetam estados intermediários sobre o vocabulário para observar a previsão em cada camada. | 9 |
| Masked language modeling | Objetivo de treino em que tokens ocultados são reconstruídos a partir do contexto bilateral. | 10 |
| Máscara causal | Máscara que impede cada posição de atender a posições futuras, atribuindo −∞ aos scores correspondentes. | 6 |
| Mixture of experts (MoE) | Arquitetura em que cada token ativa apenas um subconjunto de subredes FFN especializadas. | 14 |
| Multi-head attention | Execução de h atenções em paralelo em subespaços distintos, com saídas concatenadas e projetadas por Wo. | 6 |
| One-hot | Vetor com 1 na posição do token correto e 0 nas demais. | 10 |
| Parâmetro / peso | Número ajustável aprendido durante o treino. | 10 |
| Perplexidade (PPL) | Exponencial da perda média por token; mede a "surpresa" do modelo com o texto. | 10 |
| Pré-LN / Post-LN | Posição da normalização: antes (Pré-LN) ou depois (Post-LN) da soma residual. | 7 |
| Pré-treinamento | Fase inicial de treino em grande volume de texto bruto. | 10 |
| Probing (sondagem) | Treino de classificadores simples sobre representações internas para testar que informação elas contêm. | 9 |
| Produto escalar | Soma dos produtos componente a componente de dois vetores; mede alinhamento. | 5 |
| Query (consulta) | Projeção X·Wq que representa o que cada token procura. | 5 |
| ReLU | Função de ativação max(0, x). | 8 |
| RLHF | Aprendizado por reforço com feedback humano, usado para alinhar o modelo a preferências. | 10 |
| RMSNorm | Normalização pela raiz do valor quadrático médio, sem subtrair a média. | 7 |
| RoPE | Codificação posicional que rotaciona Q e K conforme a posição, expressando posição relativa. | 4 |
| Self-attention | Atenção em que Queries, Keys e Values vêm da mesma sequência. | 5 |
| SentencePiece | Biblioteca de tokenização de subpalavras (BPE ou Unigram) que opera sobre texto bruto. | 3 |
| SGAEIA | Secure Governed Autonomous Edge Intelligence Architecture; programa de pesquisa e arquitetura de referência aberta para AI autônoma e distribuída governada. | 15 |
| Softmax | Função que converte um vetor de números em probabilidades positivas que somam 1. | 5, 11 |
| SwiGLU | Ativação com porta (GLU) usando a função Swish, comum em modelos recentes. | 8 |
| Temperatura (T) | Divisor dos logits antes do softmax; controla o grau de concentração da distribuição. | 11 |
| Token | Unidade do vocabulário (palavra, subpalavra, byte ou símbolo) tratada como elemento da sequência. | 3 |
| Token contextualizado | Vetor de um token após a atenção, que incorpora informação dos demais tokens. | 5 |
| Tokenização | Conversão de texto em sequência de tokens e IDs. | 3 |
| Top-k / Top-p (nucleus) | Estratégias de amostragem que restringem a escolha aos k tokens mais prováveis ou ao menor conjunto com probabilidade acumulada p. | 11 |
| Transformer | Arquitetura de rede neural baseada em atenção, sem recorrência nem convolução. | 1, 2 |
| Unigram LM | Método de tokenização que parte de um vocabulário grande e poda os itens menos úteis. | 3 |
| Value (valor) | Projeção X·Wv que representa o conteúdo repassado por cada token. | 5 |
| Vocabulário | Conjunto finito de tokens reconhecidos pelo modelo. | 3 |
| Warm-up | Fase inicial do treino em que a taxa de aprendizado cresce gradualmente. | 7, 10 |
| Weight tying | Compartilhamento da matriz de embeddings com a projeção de saída. | 4, 11 |
| WordPiece | Tokenização de subpalavras que escolhe fusões pelo ganho de verossimilhança. | 3 |
18. Referências bibliográficas
Função desta seção. Permite que cada afirmação técnica seja rastreada até a fonte. É necessária para que o leitor verifique os fatos e para distinguir o que foi conferido em fonte do que ainda precisa de conferência.
Nota de conferência (20/10/2026). Os itens marcados com [conferido] tiveram título, autores, veículo e, quando indicado, páginas verificados em página oficial ou de indexação durante a elaboração deste documento. Foram conferidos 12 dos 69 itens; os 57 demais não foram verificados em fonte e seguem os dados bibliográficos usuais de cada publicação; recomenda-se conferir páginas, volumes e DOI antes de qualquer submissão formal. Auditoria de links (20/10/2026). Cada entrada recebeu um endereço https. Os marcados com [link auditado] (14 de 69) foram devolvidos por busca na web e a página corresponde ao título e ao identificador citados; não foi feita verificação de resposta HTTP. Os demais foram formados a partir do identificador (arXiv, ACL Anthology, DOI ou página do editor) e não puderam ser abertos neste ambiente; devem ser tratados como não auditados. O link do item Gage (1994) aponta para uma cópia hospedada por terceiros. Os identificadores arXiv permitem localizar cada trabalho.
- Ainslie, J.; Lee-Thorp, J.; de Jong, M.; Zemlyanskiy, Y.; Lebrón, F.; Sanghai, S. (2023). GQA: Training generalized multi-query Transformer models from multi-head checkpoints. In: EMNLP 2023. arXiv:2305.13245. https://arxiv.org/abs/2305.13245
- Anderson, P. W. (1972). More is different. Science, 177(4047), 393–396. https://doi.org/10.1126/science.177.4047.393
- Ba, J. L.; Kiros, J. R.; Hinton, G. E. (2016). Layer normalization. arXiv:1607.06450. https://arxiv.org/abs/1607.06450
- Bahdanau, D.; Cho, K.; Bengio, Y. (2015). Neural machine translation by jointly learning to align and translate. In: ICLR 2015. arXiv:1409.0473. https://arxiv.org/abs/1409.0473
- Belrose, N.; Furman, Z.; Smith, L.; Halawi, D.; Ostrovsky, I.; McKinney, L.; Biderman, S.; Steinhardt, J. (2023). Eliciting latent predictions from Transformers with the tuned lens. arXiv:2303.08112. https://arxiv.org/abs/2303.08112 [link auditado] [conferido]
- Bender, E. M.; Koller, A. (2020). Climbing towards NLU: On meaning, form, and understanding in the age of data. In: ACL 2020, p. 5185–5198. https://aclanthology.org/2020.acl-main.463/
- Bengio, Y.; Ducharme, R.; Vincent, P.; Jauvin, C. (2003). A neural probabilistic language model. Journal of Machine Learning Research, 3, 1137–1155. https://www.jmlr.org/papers/v3/bengio03a.html
- Brown, T. B. et al. (2020). Language models are few-shot learners. In: NeurIPS 33. arXiv:2005.14165. https://arxiv.org/abs/2005.14165
- Clark, K.; Khandelwal, U.; Levy, O.; Manning, C. D. (2019). What does BERT look at? An analysis of BERT's attention. In: BlackboxNLP Workshop at ACL 2019, p. 276–286. arXiv:1906.04341. https://arxiv.org/abs/1906.04341 [link auditado]
- Dao, T.; Fu, D. Y.; Ermon, S.; Rudra, A.; Ré, C. (2022). FlashAttention: Fast and memory-efficient exact attention with IO-awareness. In: NeurIPS 35. arXiv:2205.14135. https://arxiv.org/abs/2205.14135
- Devlin, J.; Chang, M.-W.; Lee, K.; Toutanova, K. (2019). BERT: Pre-training of deep bidirectional Transformers for language understanding. In: NAACL-HLT 2019, p. 4171–4186. arXiv:1810.04805. https://arxiv.org/abs/1810.04805
- Elhage, N. et al. (2021). A mathematical framework for Transformer circuits. Transformer Circuits Thread. https://transformer-circuits.pub/2021/framework/index.html
- Ethayarajh, K. (2019). How contextual are contextualized word representations? Comparing the geometry of BERT, ELMo, and GPT-2 embeddings. In: EMNLP-IJCNLP 2019, p. 55–65. arXiv:1909.00512. https://aclanthology.org/D19-1006/ [link auditado] [conferido]
- Fan, A.; Lewis, M.; Dauphin, Y. (2018). Hierarchical neural story generation. In: ACL 2018, p. 889–898. arXiv:1805.04833. https://arxiv.org/abs/1805.04833
- Gage, P. (1994). A new algorithm for data compression. The C Users Journal, 12(2), 23–38. https://www.derczynski.com/papers/archive/BPE_Gage.pdf
- Ganguli, D. et al. (2022). Predictability and surprise in large generative models. In: ACM FAccT 2022, p. 1747–1764. arXiv:2202.07785. https://arxiv.org/abs/2202.07785
- Geva, M.; Schuster, R.; Berant, J.; Levy, O. (2021). Transformer feed-forward layers are key-value memories. In: EMNLP 2021, p. 5484–5495. arXiv:2012.14913. https://aclanthology.org/2021.emnlp-main.446 [link auditado] [conferido]
- Gu, A.; Dao, T. (2023). Mamba: Linear-time sequence modeling with selective state spaces. arXiv:2312.00752. https://arxiv.org/abs/2312.00752
- He, K.; Zhang, X.; Ren, S.; Sun, J. (2016). Deep residual learning for image recognition. In: CVPR 2016, p. 770–778. arXiv:1512.03385. https://arxiv.org/abs/1512.03385
- Hendrycks, D.; Gimpel, K. (2016). Gaussian error linear units (GELUs). arXiv:1606.08415. https://arxiv.org/abs/1606.08415
- Hinton, G.; Vinyals, O.; Dean, J. (2015). Distilling the knowledge in a neural network. arXiv:1503.02531. https://arxiv.org/abs/1503.02531
- Hoffmann, J. et al. (2022). Training compute-optimal large language models. In: NeurIPS 35. arXiv:2203.15556. https://arxiv.org/abs/2203.15556
- Holtzman, A.; Buys, J.; Du, L.; Forbes, M.; Choi, Y. (2020). The curious case of neural text degeneration. In: ICLR 2020. arXiv:1904.09751. https://arxiv.org/abs/1904.09751
- Jain, S.; Wallace, B. C. (2019). Attention is not explanation. In: NAACL-HLT 2019, p. 3543–3556. arXiv:1902.10186. https://aclanthology.org/N19-1357/ [link auditado] [conferido]
- Jawahar, G.; Sagot, B.; Seddah, D. (2019). What does BERT learn about the structure of language? In: ACL 2019, p. 3651–3657. https://aclanthology.org/P19-1356/ [link auditado] [conferido]
- Ji, Z. et al. (2023). Survey of hallucination in natural language generation. ACM Computing Surveys, 55(12), art. 248. arXiv:2202.03629. https://arxiv.org/abs/2202.03629 [link auditado]
- Kaplan, J. et al. (2020). Scaling laws for neural language models. arXiv:2001.08361. https://arxiv.org/abs/2001.08361
- Kingma, D. P.; Ba, J. (2015). Adam: A method for stochastic optimization. In: ICLR 2015. arXiv:1412.6980. https://arxiv.org/abs/1412.6980
- Kudo, T. (2018). Subword regularization: Improving neural network translation models with multiple subword candidates. In: ACL 2018, p. 66–75. arXiv:1804.10959. https://arxiv.org/abs/1804.10959
- Kudo, T.; Richardson, J. (2018). SentencePiece: A simple and language independent subword tokenizer and detokenizer for neural text processing. In: EMNLP 2018 (System Demonstrations), p. 66–71. arXiv:1808.06226. https://arxiv.org/abs/1808.06226
- Li, K.; Hopkins, A. K.; Bau, D.; Viégas, F.; Pfister, H.; Wattenberg, M. (2023). Emergent world representations: Exploring a sequence model trained on a synthetic task. In: ICLR 2023. arXiv:2210.13382. https://arxiv.org/abs/2210.13382
- Liu, N. F. et al. (2024). Lost in the middle: How language models use long contexts. Transactions of the ACL, 12, 157–173. arXiv:2307.03172. https://aclanthology.org/2024.tacl-1.9/ [link auditado] [conferido]
- Loshchilov, I.; Hutter, F. (2019). Decoupled weight decay regularization. In: ICLR 2019. arXiv:1711.05101. https://arxiv.org/abs/1711.05101
- Michel, P.; Levy, O.; Neubig, G. (2019). Are sixteen heads really better than one? In: NeurIPS 32. arXiv:1905.10650. https://arxiv.org/abs/1905.10650
- Mikolov, T.; Chen, K.; Corrado, G.; Dean, J. (2013). Efficient estimation of word representations in vector space. arXiv:1301.3781. https://arxiv.org/abs/1301.3781
- Nanda, N.; Chan, L.; Lieberum, T.; Smith, J.; Steinhardt, J. (2023). Progress measures for grokking via mechanistic interpretability. In: ICLR 2023. arXiv:2301.05217. https://arxiv.org/abs/2301.05217
- Olsson, C. et al. (2022). In-context learning and induction heads. Transformer Circuits Thread. arXiv:2209.11895. https://arxiv.org/abs/2209.11895
- Ouyang, L. et al. (2022). Training language models to follow instructions with human feedback. In: NeurIPS 35. arXiv:2203.02155. https://arxiv.org/abs/2203.02155
- Pope, R.; Douglas, S.; Chowdhery, A.; Devlin, J.; Bradbury, J.; Levskaya, A.; Heek, J.; Xiao, K.; Agrawal, S.; Dean, J. (2023). Efficiently scaling Transformer inference. Proceedings of Machine Learning and Systems, 5 (MLSys 2023). arXiv:2211.05102. https://arxiv.org/abs/2211.05102 [link auditado] [conferido]
- Power, A.; Burda, Y.; Edwards, H.; Babuschkin, I.; Misra, V. (2022). Grokking: Generalization beyond overfitting on small algorithmic datasets. arXiv:2201.02177. https://arxiv.org/abs/2201.02177
- Press, O.; Smith, N. A.; Lewis, M. (2022). Train short, test long: Attention with linear biases enables input length extrapolation. In: ICLR 2022. arXiv:2108.12409. https://arxiv.org/abs/2108.12409
- Press, O.; Wolf, L. (2017). Using the output embedding to improve language models. In: EACL 2017, p. 157–163. arXiv:1608.05859. https://arxiv.org/abs/1608.05859
- Radford, A.; Narasimhan, K.; Salimans, T.; Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI, relatório técnico. https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
- Radford, A.; Wu, J.; Child, R.; Luan, D.; Amodei, D.; Sutskever, I. (2019). Language models are unsupervised multitask learners. OpenAI, relatório técnico. https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- Reif, E.; Yuan, A.; Wattenberg, M.; Viegas, F. B.; Coenen, A.; Pearce, A.; Kim, B. (2019). Visualizing and measuring the geometry of BERT. In: NeurIPS 32, p. 8594–8603. arXiv:1906.02715. https://arxiv.org/abs/1906.02715 [link auditado] [conferido]
- Rumelhart, D. E.; Hinton, G. E.; Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. https://doi.org/10.1038/323533a0
- Schaeffer, R.; Miranda, B.; Koyejo, S. (2023). Are emergent abilities of large language models a mirage? In: NeurIPS 2023 (v. 36). arXiv:2304.15004. https://arxiv.org/abs/2304.15004 [link auditado] [conferido]
- Schuster, M.; Nakajima, K. (2012). Japanese and Korean voice search. In: ICASSP 2012, p. 5149–5152. https://doi.org/10.1109/ICASSP.2012.6289079
- Sennrich, R.; Haddow, B.; Birch, A. (2016). Neural machine translation of rare words with subword units. In: ACL 2016, p. 1715–1725. arXiv:1508.07909. https://arxiv.org/abs/1508.07909
- Shaw, P.; Uszkoreit, J.; Vaswani, A. (2018). Self-attention with relative position representations. In: NAACL-HLT 2018, p. 464–468. arXiv:1803.02155. https://arxiv.org/abs/1803.02155
- Shazeer, N. (2019). Fast Transformer decoding: One write-head is all you need. arXiv:1911.02150. https://arxiv.org/abs/1911.02150
- Shazeer, N. (2020). GLU variants improve Transformer. arXiv:2002.05202. https://arxiv.org/abs/2002.05202
- Silva, Aridio. (2026a). SGAEIA: Secure Governed Autonomous Edge Intelligence Architecture (Version 0.3.4). Zenodo. https://doi.org/10.5281/zenodo.22557796
- Silva, Aridio. (2026b). SGAEIA: A Reference Architecture for Secure Governed Autonomous Edge Intelligence. SGAEIA Research Series, Article 8. Zenodo. https://doi.org/10.5281/zenodo.22882020
- Silva, Aridio. (2026c). From Model Capability to Governed Action: An Architecture for Secure Agentic AI. SGAEIA Research Series, Article 11. Zenodo. https://doi.org/10.5281/zenodo.22837908
- Silva, Aridio. (2026d). AI's Alien Mind. SGAEIA Research Series, Article 14. Zenodo. https://doi.org/10.5281/zenodo.22964672
- Silva, Aridio. (2026e). Tracing AI Agent Execution: Foundations, State of the Art, and Implications for Distributed Multi-Agent Systems. SGAEIA Research Series, Article 18. Zenodo. https://doi.org/10.5281/zenodo.23284753
- Su, J.; Lu, Y.; Pan, S.; Murtadha, A.; Wen, B.; Liu, Y. (2021). RoFormer: Enhanced Transformer with rotary position embedding. arXiv:2104.09864. https://arxiv.org/abs/2104.09864
- Tenney, I.; Das, D.; Pavlick, E. (2019). BERT rediscovers the classical NLP pipeline. In: ACL 2019, p. 4593–4601. arXiv:1905.05950. https://aclanthology.org/P19-1452/ [link auditado] [conferido]
- Touvron, H. et al. (2023). LLaMA: Open and efficient foundation language models. arXiv:2302.13971. https://arxiv.org/abs/2302.13971
- Vaswani, A.; Shazeer, N.; Parmar, N.; Uszkoreit, J.; Jones, L.; Gomez, A. N.; Kaiser, Ł.; Polosukhin, I. (2017). Attention is all you need. In: Advances in Neural Information Processing Systems 30 (NIPS 2017), p. 5998–6008. arXiv:1706.03762. https://papers.neurips.cc/paper/7181-attention-is-all-you-need [link auditado] [conferido]
- Vig, J. (2019). A multiscale visualization of attention in the Transformer model. In: ACL 2019 (System Demonstrations), p. 37–42. arXiv:1906.05714. https://arxiv.org/abs/1906.05714
- Voita, E.; Talbot, D.; Moiseev, F.; Sennrich, R.; Titov, I. (2019). Analyzing multi-head self-attention: Specialized heads do the heavy lifting, the rest can be pruned. In: ACL 2019, p. 5797–5808. arXiv:1905.09418. https://arxiv.org/abs/1905.09418
- Wei, J.; Tay, Y.; Bommasani, R. et al. (2022a). Emergent abilities of large language models. Transactions on Machine Learning Research. arXiv:2206.07682. https://arxiv.org/abs/2206.07682 [link auditado] [conferido]
- Wei, J.; Wang, X.; Schuurmans, D. et al. (2022b). Chain-of-thought prompting elicits reasoning in large language models. In: NeurIPS 35. arXiv:2201.11903. https://arxiv.org/abs/2201.11903
- Wiegreffe, S.; Pinter, Y. (2019). Attention is not not explanation. In: EMNLP-IJCNLP 2019, p. 11–20. arXiv:1908.04626. https://arxiv.org/abs/1908.04626
- Wu, Y. et al. (2016). Google's neural machine translation system: Bridging the gap between human and machine translation. arXiv:1609.08144. https://arxiv.org/abs/1609.08144
- Xiong, R. et al. (2020). On layer normalization in the Transformer architecture. In: ICML 2020 (PMLR 119). arXiv:2002.04745. https://arxiv.org/abs/2002.04745
- Zhang, B.; Sennrich, R. (2019). Root mean square layer normalization. In: NeurIPS 32. arXiv:1910.07467. https://arxiv.org/abs/1910.07467
Reprodutibilidade. Os exemplos numéricos das seções 3 a 12 foram calculados em Python 3 com NumPy; W1, W2 e W_out foram gerados com semente aleatória fixa (0) e distribuição normal de desvio-padrão 0,5 (W1, W2) e 0,8 (W_out). Os programas estão reproduzidos na seção 19; as contagens de parâmetros das seções 6 e 8 são aritmética direta, sem script.
19. Códigos-fonte (Python)
Função desta seção. Torna reproduzíveis os números, as figuras e os arquivos auxiliares do documento. É necessária porque os exemplos numéricos só têm valor didático se o leitor puder reexecutá-los e obter os mesmos resultados.
Os programas abaixo estão reproduzidos como foram executados. Ordem de execução: 19.1, depois 19.2 (que lê o arquivo gravado por 19.1); os códigos 19.3 e 19.4 podem ser executados em seguida; 19.5 usa os arquivos de 19.1 e 19.2. Dependências: Python 3, NumPy, Matplotlib e requests. Os cálculos de 19.1 a 19.4 foram reexecutados do zero antes desta publicação e reproduziram os valores citados nas seções 4 a 7, 11 e 12. Conforme a política editorial desta edição, rotinas exclusivamente destinadas a gravar metadados em PNG ou PDF não integram o documento.
Não estão reproduzidos: (a) as contagens de parâmetros das seções 6 e 8, que são aritmética direta e foram feitas sem script; (b) as ferramentas de edição usadas para inserir texto e links no documento; (c) os comandos de conversão com pandoc e XeLaTeX.
| Item | O que realiza | Alimenta |
|---|---|---|
| 19.1 | Embeddings, posição, Q/K/V, atenção, máscara, LayerNorm, FFN e saída | Seções 4 a 6; Figuras 2 e 4 |
| 19.2 | Cadeia causal, logits, temperatura e desambiguação | Seções 7, 8, 10 a 12; Figura 6 |
| 19.3 | Fusões do BPE | Seção 3 |
| 19.4 | Conferência de LayerNorm e RMSNorm | Seção 7 |
| 19.5 | Figuras 1 a 6 | Figuras do documento |
| 19.6 | CSV de links da bibliografia | Código 19.7 |
| 19.7 | Auditoria HTTP dos links | Seção 18 |
19.1 Núcleo numérico do exemplo didático
Arquivo: 01_nucleo_numerico_calc.py. O que realiza. Define os quatro tokens ("O", "banco", "estava", "lotado") com embeddings de 4 dimensões escolhidos à mão; calcula a codificação posicional senoidal e a entrada X = E + P; aplica as projeções Q, K e V (matrizes fixas, d_k = 2), os scores QKᵀ, a divisão por √d_k e o softmax (atenção bidirecional), e repete o softmax com máscara causal. Em seguida percorre o resto do bloco (projeção Wo, soma residual, LayerNorm, RMSNorm, FFN com d_ff = 8 e pesos aleatórios de semente 0, logits sobre cinco palavras, softmax com T = 0,5, 1 e 2, e ordenação para top-p) e grava tudo em toy.npz.
Alimenta. Números das seções 4, 5 e 6 e Figuras 2 e 4. Os resultados de FFN e de saída produzidos aqui (cadeia bidirecional) não são os usados no texto; os das seções 7 a 11 vêm do código 19.2, que refaz a cadeia com a máscara causal.
import numpy as np, json
np.set_printoptions(precision=3, suppress=True)
tok=["O","banco","estava","lotado"]
# Embeddings didáticos d_model=4
E=np.array([[1.0,0.0,0.0,0.0],
            [0.0,1.0,0.5,0.0],
            [0.0,0.3,1.0,0.0],
            [0.0,0.8,0.0,1.0]])
d=4
def pe(n,d):
    P=np.zeros((n,d))
    for pos in range(n):
        for i in range(0,d,2):
            P[pos,i]=np.sin(pos/10000**(i/d)); P[pos,i+1]=np.cos(pos/10000**(i/d))
    return P
P=pe(4,d); print("PE\n",P)
X=E+P; print("X\n",X)
Wq=np.array([[1,0],[0,1],[1,0],[0,1]],float)*0.9
Wk=np.array([[0.5,0.2],[1,0],[0,1],[0.3,0.8]],float)
Wv=np.array([[1,0],[0,1],[0.5,0],[0,0.5]],float)
Q=X@Wq;K=X@Wk;V=X@Wv
print("Q\n",Q,"\nK\n",K,"\nV\n",V)
S=Q@K.T; print("S\n",S)
dk=2; Ss=S/np.sqrt(dk); print("S/sqrt\n",Ss)
def sm(z): z=z-z.max(-1,keepdims=True); e=np.exp(z); return e/e.sum(-1,keepdims=True)
A=sm(Ss); print("A\n",A, A.sum(1))
Z=A@V; print("Z\n",Z)
# causal
mask=np.triu(np.ones((4,4)),1).astype(bool)
Sc=Ss.copy(); Sc[mask]=-np.inf; Ac=sm(Sc); print("Acausal\n",Ac)
# project back with Wo (2->4)
Wo=np.array([[1,0,0.5,0],[0,1,0,0.5]],float)
O=Z@Wo; print("O\n",O)
R=X+O; print("R\n",R)
def ln(x,eps=1e-5): m=x.mean(-1,keepdims=True); v=x.var(-1,keepdims=True); return (x-m)/np.sqrt(v+eps)
Y=ln(R); print("LN\n",Y)
# rms
rms=R/np.sqrt((R**2).mean(-1,keepdims=True)+1e-5); print("RMS\n",rms)
# FFN d_ff=8 ReLU
rng=np.random.default_rng(0)
W1=rng.normal(0,0.5,(4,8)); b1=np.zeros(8); W2=rng.normal(0,0.5,(8,4)); b2=np.zeros(4)
H=np.maximum(0,Y@W1+b1); F=H@W2+b2
print("W1\n",W1,"\nW2\n",W2)
print("H\n",H,"\nF\n",F)
Y2=ln(Y+F); print("Y2\n",Y2)
# output: vocab
vocab=["lotado","vazio","cheio","aberto","verde"]
Wout=rng.normal(0,0.8,(4,5))
lg=Y2[2]@Wout  # posição de "estava" prevê próxima palavra
print("Wout\n",Wout,"\nlogits",lg)
p=sm(lg); print("p",p, p.sum())
for T in [0.5,1.0,2.0]:
    print(T, sm(lg/T))
tgt=0; print("CE",-np.log(p[tgt]))
# top-p
order=np.argsort(-p); cs=np.cumsum(p[order]); print([vocab[i] for i in order],cs)
np.savez("toy.npz",E=E,P=P,X=X,Q=Q,K=K,V=V,S=S,Ss=Ss,A=A,Ac=Ac,Z=Z,O=O,R=R,Y=Y,H=H,F=F,Y2=Y2,lg=lg,p=p)
19.2 Cadeia causal, saída e desambiguação de "banco"
Arquivo: 02_cadeia_causal_e_desambiguacao_calc2.py. O que realiza. Lê toy.npz e refaz a cadeia a partir da atenção causal: saída da atenção (Zc, Oc), soma residual (Rc), LayerNorm (Yc), FFN, logits da posição "estava", softmax com temperatura, entropia cruzada e ordenação para top-k e top-p; grava toy2.npz. Depois executa a demonstração da seção 12: embeddings de quatro eixos (dinheiro, assento, pessoas, madeira), atenção de uma cabeça com Wq = Wk = 2·I, Wv = I e d_k = 4, e similaridade de cosseno entre o vetor contextualizado de "banco" e dois protótipos de sentido.
Alimenta. Seções 7, 8, 10, 11 e 12 e Figura 6. Observação: o gradiente p − y (seção 10) e as renormalizações de top-k e top-p (seção 11) foram calculados à mão a partir das probabilidades impressas por este programa, não por código. Requer toy.npz (19.1).
import numpy as np
np.set_printoptions(precision=3, suppress=True)
d=np.load("toy.npz");
def sm(z): z=z-z.max(-1,keepdims=True); e=np.exp(z); return e/e.sum(-1,keepdims=True)
def ln(x,eps=1e-5): m=x.mean(-1,keepdims=True); v=x.var(-1,keepdims=True); return (x-m)/np.sqrt(v+eps)
X,V,Ac=d["X"],d["V"],d["Ac"]
Wo=np.array([[1,0,0.5,0],[0,1,0,0.5]],float)
Zc=Ac@V; Oc=Zc@Wo; Rc=X+Oc; Yc=ln(Rc)
print("Zc\n",Zc,"\nOc\n",Oc,"\nRc\n",Rc,"\nYc\n",Yc)
rng=np.random.default_rng(0)
W1=rng.normal(0,0.5,(4,8)); W2=rng.normal(0,0.5,(8,4))
H=np.maximum(0,Yc@W1); F=H@W2; Y2=ln(Yc+F)
print("H\n",H,"\nF\n",F,"\nY2\n",Y2)
Wout=rng.normal(0,0.8,(4,5)); vocab=["lotado","vazio","cheio","aberto","verde"]
lg=Y2[2]@Wout; p=sm(lg)
print("Wout\n",Wout,"\nlg",lg,"\np",p)
for T in [0.5,1,2]: print(T,sm(lg/T))
print("CE lotado",-np.log(p[0]),"CE cheio",-np.log(p[2]))
o=np.argsort(-p); print([vocab[i] for i in o], np.cumsum(p[o]))
np.savez("toy2.npz",Zc=Zc,Oc=Oc,Rc=Rc,Yc=Yc,H=H,F=F,Y2=Y2,Wout=Wout,lg=lg,p=p,W1=W1,W2=W2)
# desambiguação
feat=["dinheiro","assento","pessoas","madeira"]
emb={"O":[0,0,0,0],"banco":[.7,.7,0,0],"estava":[0,0,.1,0],"lotado":[0,0,1,0],
"de":[0,0,0,0],"clientes":[.8,0,.7,0],"da":[0,0,0,0],"praça":[0,.8,0,.2],"madeira":[0,.3,0,1],"velho":[0,.2,0,.5],"gerente":[.9,0,.3,0],"fila":[.5,0,.9,0]}
def ctx(words, scale=2.0):
    Em=np.array([emb[w] for w in words],float)
    # Q=K=E*scale + vetor de sentinela p/ evitar nulos
    Q=K=Em*scale
    S=Q@K.T/np.sqrt(4)
    bi=words.index("banco")
    S[bi,:]+=0  # sem alteração
    A=sm(S)
    Z=A@Em
    return A[bi],Z[bi]
protoF=np.array([1,0,.5,0]);protoP=np.array([0,1,0,.5])
cos=lambda a,b:a@b/np.linalg.norm(a)/np.linalg.norm(b)
for name,w in [("fin",["O","banco","estava","lotado","de","clientes"]),("praca",["O","banco","da","praça","estava","velho","madeira"]),("isolado",["banco"])]:
    a,z=ctx(w); print(name,w,a,z,"cosFin",cos(z,protoF),"cosPraca",cos(z,protoP))
19.3 Fusões do BPE em corpus didático
Arquivo: 03_bpe_didatico.py. O que realiza. Executa 8 passos do algoritmo BPE sobre o corpus low (5), lower (2), newest (6) e widest (3), com o marcador </w> de fim de palavra. Em cada passo imprime o par fundido, sua frequência, os três pares mais frequentes e o vocabulário resultante. Os empates são resolvidos pela ordem de ocorrência.
Alimenta. Tabela de fusões da seção 3.
import re, collections
vocab={"l o w </w>":5,"l o w e r </w>":2,"n e w e s t </w>":6,"w i d e s t </w>":3}
def stats(v):
    p=collections.Counter()
    for w,f in v.items():
        s=w.split()
        for a,b in zip(s,s[1:]): p[(a,b)]+=f
    return p
def merge(pair,v):
    out={}
    bg=re.escape(" ".join(pair)); pat=re.compile(r'(?<!\S)'+bg+r'(?!\S)')
    for w,f in v.items(): out[pat.sub("".join(pair),w)]=f
    return out
for i in range(8):
    p=stats(vocab); best=max(p,key=lambda k:(p[k],))
    top=p.most_common(3)
    print(i+1,best,p[best],top[:3]); vocab=merge(best,vocab); print("  ",vocab)
19.4 Conferência da LayerNorm e da RMSNorm para "banco"
Arquivo: 04_verificar_ln_rms.py. O que realiza. Recalcula, para o token "banco" (posição 1, versão causal), a média, a variância, a LayerNorm e a RMSNorm do vetor da soma residual, e confere que a LayerNorm resulta em média 0 e variância 1.
Alimenta. Exemplo numérico da seção 7. Requer toy.npz e toy2.npz (19.1 e 19.2).
import numpy as np
d=np.load("toy2.npz"); R=d["Rc"]; r=R[1]
print("R",r,"mean",r.mean(),"var",r.var(),"std",np.sqrt(r.var()+1e-5))
print("LN",(r-r.mean())/np.sqrt(r.var()+1e-5))
print("RMS",np.sqrt((r**2).mean()+1e-5), r/np.sqrt((r**2).mean()+1e-5))
X=np.load("toy.npz")["X"]; print("X1",X[1],"O1",d["Oc"][1])
print(d["Yc"][1].mean(), d["Yc"][1].var())
19.5 Geração das Figuras 1 a 6
Arquivo: 05_figuras.py. O que realiza. Desenha com Matplotlib o diagrama de fluxo (Figura 1), os mapas de calor de E, P e X (Figura 2), o diagrama do mecanismo Q/K/V (Figura 3), os mapas de atenção bidirecional e causal (Figura 4), o esquema de especialização por camadas (Figura 5) e as barras de probabilidade por temperatura (Figura 6). Lê toy.npz e toy2.npz e grava na pasta fig/, que deve existir antes da execução.
Alimenta. Figuras do documento. O programa salva com nomes internos (fig2_embedding.png, fig4_qkv.png, fig3_atencao.png, fig6_saida.png), renomeados na entrega para fig2_embeddings.png, fig3_mecanismo.png, fig4_mapas_atencao.png e fig6_temperatura.png; os títulos dentro das imagens já trazem a numeração final.
import numpy as np, matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch
plt.rcParams.update({"font.family":"DejaVu Sans","font.size":10})
CR="© 2026 Aridio Silva – Pesquisador Independente · ORCID 0009-0008-2411-6995"
d=np.load("toy.npz"); d2=np.load("toy2.npz")
tok=["O","banco","estava","lotado"]
C={"in":"#dbe9f6","tok":"#e3f1df","emb":"#fdf0d5","att":"#f9dcdc","ffn":"#e8e0f4","out":"#d9f0ee","gray":"#f0f0f0"}
def foot(fig): fig.text(0.5,0.01,CR,ha="center",fontsize=7.5,color="#666")
def box(ax,x,y,w,h,txt,fc,fs=9,bold=False):
    ax.add_patch(FancyBboxPatch((x,y),w,h,boxstyle="round,pad=0.02,rounding_size=0.08",fc=fc,ec="#444",lw=1))
    ax.text(x+w/2,y+h/2,txt,ha="center",va="center",fontsize=fs,fontweight="bold" if bold else "normal",wrap=True)
def arrow(ax,x1,y1,x2,y2):
    ax.add_patch(FancyArrowPatch((x1,y1),(x2,y2),arrowstyle="-|>",mutation_scale=12,color="#333",lw=1.2))

# FIG 1 fluxo
fig,ax=plt.subplots(figsize=(9,11)); ax.set_xlim(0,10); ax.set_ylim(0,14.2); ax.axis("off")
box(ax,2,12.9,6,0.9,"1. TEXTO DE ENTRADA\n\"O banco estava lotado\"",C["in"],bold=True)
box(ax,2,11.3,6,0.9,"2. TOKENIZAÇÃO (BPE / SentencePiece)\n[O] [banco] [estava] [lotado] → IDs inteiros",C["tok"],bold=True)
box(ax,2,9.8,6,0.9,"3. EMBEDDING + CODIFICAÇÃO POSICIONAL\nmatriz X ∈ ℝ^(n × d_model)",C["emb"],bold=True)
ax.add_patch(FancyBboxPatch((1.1,3.9),7.8,5.4,boxstyle="round,pad=0.02,rounding_size=0.1",fc="#fafafa",ec="#222",lw=1.6,ls="--"))
ax.text(5,8.95,"4. BLOCO TRANSFORMER  ×  N camadas (pesos próprios por camada)",ha="center",fontsize=9.5,fontweight="bold")
box(ax,2.3,7.65,5.6,0.8,"Self-Attention multi-cabeça\n(Q, K, V = X·Wq, X·Wk, X·Wv)",C["att"],fs=8.8)
box(ax,2.3,6.55,5.6,0.6,"Add & Norm (residual + normalização)",C["gray"],fs=8.8)
box(ax,2.3,5.3,5.6,0.8,"Rede Feed-Forward (FFN) por posição",C["ffn"],fs=8.8)
box(ax,2.3,4.2,5.6,0.6,"Add & Norm (residual + normalização)",C["gray"],fs=8.8)
arrow(ax,5,12.9,5,12.2);arrow(ax,5,11.3,5,10.7);arrow(ax,5,9.8,5,9.3)
arrow(ax,5,7.65,5,7.15);arrow(ax,5,6.55,5,6.1);arrow(ax,5,5.3,5,4.8)
for (ya,yb) in [(8.6,6.85),(6.35,4.5)]:
    ax.plot([1.6,1.6],[ya,yb],color="#c0392b",lw=1.4)
    ax.plot([1.6,2.3],[ya,ya],color="#c0392b",lw=1.4)
    ax.add_patch(FancyArrowPatch((1.6,yb),(2.3,yb),arrowstyle="-|>",mutation_scale=11,color="#c0392b",lw=1.4))
ax.text(1.45,7.3,"conexão\nresidual",rotation=90,fontsize=7.5,color="#c0392b",ha="right",va="center")
ax.text(1.45,5.4,"conexão\nresidual",rotation=90,fontsize=7.5,color="#c0392b",ha="right",va="center")
box(ax,2,2.5,6,0.9,"5. PROJEÇÃO PARA O VOCABULÁRIO → LOGITS\nh_final · W_out  (um valor por token do vocabulário)",C["out"],bold=True,fs=8.8)
box(ax,2,1.2,6,0.9,"6. SOFTMAX (com temperatura T) → PROBABILIDADES\nP(próximo token | contexto)",C["out"],bold=True,fs=8.8)
box(ax,2,-0.1,6,0.9,"7. DECODIFICAÇÃO (guloso, top-k, top-p, amostragem)\n→ token de saída (anexado à entrada; o ciclo se repete)",C["out"],bold=True,fs=8.8)
arrow(ax,5,3.9,5,3.4);arrow(ax,5,2.5,5,2.1);arrow(ax,5,1.2,5,0.8)
ax.set_ylim(-0.6,14.2)
ax.set_title("Figura 1 – Fluxo completo da inferência em um Transformer (visão geral)",fontsize=11,fontweight="bold",loc="left")
foot(fig); fig.savefig("fig/fig1_fluxo.png",dpi=170,bbox_inches="tight"); plt.close()

# FIG 2 embeddings + PE
fig,axs=plt.subplots(1,3,figsize=(11,3.6))
for a,M,t in zip(axs,[d["E"],d["P"],d["X"]],["E: embeddings didáticos (n=4, d=4)","P: codificação posicional senoidal","X = E + P (entrada da camada 1)"]):
    im=a.imshow(M,cmap="RdBu_r",vmin=-2,vmax=2)
    a.set_xticks(range(4));a.set_xticklabels([f"d{i+1}" for i in range(4)])
    a.set_yticks(range(4));a.set_yticklabels([f"{i}: {t_}" for i,t_ in enumerate(tok)])
    for i in range(4):
        for j in range(4): a.text(j,i,f"{M[i,j]:.2f}",ha="center",va="center",fontsize=8.5,color="white" if abs(M[i,j])>1.3 else "black")
    a.set_title(t,fontsize=9)
fig.suptitle("Figura 2 – Etapa 2: embeddings e codificação posicional (valores calculados; pesos didáticos)",fontsize=10.5,fontweight="bold",x=0.01,ha="left")
fig.tight_layout(rect=[0,0.08,1,0.93]); foot(fig); fig.savefig("fig/fig2_embedding.png",dpi=170); plt.close()

# FIG 3 atenção
fig,axs=plt.subplots(1,2,figsize=(10.5,4.4))
for a,M,t in zip(axs,[d["A"],d["Ac"]],["Atenção bidirecional (estilo codificador)","Atenção causal (estilo decodificador)"]):
    im=a.imshow(M,cmap="YlOrBr",vmin=0,vmax=1)
    a.set_xticks(range(4));a.set_xticklabels(tok);a.set_yticks(range(4));a.set_yticklabels(tok)
    a.set_xlabel("Key (para quem olha)");a.set_ylabel("Query (quem pergunta)")
    for i in range(4):
        for j in range(4):
            a.text(j,i,f"{M[i,j]:.2f}",ha="center",va="center",fontsize=10,color="black" if M[i,j]<0.6 else "white")
    a.set_title(t,fontsize=10)
fig.suptitle("Figura 4 – Mapa de atenção softmax(QKᵀ/√d_k): cada linha soma 1,00",fontsize=11,fontweight="bold",x=0.01,ha="left")
fig.tight_layout(rect=[0,0.04,1,0.92]); foot(fig); fig.savefig("fig/fig3_atencao.png",dpi=170); plt.close()

# FIG 4 mecanismo QKV
fig,ax=plt.subplots(figsize=(10,4.6)); ax.set_xlim(0,12); ax.set_ylim(0,6); ax.axis("off")
box(ax,0.1,2.4,1.5,1.2,"X\n(n × d_model)",C["emb"],bold=True)
for k,(lab,y) in enumerate([("Q = X·Wq",4.3),("K = X·Wk",2.5),("V = X·Wv",0.7)]):
    box(ax,2.4,y,1.8,0.9,lab,C["att"] if k<2 else C["ffn"],bold=True); arrow(ax,1.6,3.0,2.4,y+0.45)
box(ax,5.3,3.4,2.1,1.0,"Scores\nS = Q·Kᵀ / √d_k",C["gray"],fs=9); arrow(ax,4.2,4.75,5.3,4.0);arrow(ax,4.2,2.95,5.3,3.7)
box(ax,5.3,1.9,2.1,0.9,"(máscara causal\nopcional: −∞)",C["gray"],fs=8.5); arrow(ax,6.35,2.8,6.35,3.4)
box(ax,8.2,3.4,1.5,1.0,"A = softmax(S)\nlinhas somam 1",C["out"],fs=8.5); arrow(ax,7.4,3.9,8.2,3.9)
box(ax,8.2,1.0,1.5,1.0,"Z = A·V",C["out"],bold=True); arrow(ax,8.95,3.4,8.95,2.0); arrow(ax,4.2,1.15,8.2,1.4)
box(ax,10.2,1.0,1.7,1.0,"Z·Wo\n(saída da\ncamada)",C["emb"],fs=8.5); arrow(ax,9.7,1.5,10.3,1.5)
ax.set_title("Figura 3 – Mecanismo de atenção por produto escalar escalonado (Vaswani et al., 2017)",fontsize=11,fontweight="bold",loc="left")
foot(fig); fig.savefig("fig/fig4_qkv.png",dpi=170,bbox_inches="tight"); plt.close()

# FIG 5 camadas (esquema conceitual)
fig,ax=plt.subplots(figsize=(9,5.6)); ax.set_xlim(0,10); ax.set_ylim(0,10); ax.axis("off")
L=[("Camadas finais (ex.: 9–12 em modelo de 12)","Representações próximas da tarefa de saída;\ncombinação de informação global; preparação do logit",C["out"],0.5),
   ("Camadas intermediárias (ex.: 4–8)","Semântica lexical e contextual; desambiguação de sentido;\nrelações entre palavras e entidades",C["att"],3.4),
   ("Camadas iniciais (ex.: 1–3)","Padrões superficiais e sintáticos locais;\nvizinhança, posição, classe gramatical",C["in"],6.3)]
for t,s,c,y in L:
    box(ax,1.2,y,7.6,2.4,"",c); ax.text(5,y+1.75,t,ha="center",fontsize=10.5,fontweight="bold"); ax.text(5,y+0.8,s,ha="center",fontsize=9.3)
arrow(ax,0.6,6.3,0.6,2.9); ax.text(0.45,4.6,"profundidade",rotation=90,va="center",ha="right",fontsize=8.5)
ax.text(5,9.3,"Esquema conceitual: tendência observada em estudos de sondagem em BERT\n(Tenney et al., 2019); as fronteiras entre camadas NÃO são exatas.",ha="center",fontsize=8.6,style="italic",color="#444")
ax.set_title("Figura 5 – Especialização aproximada por profundidade em Transformers empilhados",fontsize=11,fontweight="bold",loc="left")
foot(fig); fig.savefig("fig/fig5_camadas.png",dpi=170,bbox_inches="tight"); plt.close()

# FIG 6 saída
vocab=["lotado","vazio","cheio","aberto","verde"]
lg=d2["lg"]
def sm(z): e=np.exp(z-z.max()); return e/e.sum()
fig,axs=plt.subplots(1,3,figsize=(11,3.6),sharey=True)
for a,T in zip(axs,[0.5,1.0,2.0]):
    p=sm(lg/T); a.bar(vocab,p,color="#4a90a4"); a.set_title(f"T = {T}",fontsize=10); a.set_ylim(0,1)
    for i,v in enumerate(p): a.text(i,v+0.02,f"{v:.3f}",ha="center",fontsize=8.5)
    a.tick_params(axis="x",labelrotation=30)
axs[0].set_ylabel("Probabilidade")
fig.suptitle("Figura 6 – Efeito da temperatura sobre softmax(logits/T) (logits calculados; pesos de saída aleatórios)",fontsize=10.5,fontweight="bold",x=0.01,ha="left")
fig.tight_layout(rect=[0,0.05,1,0.92]); foot(fig); fig.savefig("fig/fig6_saida.png",dpi=170); plt.close()
19.6 Extração dos links da bibliografia
Arquivo: 07_gerar_csv_links.py. O que realiza. Lê a seção 18 do arquivo Markdown e gera links_bibliografia.csv com autor, ano, título esperado, URL e situação da auditoria de cada entrada.
Alimenta. Entrada do código 19.7.
import re,csv
s=open("abrindo-a-caixa-preta-da-inferencia-em-llms.md",encoding="utf-8").read()
# delimita a seção 18 antes do apêndice de códigos
ref=s.split("## 18. Referências bibliográficas")[1].split("## 19.")[0]
items=[l[2:] for l in ref.splitlines() if l.startswith("- ")]
rows=[]
for it in items:
    cite=it.split("(")[0].strip().rstrip(",;. ")
    yr=re.search(r"\((\d{4}[ab]?)\)\.\s+(.*)",it)
    rest=yr.group(2)
    m=re.match(r"(.*?[?!])\s|(.*?)\.\s",rest)
    titulo=(m.group(1) or m.group(2)) if m else rest[:80]
    urls=re.findall(r"<(https?://[^>]+)>",it)
    aud="link auditado" in it
    rows.append([len(rows)+1,cite.split(";")[0]+(" et al." if ";" in cite else ""),yr.group(1),titulo,urls[0],"auditado (busca)" if aud else "nao auditado"])
with open("links_bibliografia.csv","w",newline="",encoding="utf-8-sig") as f:
    w=csv.writer(f); w.writerow(["n","autor","ano","titulo_esperado","url","status_auditoria_20261020"]); w.writerows(rows)
19.7 Auditoria dos links por requisição HTTP
Arquivo: 08_auditar_links.py. O que realiza. Abre cada URL do CSV, registra o código HTTP e a URL final, extrai o título da página e o compara com o título esperado, classificando cada entrada como OK ou REVISAR. Requer a biblioteca requests e acesso à internet. Foi testado apenas contra um servidor local, e não contra os sites reais.
Alimenta. Arquivo auditoria_links_resultado.csv, a ser gerado pelo leitor (seção 18).
#!/usr/bin/env python3
"""Audita os links da bibliografia: abre cada URL, registra o código HTTP, a URL final
e compara o <title> da página com o título esperado. Uso: python3 auditar_links.py
Requer: pip install requests. Saída: auditoria_links_resultado.csv"""
import csv, re, sys, time, difflib, html
import requests

H = {"User-Agent": "Mozilla/5.0 (auditoria-bibliografia; contato: ORCID 0009-0008-2411-6995)"}

def norm(t):
    return re.sub(r"[^a-z0-9 ]", "", html.unescape(t).lower())

def titulo(txt):
    m = re.search(r"<title[^>]*>(.*?)</title>", txt, re.S | re.I)
    return re.sub(r"\s+", " ", m.group(1)).strip() if m else ""

rows = list(csv.DictReader(open("links_bibliografia.csv", encoding="utf-8-sig")))
out = []
for r in rows:
    url, esp = r["url"], r["titulo_esperado"]
    try:
        resp = requests.get(url, headers=H, timeout=25, allow_redirects=True)
        t = titulo(resp.text) if "html" in resp.headers.get("content-type", "") else ""
        sim = difflib.SequenceMatcher(None, norm(esp), norm(t)).ratio() if t else 0.0
        contem = norm(esp)[:40] in norm(t) if t else False
        # PDFs não têm <title>: apenas o status é verificável automaticamente
        ok = resp.status_code == 200 and (contem or sim >= 0.6 or not t)
        res = [r["n"], r["autor"], url, resp.status_code, resp.url, t[:90], round(sim, 2),
               "OK" if ok else "REVISAR (conferir título manualmente)"]
    except Exception as e:
        res = [r["n"], r["autor"], url, "erro", "", str(e)[:90], 0, "REVISAR (falha de acesso)"]
    out.append(res); print(res[0], res[3], res[7], url)
    time.sleep(1.0)
with open("auditoria_links_resultado.csv", "w", newline="", encoding="utf-8-sig") as f:
    w = csv.writer(f)
    w.writerow(["n", "autor", "url", "http", "url_final", "titulo_da_pagina", "similaridade", "resultado"])
    w.writerows(out)
print("\nConcluído:", sum(1 for o in out if o[7] == "OK"), "OK de", len(out))
Sobre o autor
Aridio Silva é pesquisador independente no Brasil, dedicado à arquitetura, segurança, governança e confiabilidade de sistemas de inteligência artificial autônomos e distribuídos.
Sua pesquisa concentra-se em Agentic AI, Multi-Agent Systems, Edge AI, AI Security, Zero Trust, Security-by-Design, AI Governance, Spec-Driven Development e continuous security assurance.
É criador e pesquisador responsável pelo SGAEIA — Secure Governed Autonomous Edge Intelligence Architecture, iniciativa de pesquisa que investiga fundamentos arquiteturais para sistemas autônomos de AI seguros, governados, auditáveis e confiáveis em ambientes distribuídos de edge e cloud.
Recursos de pesquisa e do projeto
- ORCID: https://orcid.org/0009-0008-2411-6995
- Google Scholar: https://scholar.google.com/citations?user=rPn5O48AAAAJ
- Zenodo — SGAEIA Community: https://zenodo.org/communities/sgaeia
- OpenAIRE: https://explore.openaire.eu/search/find?fv0=Aridio%20Silva&f0=q
- Medium: https://medium.com/@aridiosilva
- DEV Community: https://dev.to/aridiosilva
- GitHub: https://github.com/aridiosilva
- LinkedIn: https://www.linkedin.com/in/aridio-silva-74997111/
- SGAEIA — DOI canônico do projeto: https://doi.org/10.5281/zenodo.22557796
- Homepage: https://aridiosilva.com
- SGAEIA Homepage: https://aridiosilva.com/sgaeia
- SGAEIA LinkedIn: https://www.linkedin.com/company/sgaeia/
Figuras
A capa não é numerada. As Figuras 1–6 são ilustrações técnicas e didáticas públicas. Seus números e pesos são explicitamente identificados como exemplos reduzidos; eles não representam medições de um modelo treinado nem revelam protocolos, algoritmos, máquinas de estado, políticas internas, limiares ou mecanismos privados do SGAEIA. As imagens finais incluem crédito visível e devem preservar metadados de criador, copyright, projeto, título, descrição e licença.
Licença
Exceto quando indicado de outro modo, o texto, os exemplos e as ilustrações originais deste artigo são licenciados sob a Creative Commons Attribution 4.0 International (CC BY 4.0).
© 2026 Aridio Silva. É permitido compartilhar e adaptar esta obra para qualquer finalidade, desde que seja atribuída a autoria adequada.
O artefato de software e pesquisa do SGAEIA permanece sujeito à sua própria licença Apache 2.0.
Autonomous AI. Governed by Design. Trusted by Evidence.
Continuidade da série
Este trabalho é o SGAEIA Research Series — Article 22. Sua edição de registro está publicada no Zenodo sob o DOI 10.5281/zenodo.23540392. As edições em português e inglês compartilham o mesmo registro bibliográfico e distinguem-se pelo idioma indicado no arquivo e nos metadados.
Citação sugerida
Silva, Aridio. (2026). Abrindo a Caixa-Preta da Inferência em LLMs: Fundamentos de AI Generativa — Anatomia do Transformer por Dentro, da Entrada ao Token de Saída. SGAEIA Research Series, Article 22. Zenodo. https://doi.org/10.5281/zenodo.23540392
© 2026 Aridio Silva | Project SGAEIA | CC BY 4.0
ORCID 0009-0008-2411-6995 | DOI 10.5281/zenodo.23540392